Resumen:
DeepSeek también se ha unido a la competencia de parámetros. Según The Information, DeepSeek está entrenando actualmente un nuevo modelo con aproximadamente 2 billones de parámetros; Liang Wenfeng también afirmó en una reciente reunión de inversores que el siguiente paso de la empresa es seguir impulsando el modelo hasta los 8 billones de parámetros. Hace un año, 8 billones todavía era una cifra inimaginable.
Pero ahora, Kimi K3 ha alcanzado los 2,8 billones de parámetros; Byte está entrenando previamente un nuevo modelo que puede alcanzar hasta 10 billones de parámetros; Alibaba también ha declarado públicamente que el modelo de próxima generación avanzará hacia parámetros de entre 5 y 10 billones de billones. Anthropic no revela los parámetros del modelo, pero FT ha citado anteriormente estimaciones de la industria que dicen que su último buque insignia, Mythos 5, tiene aproximadamente 8 billones de parámetros.
La modelo grande dio vueltas en círculo y comenzó a competir nuevamente para ver quién era más grande.
Solo que esta vez, los parámetros que todos implementan ya no son los mismos que en la ronda anterior de Escalamiento.
Cuando DeepSeek lanzó V4-Pro en abril de este año, la escala divulgada oficialmente era de 1,6 billones de parámetros totales y 49 mil millones de parámetros de activación.
El plan de seguimiento es de 8 billones de RMB, lo que equivale a 5 veces el de V4-Pro.
En realidad, esto es bastante inusual cuando se trata de DeepSeek. Después de todo, DeepSeek dejó la impresión más profunda en toda la industria de la IA el año pasado, no en términos de parámetros.
Una vez provocó que la industria de la IA volviera a discutir que tal vez los modelos de vanguardia no necesiten grabar GPU infinitamente.
Cuando se lanza V3 a finales de 2024, DeepSeek pone deliberadamente la factura de la capacitación sobre la mesa: 671 mil millones de parámetros totales, 37 mil millones de parámetros activados por token y la capacitación completa consume 2,788 millones de horas de GPU H800. Calculado en 2 dólares por hora de GPU, el coste oficial de formación es de sólo 5,576 millones de dólares.
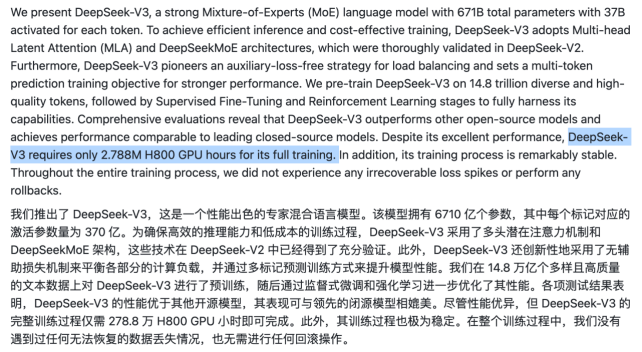
Este número, y la eficiencia detrás de él, se convirtió más tarde en una de las etiquetas más importantes para DeepSeek.
DeepSeek no tiene un suministro abundante de GPU avanzadas como OpenAI y Anthropic; La empresa ha confiado durante mucho tiempo en Huanfang de Liang Wenfeng para cuantificar su autotransfusión y no acepta financiación externa. Sus condiciones determinan su ruta: dado que el dinero y la potencia informática son limitados, el rendimiento debe maximizarse a partir de la arquitectura, la capacitación y la eficiencia de la inferencia.
Pero ahora las condiciones han cambiado.
DeepSeek acaba de completar su primera ronda de financiación externa desde su creación en junio de este año, recaudando aproximadamente 7.400 millones de dólares. Actualmente, la segunda ronda de financiación de aproximadamente 50 mil millones de RMB (aproximadamente 7,5 mil millones de dólares estadounidenses) ha entrado en la etapa de finalización, lo que corresponde a una valoración de aproximadamente 500 mil millones de RMB. Si esta financiación se completa con éxito, la financiación externa acumulada de DeepSeek se acercará a los 15.000 millones de dólares estadounidenses y aproximadamente 100.000 millones de yuanes en unos pocos meses.
Al mismo tiempo, DeepSeek ha contratado a CITIC Securities para prepararse para la oferta pública inicial de la Junta de Innovación Científica y Tecnológica, y el nuevo capital se utilizará claramente para infraestructura informática, desarrollo de modelos e inversión de talento; El 21 de septiembre, Yan Wentao, un ex socio de Hillhouse Venture Partners, se unió oficialmente a DeepSeek y se desempeñó como director financiero, poniendo fin a la vacante de director financiero en los tres años desde que se fundó la empresa.
En el pasado, DeepSeek utilizó dinero y potencia informática limitados para hacer que el modelo fuera lo mejor posible; ahora se está impulsando la financiación y la cotización. Con más dinero disponible, también se puede aumentar la potencia informática.
Una vez que se cumplen las condiciones, DeepSeek también comienza a implementar parámetros audazmente.
Esto no entra en conflicto con la búsqueda de la eficiencia. Cuando la eficiencia es alta, la escala se puede ampliar con el mismo dinero.
En los últimos dos meses, la escala total de parámetros de los modelos de vanguardia ha aumentado significativamente.
El lado oscuro de la luna vuelve a poner esta competencia en el centro de atención. En julio de este año, Kimi K3 alcanzó 2,8 billones de parámetros totales y 104 mil millones de parámetros de activación. El K3 sigue siendo el modelo de peso abierto con la escala de parámetros más grande que se ha lanzado oficialmente.
No es sólo grande. En la evaluación oficial, GPQA Diamond de K3 alcanzó 93,5 y Terminal-Bench 2.1 alcanzó 88,3, lo que está muy cerca de GPT-5.6 Sol y Claude Fable 5 en el mismo período. La escala ha alcanzado los billones y el desempeño ha alcanzado el primer escalón.
En agosto, se reveló que Byte planeaba crecer.
El 6 de agosto, "LatePost" reveló por primera vez que Byte estaba discutiendo el entrenamiento de un nuevo modelo con más de 5 billones de parámetros, dirigido por Xiang Liang, director de la Seed Foundation. Según los informes, Byte parece creer internamente que en lugar de seguir alcanzando el tamaño existente, es mejor impulsar la escala de parámetros varias veces más que la de sus pares a la vez.
Un día después, el 7 de agosto, FT informó, citando a personas familiarizadas con el asunto, que la escala del nuevo modelo que Byte está preentrenando puede alcanzar hasta 10 billones de parámetros; Cuando Reuters hizo un seguimiento, también lo comparó con el innovador Mythos de Anthropic; aunque este último nunca ha revelado la escala de parámetros, las estimaciones de la industria han alcanzado alrededor de 8 billones. Si el nuevo modelo de Byte alcanza las 10T, superará la escala que circula actualmente por Mythos.
Ahora, cantidades de parámetros extremadamente grandes, de más de 5T, han comenzado a aparecer repetidamente en las discusiones sobre modelos de vanguardia.
Hoy, el director ejecutivo de Alibaba, Wu Yongming, anunció públicamente que el modelo de próxima generación planea alcanzar entre 5 y 10 billones de parámetros; DeepSeek está entrenando un modelo 2T mientras establece el objetivo de seguimiento en 8T. Se puede entender que el laboratorio principal ha vuelto a considerar una escala de parámetros total más grande como una ruta importante para impactar el límite superior de capacidades.
Incluso los modelos estadounidenses de código cerrado que no revelan parámetros no pueden escapar al escrutinio externo. Los forasteros estiman que el Mythos de Anthropic es 8T; OpenAI ya no ha revelado la escala del modelo desde la era GPT-4, pero existe el rumor en la comunidad de que Astra ha alcanzado un MoE de 10T.
La cantidad de parámetros nunca ha perdido su atractivo, al igual que el valor del poder de combate en el panel del juego: la gente sabe que no puede representarlo todo, pero siempre será el número más intuitivo y opresivo.
De hecho, a la gran industria del modelismo no le gusta mucho hablar de parámetros desde hace algún tiempo.
En los últimos dos años, la destilación, los modelos pequeños, el MoE, el aprendizaje por refuerzo y los cálculos del tiempo de inferencia se han turnado. En lugar de alardear de que tienen cientos de miles de millones o billones de parámetros, los fabricantes de modelos están más dispuestos a hablar de rendimiento, coste y eficiencia. Simplemente agrandar el modelo hará que parezca que tienes dinero pero no tienes dónde gastarlo.
Hoy en día, las cantidades de parámetros han vuelto a aumentar y han vuelto a convertirse en el "frente" de los modelos de última generación.
Sin embargo, los 5T, 8T y 10T de hoy ya no son lo mismo que "más parámetros, cuanto más grande es el modelo" en la ronda anterior de Scaling.
La razón más directa por la que las cantidades de parámetros pueden volver a ponerse sobre la mesa es que la arquitectura principal de los modelos ultragrandes ha cambiado.
En el pasado, la corriente principal de los modelos grandes era la arquitectura densa, donde la escala de parámetros y la cantidad de cálculo estaban básicamente unidas. En pocas palabras, significa cuántos parámetros hay en el modelo y, básicamente, deben ingresarse juntos en cada cálculo. Cuantos más parámetros hay, mayor tiende a ser el límite superior de capacidades, pero el costo del entrenamiento y la inferencia también aumenta.
Hoy en día, cada vez más modelos grandes utilizan MoE, combinación de expertos y arquitectura experta mixta.
Es más como una empresa con muchos expertos. El modelo puede tener cientos o miles de expertos, pero sólo una pequeña parte de ellos es seleccionada para trabajar en cada tarea. Por ejemplo, Kimi K3 tiene 2,8T de parámetros totales, pero cada Token solo activa 104B, aproximadamente el 3,7%; DeepSeek V4-Pro tiene 1,6T de parámetros totales y cada token solo activa 49B, aproximadamente el 3%.
Así que hoy en día, si un modelo tiene parámetros de 5T, 8T o incluso 10T, no significa que deba ejecutar estos parámetros de 10T cada vez que genera un token.
Cuánto puede contener el modelo y cuánto debe calcularse cada vez se han convertido en dos números diferentes.
Los parámetros pueden entenderse como el espacio utilizado por el modelo para transportar conocimientos, patrones y capacidades. Cuanto mayores sean los parámetros totales, más espacio tendrá teóricamente el modelo para aprender distribuciones cada vez más complejas; MoE le permite llamar sólo a algunos de ellos cuando sea necesario.
Como resultado, el modelo puede continuar aumentando la capacidad total de parámetros sin hacer que cada cálculo sea más pesado año tras año.
Aún tomando K3 como ejemplo, tiene un parámetro total de 2.8T, que es aproximadamente tres veces la escala de K2.5, pero entre 896 expertos, solo 16 de cada Token están activados. Dark Side of the Moon dijo que gracias a un MoE más escaso y una serie de optimizaciones arquitectónicas, la eficiencia de escalado general de K3 se ha mejorado aproximadamente 2,5 veces en comparación con K2.
La era del Agente acaba de devolver esta "capacidad" al centro de la competencia.
En el pasado, la capacidad de un Chatbot a menudo se medía uno por uno. Las matemáticas analizan las matemáticas, el código analiza el código y las preguntas y respuestas analizan el conocimiento. Si el modelo alcanza picos más altos en varios puntos de referencia clave, es suficiente para demostrar que es muy fuerte.
Pero el Agente encadena estas capacidades en la misma cadena de tareas. Una tarea realmente larga puede comenzar con la búsqueda de información, luego leer páginas web, mirar imágenes, escribir código, llamar al terminal y luego encontrar errores, modificar el plan, llamar a otras herramientas e incluso asignar subtareas a otros agentes.
Cuando OpenAI lanzó la API de Agentes en septiembre de este año, enumeró directamente la ejecución a largo plazo, la gestión de contexto, el uso de herramientas y la coordinación de subagentes como la infraestructura central del Agente, y enfatizó que el Agente debe ejecutarse de manera confiable durante horas o incluso días.
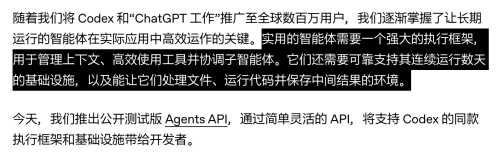
En una sesión de preguntas y respuestas, si una determinada habilidad falla ocasionalmente, sólo se puede perder una pregunta; En una tarea del Agente que involucra docenas o cientos de pasos, cualquier vínculo débil puede interrumpir todo el vínculo. Cuanto más larga sea la tarea, mayores serán los requisitos de cobertura de capacidad y estabilidad. Como resultado, la competencia fronteriza ha comenzado a tener un evidente "efecto barril".
METR ahora incluso utiliza directamente el "intervalo de tiempo de la tarea" para medir las capacidades del Agente, porque cuanto más larga es la tarea, mayor es el requisito para que el modelo complete continuamente una serie de operaciones diferentes.
En la era Chatbot, es más fácil ver el pico de capacidades, mientras que en la era del Agente, la cobertura de capacidades es cada vez más importante.
En este momento, la capacidad de parámetro mayor tiene un nuevo valor. Cuanto más larga sea la tarea, menos sesgado debe ser el modelo; Cuantas más cosas pueda hacer el Agente, más amplias serán las capacidades que la base debe cubrir.
MoE abre espacio para una expansión continua de la capacidad y Agent amplifica aún más el valor de la capacidad. Por lo tanto, los fabricantes de modelos están haciendo todo lo posible para mejorar la eficiencia y al mismo tiempo llevar los parámetros a 5T, 8T y 10T nuevamente.
La potencia informática ahorrada no hizo que Scaling desapareciera, sino que creó nuevo espacio para Scaling.
Comentarios