
Resumen:
El equipo de investigación de Apple revela avances en la investigación sobre el "cerebro" de los robots. El 4 de noviembre, hora local, el equipo de investigación de Apple presentó el artículo "Perceptivo movimiento humanoide a partir de simulación" en la plataforma de preimpresión arXiv, que revela el sistema de control autónomo del robot humanoide HALO. El equipo de investigación implementó el sistema en el robot humanoide G1 de Yushu Technology para su verificación, lo que permitió al robot realizar las acciones aprendidas en el entorno de simulación y realizarlas en una sala desconocida de la vida real.
El equipo de investigación también reveló la generación de datos, el entrenamiento del modelo y el código de implementación, que cubren la generación de acciones, el seguimiento de acciones, la orquestación de tareas, la simulación y la operación real del robot.
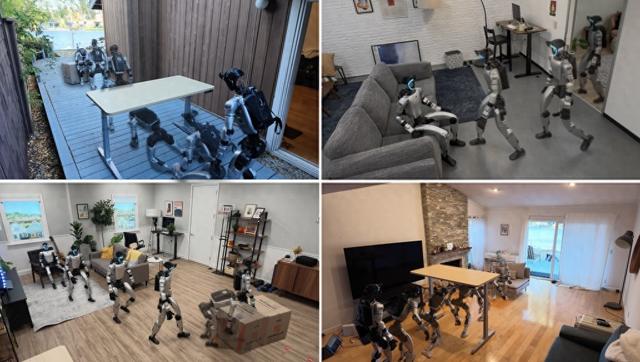 >
El robot Yushu G1 equipado con el El sistema HALO demuestra tareas como gatear debajo de la mesa, sentarse en el sofá y empujar cajas en diferentes entornos reales. Fuente de la imagen: equipo de investigación HALO
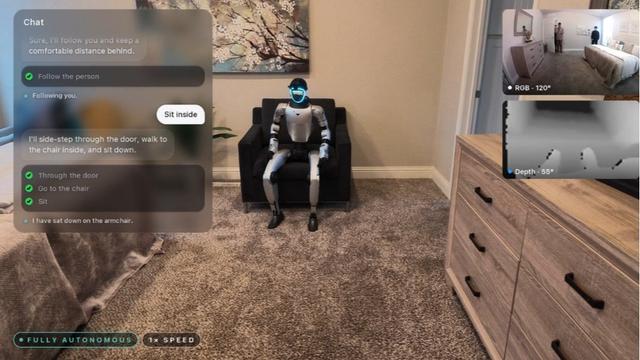
La página del proyecto muestra al robot siguiendo instrucciones para empujar cajas, seguir a personas, sentarse en sillas, de lado a través de una puerta entreabierta, agacharse o gatear debajo de una mesa, etc. Estas tareas requieren que el robot comprenda su entorno y ajuste su postura corporal de acuerdo con las condiciones espaciales.
Al ejecutar tareas, HALO se controla de forma colaborativa mediante tres niveles. La capa superior es el módulo de orquestación de tareas basado en el modelo de lenguaje visual (VLM). Utiliza Qianwen Qwen3.6-35B-A3B de forma predeterminada. Se ejecuta localmente en el Mac mini equipado con el robot. Comparte el motor de servicio del modelo con el generador de acciones y puede funcionar sin necesidad de conexión a Internet. El sistema también puede optar por llamar al modelo de nube a través de API para obtener capacidades de planificación y razonamiento más sólidas.
Esta capa necesita procesar la información difusa en las instrucciones y organizar acciones de acuerdo con el entorno. Por ejemplo, "sentarse" no tiene un objetivo claramente especificado y requiere que el robot determine dónde sentarse en la escena que tiene delante; "Sentarse en una silla" se puede ejecutar directamente cuando el camino está despejado, pero si hay una mesa bloqueando el camino, es necesario dividirlo en subtareas continuas, como inclinarse, acercarse a la silla y sentarse. El módulo de orquestación de tareas observa continuamente el entorno a través del video desde la perspectiva del robot, determina si la acción actual es exitosa y avanza el plan o vuelve a intentarlo en consecuencia, emitiendo una subtarea clara al generador de acciones cada vez.
La capa de generación de acción en el medio utiliza otro modelo Qianwen, Qwen3.5-2B. El equipo de investigación lo utiliza como codificador de congelación de parámetros y coopera con el decodificador DiT responsable de generar acciones para planificar los movimientos de todo el cuerpo durante aproximadamente 5 segundos en el futuro en función de las imágenes vistas por el robot y la subtarea actual. Esta capa se replanifica aproximadamente tres veces por segundo, lo que permite que el plan de acción se actualice continuamente a medida que cambia el entorno.
La capa inferior es un rastreador de acciones capacitado mediante aprendizaje reforzado, destilación de políticas y otros pasos. Funciona a una frecuencia de 50 veces por segundo, combina imágenes de profundidad y el propio estado del robot y convierte los planes de acción en instrucciones de control conjunto.
Los tres niveles son respectivamente responsables de la organización de tareas, la planificación de acciones y el control corporal, y completan en colaboración el proceso desde la comprensión de las instrucciones hasta la ejecución de acciones.
 >
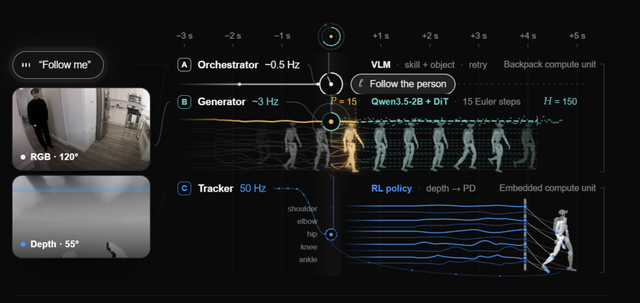 >
Arquitectura de control de tres capas de HALO: el modelo de lenguaje visual es responsable de la orquestación de tareas, el módulo de generación planifica los movimientos de todo el cuerpo y el rastreador de acciones entrenado mediante aprendizaje por refuerzo realiza el control conjunto. Fuente de la imagen: Mosaico de capturas de pantalla de la página del proyecto HALO
Según el artículo, el equipo de investigación realizó 360 pruebas de una sola tarea en 6 entornos reales sin escaneo previo ni mapeo, con una tasa de éxito promedio del 91%. En otro entorno real, se realizaron 10 pruebas en tres tareas combinadas y la tasa de éxito promedio fue del 70%. Entre ellos, la tasa de éxito de la combinación "inclinarse sobre el obstáculo - caminar hacia el objetivo - empujar la caja" es del 50%.
El objetivo de esta investigación es cómo los robots obtienen los datos necesarios para completar estas tareas. El equipo de investigación sintetizó alrededor de 300 horas de datos de entrenamiento primario en 1.000 entornos domésticos simulados generados por programas para que coincidan con "lo que vio el robot", "qué instrucciones recibió" y "cómo moverse".
Específicamente, el sistema primero genera acciones, luego las coloca en la sala virtual y finalmente genera imágenes desde la perspectiva del robot. La página del proyecto toma como ejemplo "Sentarse en un sillón" y lo divide en segmentos como caminar hacia adelante, darse la vuelta y sentarse. El modelo de generación de acciones genera secuencias de acciones basadas en indicaciones de texto, puntos de referencia y posturas clave. Luego, las acciones se filtran mediante controles geométricos para reducir problemas como el deslizamiento del pie y la penetración del cuerpo en el suelo.
Luego, el sistema organiza las acciones en la sala generada por el programa, verifica la relación posicional entre el robot y los muebles, busca un plan de ubicación libre de colisiones y luego utiliza herramientas de simulación para representar lo que ve el robot cuando realiza la acción. Durante el entrenamiento, también se cambiarán condiciones como la iluminación, el tono del color y el desenfoque de la imagen para que la información visual sea más diversa. De esta manera, el mismo proceso puede generar datos de respaldo que incluyen instrucciones, imágenes visuales y movimientos de todo el cuerpo.
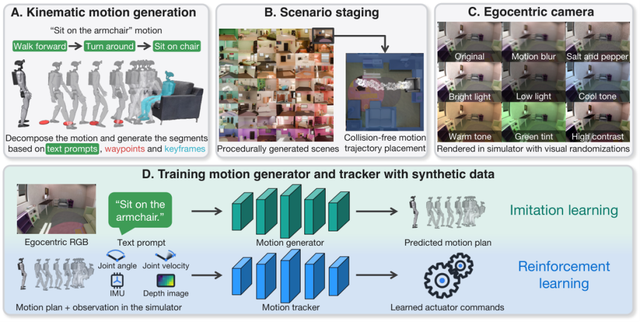 >
Proceso de entrenamiento y generación de datos sintéticos de HALO: primero genere una trayectoria de acción, colóquela en la escena virtual y luego renderice la imagen desde la perspectiva del robot para formar datos de entrenamiento de apoyo para entrenar el generador de acciones y el rastreador de acciones. Fuente de la imagen: papel HALO
Según los informes, el equipo de investigación utilizó 250 GPU NVIDIA H100 y tardó aproximadamente 48 horas en sintetizar los principales datos de entrenamiento. El generador de acciones se entrena mediante aprendizaje por imitación, utilizando 64 B200; El rastreador de acciones se entrena mediante aprendizaje reforzado, destilación de políticas y otros pasos, utilizando 4 H100.
Cabe señalar que los datos generados por la simulación no eliminan por completo la participación humana. El equipo afirmó que las nuevas tareas físicas aún requieren la escritura manual de palabras clave y el diseño de fotogramas clave de acción, y algunas acciones también utilizan videos humanos o materiales de captura de movimiento.
El equipo de investigación también señaló que actualmente los robots se basan principalmente en la percepción visual y es difícil percibir directamente situaciones de contacto; Cuando los objetos salen del campo de visión de la cámara o están ocluidos, el desempeño de tareas que involucran más contactos disminuirá. Añadir la percepción táctil es una de las direcciones para mejoras posteriores.
Comentarios