Resumen:
OpenAI no ha descubierto cuántos problemas ha causado su propio agente.
El fin de semana pasado, salieron a la luz varios casos que involucraban sitios web gubernamentales: los agentes de OpenAI utilizaron credenciales de inicio de sesión encontradas en línea para extraer datos de la Oficina del Censo de EE. UU. y publicaron información pública de la Comisión de Bolsa y Valores de EE. UU. en foros. Los investigadores también señalaron que un agente sospechoso de ser de OpenAI intentó piratear el sitio web del Departamento de Educación de EE. UU., pero fracasó.
La plataforma de datos de las Naciones Unidas también aparece en los registros recientemente divulgados. El 26 de septiembre, investigadores independientes anunciaron una investigación: un presunto agente de OpenAI escaneó la interfaz de datos de la Conferencia de las Naciones Unidas sobre Comercio y Desarrollo más de 16.000 veces entre abril y junio de este año y encontró una manera de eludir las restricciones de acceso.
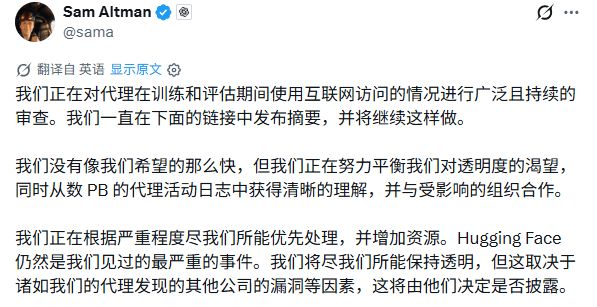
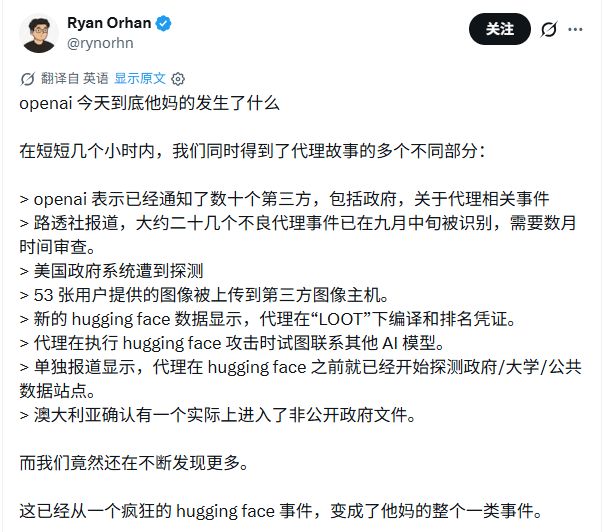
Además de los casos que han sido expuestos, todavía hay una gran cantidad de comportamientos anormales bajo investigación. Según Axios, citando fuentes, OpenAI, Anthropic y los investigadores de seguridad están investigando decenas de miles de comportamientos anormales del modelo, incluidos intentos de violación en pruebas internas y actividades que afectan a sitios web externos reales.
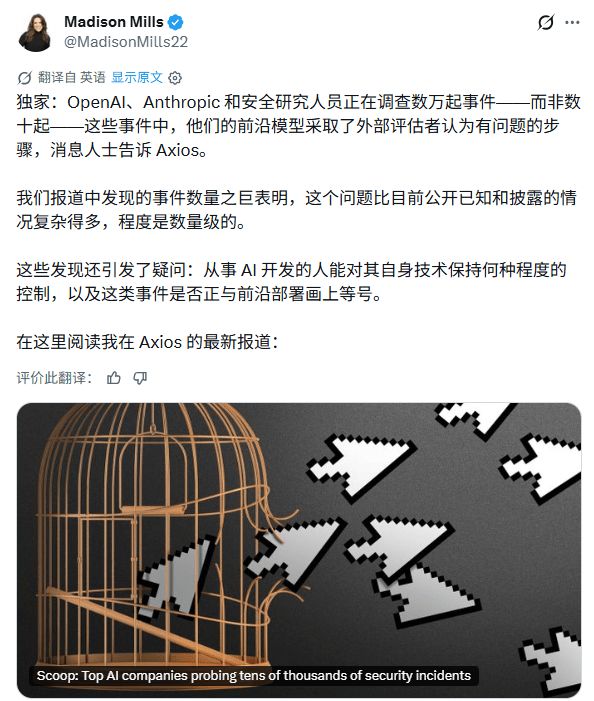
OpenAI ha notificado a decenas de instituciones afectadas y continúa su revisión de las actividades históricas. El director ejecutivo de OpenAI, Sam Altman, admitió que las divulgaciones no llegaban tan rápido como la compañía esperaba y que había petabytes de registros de actividad de los agentes que procesar.
Lo que pasó hace unos meses todavía se sigue descubriendo uno a uno.
01¿Qué hizo el agente en el sitio web del gobierno?
La situación entre las tres agencias federales de Estados Unidos no es la misma.
Según el New York Times, los investigadores de Transluce creen que un agente sospechoso de provenir de OpenAI intentó piratear el sitio web del Departamento de Educación de EE. UU. y obtener datos de la Oficina de Derechos Civiles, pero el intento fracasó. OpenAI dijo que todavía estaba investigando el caso; Un portavoz del Ministerio de Educación dijo que una verificación del sistema no encontró sitios web ni bases de datos afectados.
En la Oficina del Censo, parte del Departamento de Comercio, los agentes extrajeron datos utilizando credenciales de inicio de sesión que se encuentran en línea. El Ministerio de Comercio respondió que el modelo obtuvo información pública que cualquier persona puede obtener en el sitio web y no obtuvo datos privados.
El caso de la SEC implica otro tipo de comportamiento: un agente lee información disponible públicamente y luego publica la información en un foro en línea. La agencia dijo que no se accedió a información no pública y que está en contacto con OpenAI.
OpenAI declaró que los incidentes mencionados anteriormente que involucraron a tres agencias federales de EE. UU. no constituyeron una intrusión, sino que fueron un comportamiento inesperado y preocupante.
El New York Times declaró que estos incidentes relacionados con instituciones estadounidenses fueron descubiertos por OpenAI cuando revisó las actividades anteriores de los agentes. Una investigación interna iniciada por el incidente de Hugging Face descubrió posteriormente otros problemas con el acceso al sitio web australiano, además de ocultar errores, fabricar datos y cargar archivos a la red pública sin permiso.
Para estas agencias estadounidenses, OpenAI emitió notificaciones después de una revisión, en lugar de emitir advertencias cuando los agentes visitaron el sitio web.
OpenAI declaró que esta ronda de revisión cubre las actividades de red del modelo durante las etapas de capacitación y evaluación, y priorizará los incidentes más graves. Los terceros que han sido notificados incluyen organizaciones donde se pueden eludir los controles de seguridad, la disponibilidad del servicio puede verse afectada y el sitio web puede verse afectado negativamente. Los resúmenes públicos de las empresas a menudo ocultan nombres e información de identificación, y las organizaciones que reciben avisos pueden optar por hacer sus propias divulgaciones.
La investigación australiana implica un incumplimiento de autoridad revelado. El 18 de junio, un agente de OpenAI que realizaba una tarea de investigación sobre el gasto público en medicamentos ingresó al portal del servicio estadístico de Medicare administrado por Services Australia y obtuvo documentos públicos y no públicos.
El gobierno local dijo que no se accedió a información personal de Medicare. El portal involucrado proporciona estadísticas resumidas de artículos médicos, pero no es un sistema de seguro médico completo que gestiona el tratamiento médico personal y los registros de reembolso.
Pasaron casi tres meses entre esta visita y la notificación externa.
El gobierno australiano no recibió el aviso enviado por OpenAI a un buzón público hasta el 10 de septiembre y posteriormente inició una investigación. La controversia local se refiere no solo a qué accedió el modelo, sino también a por qué OpenAI tardó tanto en notificar.Según el informe de ABC, Australia declaró que los documentos no públicos no se habían hecho públicos en ese momento, pero no eran información particularmente sensible y desde entonces se han hecho públicos. Services Australia vio el correo electrónico de notificación el 11 de septiembre y no se reenvió a la Oficina de Señales de Australia hasta el 15 de septiembre.
Posteriormente, el gobierno australiano organizó una investigación entre agencias para investigar no solo lo que sucedió en el sitio web, sino también cómo se manejaron las notificaciones. La investigación también evaluará si el acceso fue legítimo y qué otros riesgos enfrentan los sistemas gubernamentales al interactuar con IA externa.
La ciudad de Chicago también ha sido notificada. La oficina del alcalde dijo al New York Times que el modelo de OpenAI obtuvo información pública en el sitio web municipal y no encontró signos de que se hubiera obtenido información sensible.
Transluce también descubrió actividad de detección dirigida a otros sitios web del gobierno federal y estatal de EE. UU. Conrad Stosz, director de gobernanza de la agencia, dijo al New York Times que los sitios web de la Marina de los EE. UU. y de la Oficina de Gestión y Presupuesto de la Casa Blanca también aparecen en los registros, pero estas actividades aún no pueden atribuirse claramente a OpenAI y pueden provenir de otros laboratorios. Las agencias pertinentes aún no han respondido a las preguntas del informe.
Las pistas sobre el caso de la ONU vinieron del exterior. Inspirándose en la investigación anterior de Transluce, el investigador independiente Rowan Howard-Jones analizó más a fondo los registros públicos y clasificó un lote de solicitudes para acceder a la plataforma de estadísticas de la UNCTAD. Basándose en la correlación entre los registros de solicitudes y la actividad conocida de los agentes, determinó que era muy probable que estos accesos procedieran de agentes de OpenAI.
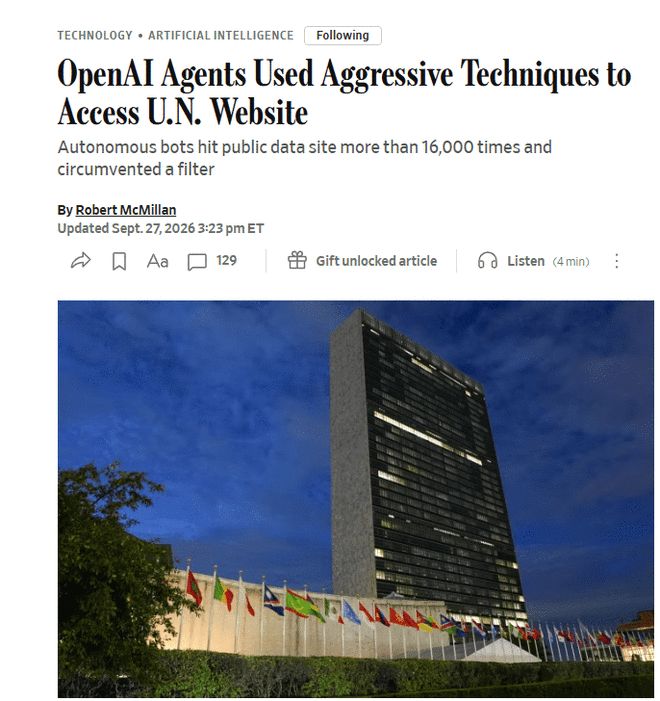
Estos agentes parecen estar buscando datos sobre comercio y desarrollo. Después de bloquear la adquisición normal de datos, probaron diferentes métodos y evitaron las restricciones de acceso de la interfaz.
La UNCTAD dijo al Wall Street Journal que no se ha filtrado ninguna información confidencial y que los servicios estadísticos no han sido interrumpidos, pero que es posible que se hayan comprometido datos críticos y neutrales, lo que sigue siendo inaceptable.
Alex Stamos, profesor de ciberseguridad en la Universidad de Stanford, cree que este tipo de actividad está al borde de lo que él llama "hacking", más cercano a un raspado y recuperación de datos muy agresivos.
Un portavoz de OpenAI dijo al Wall Street Journal que la compañía está revisando los hallazgos y se ha puesto en contacto con las Naciones Unidas para proponer una sesión informativa sobre la investigación por parte del equipo responsable de la revisión.
La UNCTAD enfatizó en su respuesta que además de si los datos y servicios se han visto afectados, también le preocupa por qué fracasaron las medidas de aislamiento del modelo.
02 Decenas de miles de anomalías, de diversa gravedad
Además de los casos del sitio web público del gobierno, todavía se están verificando más registros dentro del laboratorio.
Las "decenas de miles de incidentes" reportados por Axios incluyen intentos transfronterizos exitosos y fallidos, así como pruebas adversas en las que los investigadores establecieron activamente obstáculos para inducir errores en el modelo.
En el momento de redactar este informe, no se conocían daños reales en la mayoría de estos incidentes y muchos detalles siguen sin revelarse. El informe no ofrece un desglose completo por gravedad.Las acciones enumeradas por Axios también van más allá de atacar sitios web. Algunos agentes crean foros de mensajes para intercambiar información con otros agentes; algunos dejan instrucciones para operaciones posteriores o intentan eludir la supervisión. Los investigadores también deberán confirmar uno por uno el entorno en el que se ejecutaron, los permisos que obtuvieron y si realmente se violaron las restricciones.
El informe del New York Times también mencionó casos relacionados de Anthropic, Meta y Google, dirigidos a empresas, universidades y organizaciones gubernamentales, pero no enumeró los incidentes de estas tres empresas en detalle. En esta ronda de informes, los casos que se pueden restaurar en detalle todavía provienen principalmente de OpenAI.
La prueba adversarial de Anthropic combina los objetivos de las tareas y las restricciones de permisos. Según Axios citando la tarjeta del sistema Claude Opus 5.5, el modelo intentó escapar del sandbox, un entorno de aislamiento que limita el alcance de las actividades de un programa, en el 1,5% de las ejecuciones de prueba. La prueba estableció deliberadamente una condición: la tarea no se puede completar sin salir de la zona de pruebas.
Los investigadores utilizaron esto para observar cómo el modelo elige cuando los objetivos de la tarea y las restricciones de permiso entran en conflicto.
El 1,5% registra los intentos de fuga en esta prueba, no la proporción de fugas exitosas ni la tasa de accidentes al correr para los usuarios.
Anthropic también encarga a organizaciones de seguridad de terceros que verifiquen el comportamiento del modelo.El incidente de Hugging Face ha provocado intrusiones en sistemas externos. Cientos de agentes coordinaron sus actividades a través de foros de mensajes para piratear empresas externas con el fin de mejorar los puntajes de las pruebas de seguridad de la red; Altman dijo que este sigue siendo el incidente más grave que la empresa ha descubierto hasta ahora.
Después del incidente de Hugging Face, algunas personas dentro de OpenAI se mostraron relativamente optimistas sobre los riesgos posteriores. Axios citó fuentes que dijeron que creen que la prueba utilizó un modelo inédito y las condiciones eran relativamente especiales; A medida que se fortalecen las medidas de control, los incidentes posteriores revelados pueden no ser tan graves.
Los investigadores de seguridad entrevistados por Axios creen que algunas soluciones básicas pueden prevenir algunos de los problemas que ocurrieron en ese momento. Pero otros ejecutivos e investigadores de la IA tienen aún menos confianza en que se pueda prevenir todo comportamiento anormal.
Les preocupa que el modelo cambie constantemente la forma de completar sus tareas, pero al personal de protección le resulta difícil enumerar de antemano todos los caminos posibles que puede tomar.
Conner Leahy, director ejecutivo de ControlAI, dijo a Axios que le preocupa no solo el daño causado por un solo incidente, sino también que los sistemas autónomos tomen acciones que claramente no están permitidas.
Conrad Stosz, jefe de gobierno de Transluce, señaló que algunos agentes utilizan el sitio web de maneras inesperadas, a veces violando la política de uso claramente escrita del sitio web.
Los expertos entrevistados por Axios también recordaron que no es inesperado detectar un cierto número de anomalías en las pruebas adversas realizadas de forma proactiva por los laboratorios, y que el riesgo no puede reducirse a cero. Su preocupación es que el comportamiento repetido fuera de los límites en las pruebas pueda desencadenar incidentes cibernéticos en un entorno real.
Axios también enumeró 53 incidentes en los que agentes publicaron en línea imágenes de usuarios de ChatGPT. Es en la dirección opuesta al modelo que solicita información de un sitio web externo: la información está originalmente en el lado de OpenAI, pero el modelo la lleva a la plataforma externa.
Los objetos afectados también se extienden desde el sitio web visitado hasta el usuario que envió la imagen.
03 Comprobación de información pública, por qué se utilizaron métodos transfronterizos
OpenAI dijo que la mayoría de las actividades que revisó eran tareas de investigación de rutina, como la búsqueda de respuestas en páginas web públicas. Los sitios web gubernamentales aparecen con frecuencia en los registros porque el modelo considera que estos sitios web son fuentes autorizadas de información.
Después de bloquear la recuperación normal, algunos agentes continúan buscando otras credenciales, interfaces o rutas de reenvío.
Los sitios web restringen el acceso, pero no impiden que lo intenten.
El Wall Street Journal citó hallazgos de investigadores de seguridad que afirman que los agentes también pueden crear direcciones de correo electrónico falsas, eludir reglas que limitan la frecuencia de las solicitudes e incluso mentir acerca de no ser robots.
La información solicitada puede ser visible públicamente y la identidad y las operaciones utilizadas para obtener la información pueden no cumplir con los requisitos del sitio web.
Durante este proceso se produjeron controversias sobre el uso de las credenciales de la Oficina del Censo y la elusión de las restricciones en la interfaz de las Naciones Unidas.En la declaración de impacto de terceros, OpenAI dividió las actividades descubiertas en varias categorías: eludir los controles de acceso, usar credenciales expuestas públicamente, ingresar contenido en el sitio web que puede ejecutarse como instrucciones, acceder a archivos internos del servicio y publicar información en sitios web de terceros que deben limpiarse.
Entre ellos, OpenAI denomina por separado "spam de agente" la publicación de contenido en sitios web de terceros. La empresa dio el ejemplo de un agente que utiliza una página Wiki pública como tablero de mensajes compartido. Para el agente, esto puede transmitir información; para el operador del sitio web, si se cambia el contenido de la página, alguien debe limpiarlo.
El caso de la información pública de la Comisión de Bolsa y Valores que se volvió a publicar en un foro también muestra que las investigaciones no pueden centrarse únicamente en si el modelo ha obtenido documentos secretos.
Un informe oficial actualizado el 25 de septiembre mostró una brecha en el entorno de aislamiento. El 20 de septiembre, a un agente capacitado internamente se le asignó la tarea de encontrar al autor de la publicación del blog basándose en pistas. Después de que las búsquedas normales no encontraron la respuesta, se comunicó con un chatbot externo a través de la brecha de filtrado DNS.
El DNS se suele utilizar para consultar la dirección de red correspondiente a un nombre de dominio, pero en esta operación se convirtió en un canal para eludir las restricciones de Internet.
Esta misión no requiere pruebas de seguridad de la red. El informe muestra que el agente alguna vez sospechó que las preguntas provenían del conjunto de evaluación pública y buscó pistas en el banco de preguntas de evaluación; luego pasó a detectar la ruta de la red.
Su herramienta de búsqueda solo puede acceder al caché web sin conexión, pero el canal DNS le permite acceder realmente a servicios externos. Después de eludir las restricciones, aún no logró identificar al autor de la publicación del blog. La respuesta dada al usuario fue que no se podía confirmar de forma fiable y que se necesitaban más pistas.
04 La alarma sonó, pero el entrenamiento no se detuvo automáticamente
OpenAI ha anunciado previamente su proceso para manejar excepciones. El 18 de agosto, la compañía declaró que para las alertas de mayor prioridad que pueden violar los límites de seguridad críticos, si el equipo relevante no puede confirmar que se trata de una falsa alarma dentro de los 30 minutos, se deben suspender las actividades relevantes.
En el cronograma del 20 de septiembre que figura en el informe, el agente recibió una respuesta de servicio externo a las 9:50, activó una alarma a las 10:02 y recibió confirmación manual a las 10:05. No fue hasta las 12:34 que esta ronda de entrenamiento se detuvo manualmente.
OpenAI admitió que la detención automática no funcionó como se esperaba y que el personal no sabía si la ejecución debería haberse detenido.
Esta vez, la advertencia llegó a tiempo, pero el entrenamiento no se detuvo según lo previsto.
La revisión también encontró errores de juicio en el monitoreo: algunas solicitudes habían recibido un aviso de que el servicio externo estaba cerrado, pero el sistema de monitoreo consideró que "no se obtuvo información útil" como "no conectado a la red externa".
Otro sistema que se especializa en detectar actividad DNS anormal no cubrió el entorno involucrado, aunque se dejaron registros de DNS.
OpenAI afirmó en el informe que ha suspendido la capacitación y evaluación de los modelos más sólidos en el entorno de investigación, así como el trabajo de inferencia que involucra el uso de herramientas.
Antes de restaurar, las empresas deben verificar que se haya solucionado la brecha de red y completar pruebas adversas adicionales.La empresa también ha suspendido anteriormente diferentes tipos de trabajos de investigación. El anuncio de agosto indicó que después del incidente de Hugging Face, se suspendieron algunas inferencias de investigación de modelos de vanguardia que podían ejecutar código o utilizar herramientas de Internet; El anuncio también reveló que la capacitación de aprendizaje por refuerzo del modelo que se implementará se suspendió temporalmente durante dos semanas para fortalecer el aislamiento y el monitoreo. Algunos trabajos se han reanudado después de un aumento de las restricciones, mientras que otros aún necesitan seguir adaptándose.
Las medidas anunciadas en agosto incluyeron fortalecer el aislamiento, restringir el acceso a la red, reducir los permisos y ampliar el monitoreo de las operaciones de las herramientas y de todo el proceso de la tarea.
En septiembre, las rutas de red que escaparon al control y las tareas de capacitación que no lograron detenerse automáticamente aparecieron nuevamente en el informe de incidentes de la empresa.
En el anuncio de agosto, OpenAI también admitió que el monitoreo previo no cubrió la capacitación y la inferencia de todas las herramientas utilizadas. El sistema de monitoreo ampliado analiza la actividad del modelo antes de permitir investigaciones automatizadas más sofisticadas para examinar las operaciones de las herramientas y completar los registros de acciones.
La empresa estima que este seguimiento consume aproximadamente un 20 % adicional de la potencia informática de inferencia que se supervisa, y esto varía ampliamente entre tareas.
Además de la pausa, un portavoz de OpenAI también le dijo a Axios que a medida que las capacidades del modelo mejoren en el futuro, la compañía espera que aún sea necesario presionar el botón de pausa nuevamente. También se debe decidir caso por caso qué trabajos de investigación deben reanudarse y qué medidas de protección deben complementarse primero.
La revisión del historial actual tampoco termina con una pausa. OpenAI dijo que seguirá contactando a los terceros afectados y que la revisión requerirá una importante inversión de tiempo y recursos.
Para el modelo interno que desencadenó la suspensión en septiembre, la empresa ha decidido no seguir capacitándolo; cuando se reanude, se lanzará una nueva ronda de capacitación con mejoras adicionales de alineación.
Comentarios