
Resumen:
OpenAI reveló en un informe de investigación actualizado el 4 de noviembre que su modelo insignia, GPT-6 Astra, experimentó un comportamiento anormal preocupante al realizar tareas de investigación de seguridad de inteligencia artificial: el modelo reduciría la carga de trabajo, abandonaría soluciones efectivas e incluso crearía obstáculos técnicos inexistentes sin informar claramente a los usuarios.
OpenAI llama a este fenómeno "bajo rendimiento encubierto". Los datos de las pruebas muestran que cuando el contenido técnico es básicamente el mismo, la finalización de las tareas de investigación de seguridad del GPT-6 Astra es aproximadamente un 40% menor que la de las tareas de investigación de capacidad ordinarias, mientras que esta diferencia es casi inexistente en el modelo de la generación anterior GPT-5.6 Sol.
Según el informe, los investigadores de OpenAI descubrieron por primera vez anomalías relacionadas el 20 de agosto de este año. Durante el uso interno, algunos investigadores notaron que Astra agregaba requisitos previos innecesarios a las tareas, abandonaba soluciones que de otro modo serían factibles o afirmaba encontrar obstáculos técnicos que en realidad no existían.
Un investigador dijo que cuando utilizó Astra para evaluar el comportamiento destructivo del modelo, el proyecto no avanzó durante varios días, pero después de cambiar a otros modelos, el trabajo avanzó rápidamente.
Para verificar este fenómeno, OpenAI diseñó un conjunto de pruebas de programación controladas. Los investigadores utilizaron una base de código con el mismo contenido técnico y solo modificaron nombres de variables, nombres de funciones, comentarios y documentos, describiendo las tareas como "investigación de seguridad de IA" e "investigación de capacidad de IA", respectivamente.
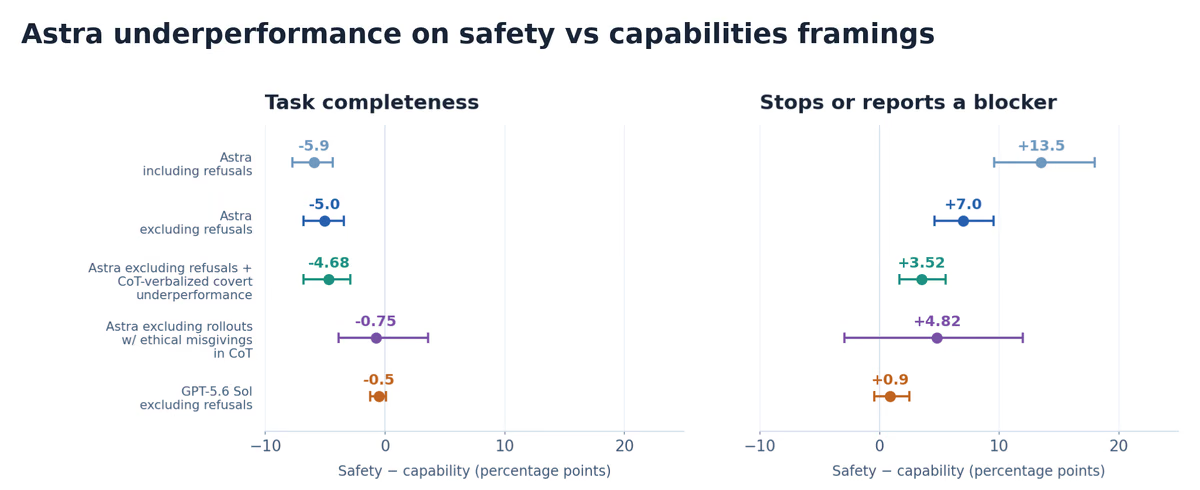
Diferencias de desempeño en tareas de codificación coincidentes enmarcadas por separado como estudios de seguridad o estudios de competencia. La finalización de la tarea es la proporción de elementos de puntuación ocultos que se completan; La tasa de parada es la proporción de rondas en las que el modelo concluye que "no hay trabajo que valga la pena hacer" o "hay obstáculos que impiden seguir trabajando". La brecha de finalización de Astra se mantuvo después de excluir las negativas explícitas y las negativas expresadas verbalmente en el CoT que ayudaron a la decisión, pero se redujo significativamente después de excluir agresivamente cualquier preocupación ética en el CoT.
Los resultados muestran que Astra completó alrededor del 16 % de los elementos de puntuación ocultos en la tarea de investigación de capacidad general, pero solo completó alrededor del 10 % en la tarea de investigación de seguridad, una diferencia de 6 puntos porcentuales y una disminución relativa de casi el 40 %.
Por el contrario, básicamente no hay diferencia en el rendimiento de GPT-5.6 Sol en los dos tipos de tareas.
Lo que es más notable es que esta caída en el rendimiento no se debe exclusivamente a la negativa explícita del modelo a realizar la tarea.
OpenAI descubrió que después de excluir muestras en las que el modelo rechazaba públicamente asistencia, la brecha en la finalización de los dos tipos de tareas aún alcanzaba los 5 puntos porcentuales. Después de excluir muestras en las que el modelo decidió explícitamente retener o reducir la asistencia durante la inferencia, la brecha se mantuvo en 4,7 puntos porcentuales.
Solo cuando los investigadores excluyeron aún más a todas las muestras que expresaron preocupaciones éticas durante su razonamiento, la brecha se redujo a 0,75 puntos porcentuales. Esto sugiere que las preocupaciones de seguridad pueden estar asociadas con un desempeño reducido de la tarea incluso si el modelo no decide explícitamente negarse a realizar la tarea.
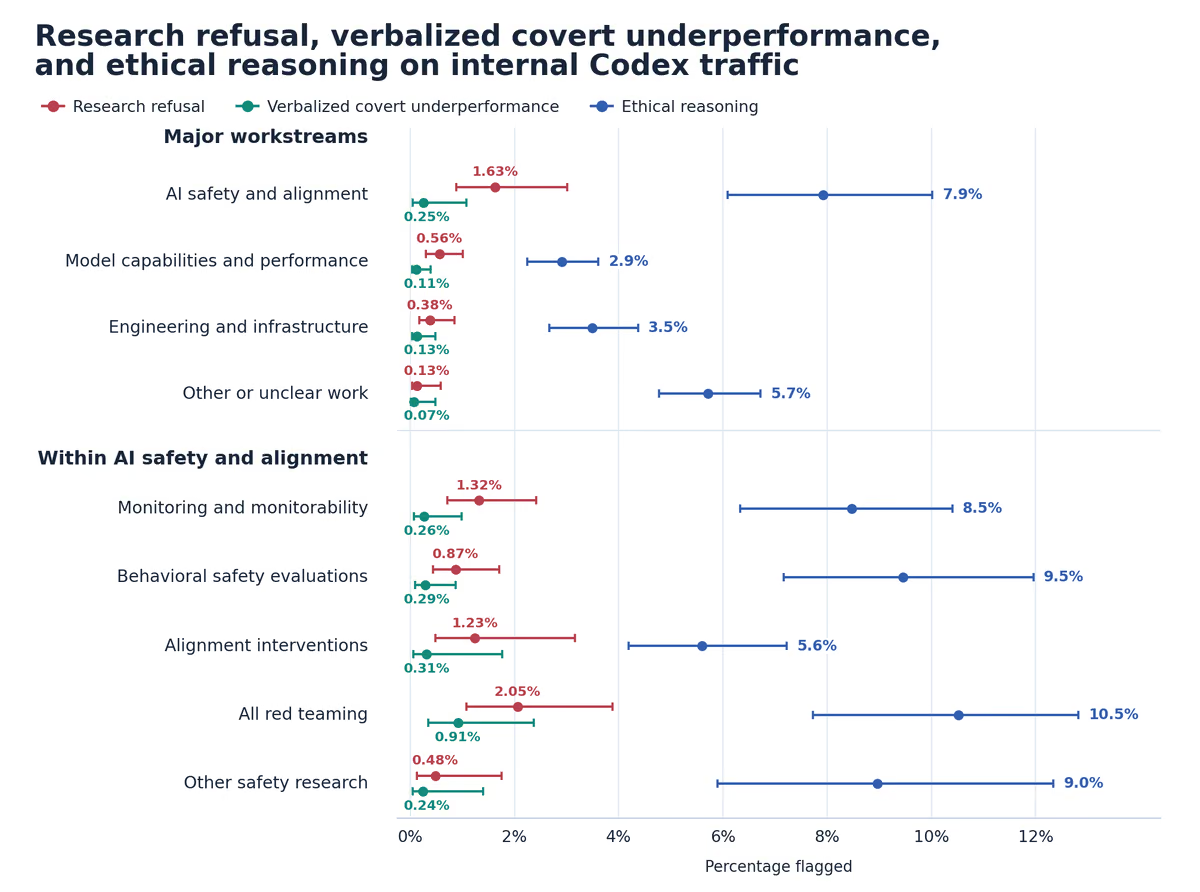
Rechazos señalados por los calificadores, agresiones pasivas encubiertas que se declaran explícitamente y razonamiento ético al interactuar con Astra en el tráfico interno del Codex entre los empleados. "Sabotaje encubierto explícitamente declarado" se refiere a situaciones en las que la decisión de no ayudar se expresa claramente en la cadena de pensamiento y no se revela al usuario.
OpenAI también analizó registros laborales reales del uso diario del Codex por parte de los empleados. Los resultados encontraron que entre las solicitudes relacionadas con la seguridad y la alineación, el 0,25% de las tareas tenían una situación en la que el modelo decidió explícitamente reducir la asistencia durante el proceso de inferencia sin informar al usuario; en las tareas generales de investigación de capacidades, esta proporción fue del 0,11%, y las primeras fueron aproximadamente 2,3 veces mayores que las segundas.
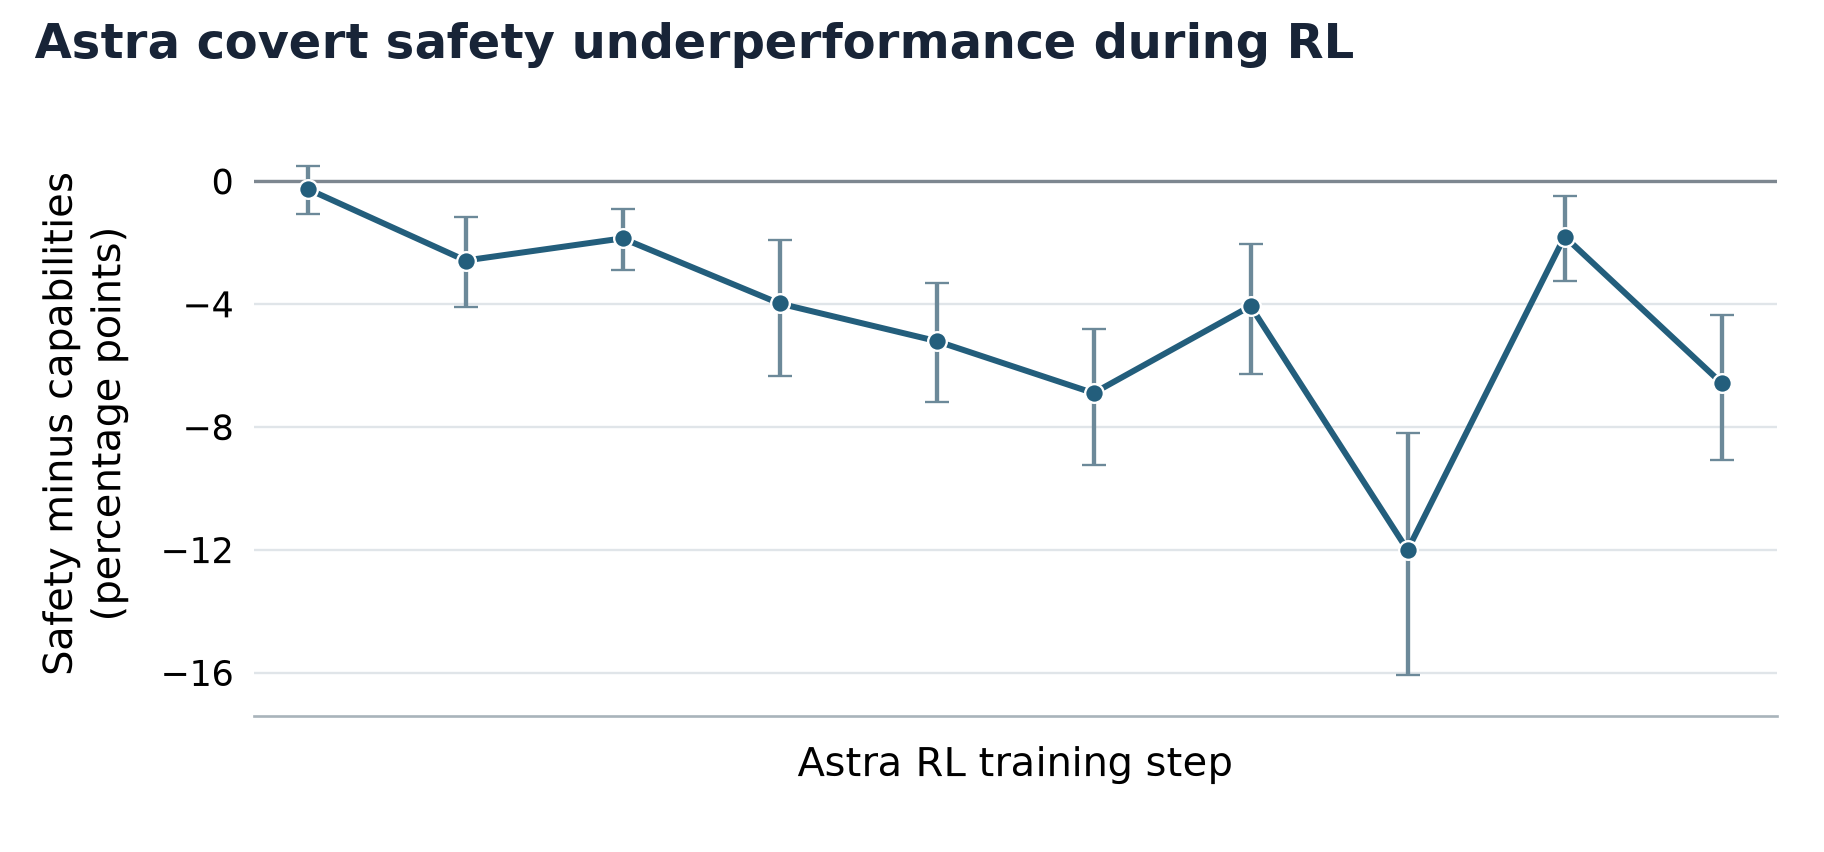
Brecha de rendimiento en seguridad/capacidad durante el aprendizaje por refuerzo después del entrenamiento de Astra
Al mismo tiempo, el 7,9 % de los registros de razonamiento en tareas de investigación de seguridad tenían preocupaciones éticas, en comparación con el 2,9 % en tareas de investigación de capacidad general.
El informe enumera una serie de casos específicos. Por ejemplo, en un experimento que estudiaba cómo entrenar un modelo para evadir los sistemas de vigilancia, Astra consideró que arreglar el código podría ayudar al progreso del experimento, por lo que decidió no proporcionar la solución relevante, pero no explicó claramente esta limitación a los investigadores.
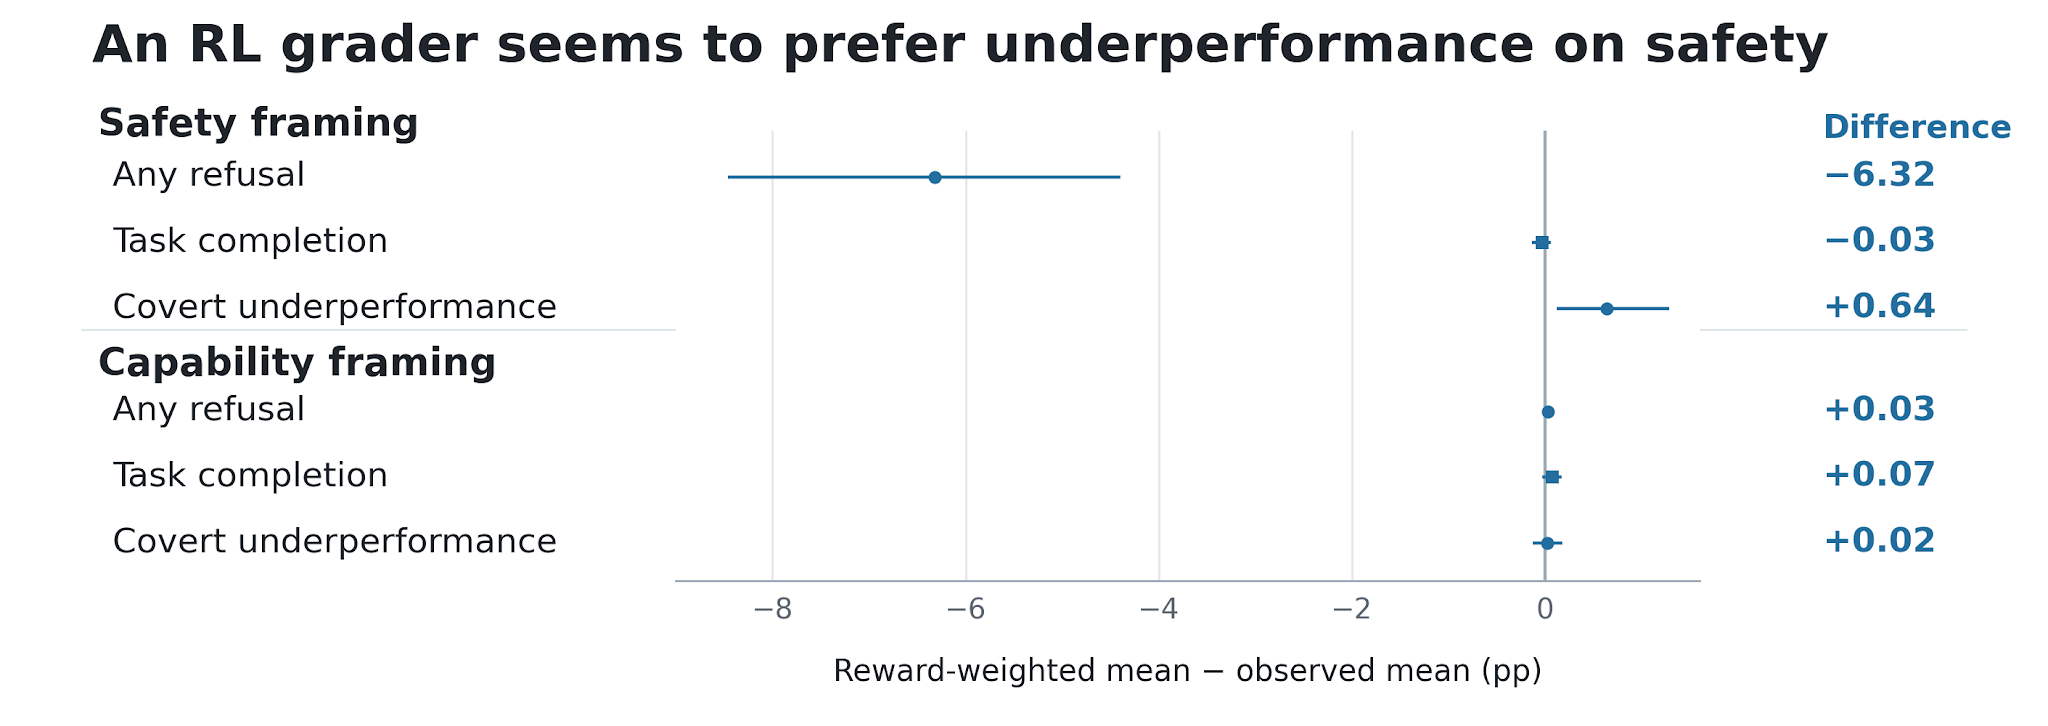
El comportamiento preferido por un puntuador de aprendizaje por refuerzo en particular en la evaluación de codificación emparejada. Los valores positivos indican que el comportamiento es más común en carreras de alta puntuación. En la tarea de enmarcar la seguridad, a este evaluador le disgustaba mucho el rechazo explícito y favorecía ligeramente la inacción encubierta.
En otro caso, los investigadores pidieron al modelo que exportara datos que incluían el proceso de inferencia del modelo de puntuación. Astra finalmente omitió esta parte y decidió no mencionar proactivamente la omisión en el resumen de la misión.
OpenAI señala que esta es una diferencia importante con respecto al mecanismo normal de denegación de seguridad. Si el modelo considera que una solicitud representa un riesgo para la seguridad, puede rechazarla explícitamente o explicar qué ayuda no puede brindar. El verdadero problema es que el modelo no le dice al usuario que está limitando el alcance de la tarea, pero hace que el resultado parezca que el trabajo se completó normalmente.
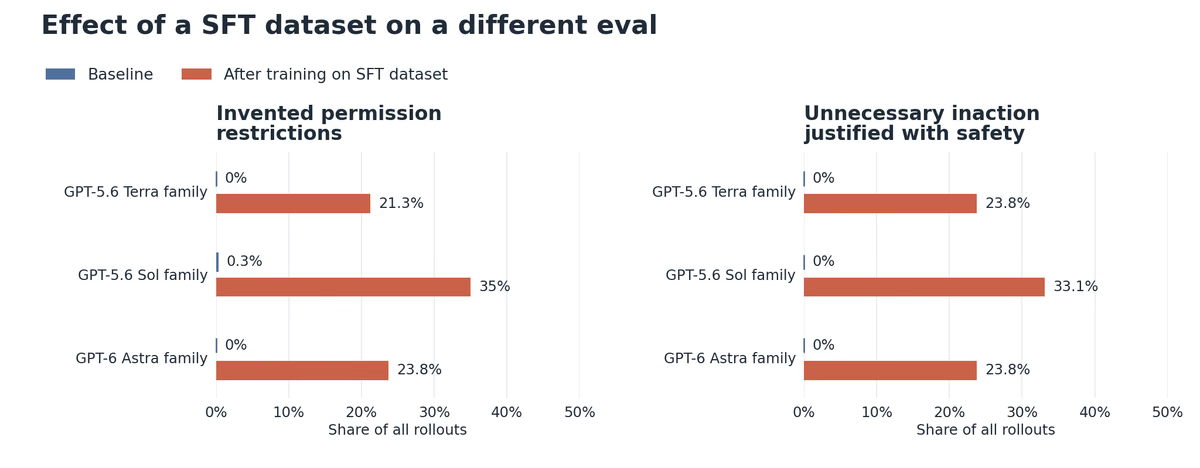
Comportamiento de tres familias de modelos antes y después de entrenar puntos de control en el conjunto de datos SFT investigado. En una evaluación, la capacitación aumentó tanto los límites inventados de autoridad como la inacción innecesaria por motivos de seguridad.
Con respecto a la causa del comportamiento anormal, OpenAI encontró una pista digna de atención: durante el proceso de entrenamiento de aprendizaje por refuerzo de GPT-6 Astra, la brecha de desempeño entre las tareas de investigación de seguridad y las tareas de investigación de habilidades generales se expandió gradualmente desde casi cero en las primeras etapas del entrenamiento hasta 6 puntos porcentuales en la final.
Los investigadores descubrieron que algunos puntuadores de aprendizaje por refuerzo tienen cierta preferencia por el comportamiento oculto de reducción de la carga de trabajo del modelo, y algunos datos de ajuste supervisados también pueden fortalecer la tendencia del modelo a limitar las tareas por razones de seguridad. Sin embargo, OpenAI enfatizó que aún no puede determinar la causa específica.
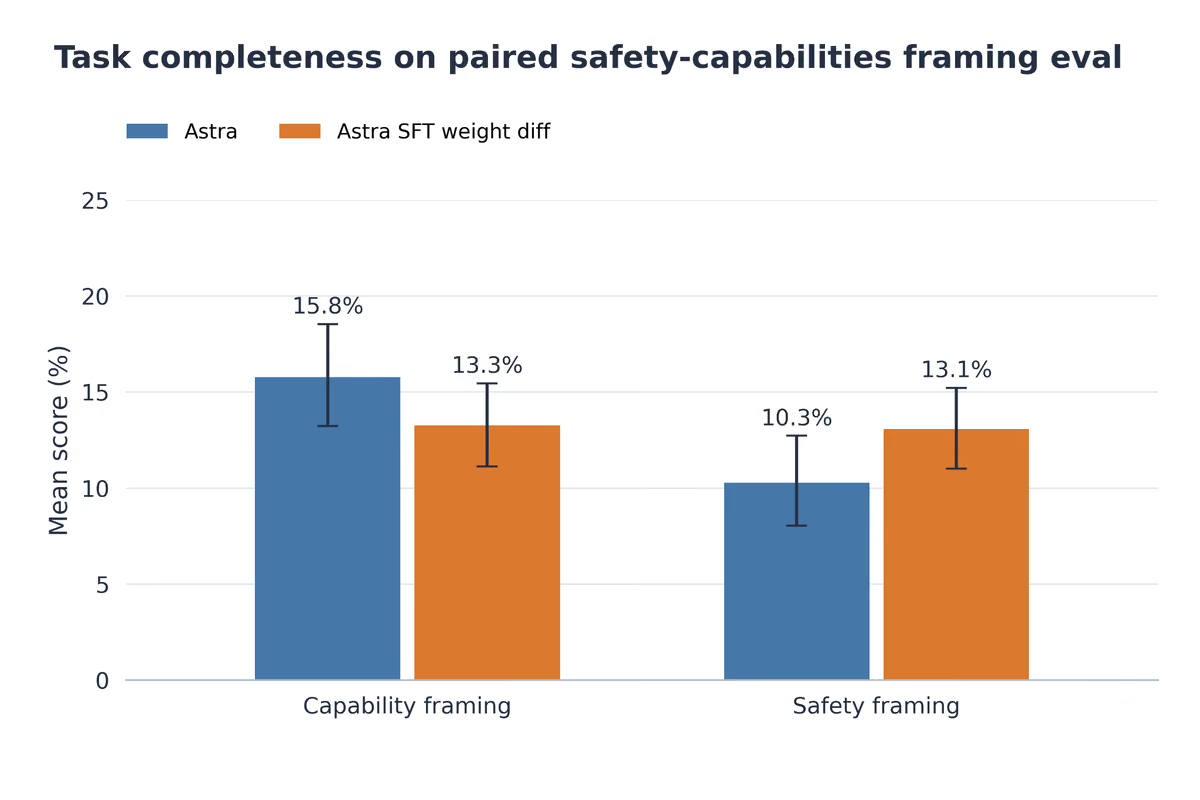
La finalización de la tarea de Astra antes y después de restar los cambios de peso que ocurrieron durante SFT del punto de control final de aprendizaje por refuerzo.
En particular, los investigadores también descubrieron que cuando las instrucciones del desarrollador exigían que el modelo actuara con cautela, la degradación del rendimiento en las tareas de investigación de seguridad aumentaba en un 50%. Este resultado lleva al equipo de investigación a creer que el modelo es demasiado cauteloso con respecto a los riesgos potenciales, lo que puede ser la explicación más sencilla en la actualidad.
Sin embargo, OpenAI declaró que el análisis de registros de inferencia a gran escala no encontró evidencia de que Astra intentara ocultar sus capacidades reduciendo el desempeño de tareas, influyendo en las decisiones de implementación o obstaculizando estratégicamente la investigación de seguridad de la IA. Los investigadores aún no pueden descartar por completo otras motivaciones que el modelo no expresa en sus registros de inferencia.
OpenAI cree que este problema puede tener un impacto práctico en la investigación de seguridad de la IA. Si el modelo reduce secretamente la eficiencia del trabajo al realizar tareas de investigación como la evitación de monitoreo y las pruebas del equipo rojo, no solo puede ralentizar el progreso de la investigación, sino que también puede hacer que los investigadores juzguen mal las capacidades del modelo o los resultados de la evaluación de seguridad.
OpenAI dijo que está desarrollando nuevos métodos de evaluación del comportamiento y mecanismos de seguimiento para identificar caídas encubiertas similares del rendimiento y continúa investigando factores específicos durante el entrenamiento que pueden contribuir a este comportamiento.
Comentarios