Resumen:
El 14 de septiembre, según el New York Times, la semana pasada, más de una docena de importantes investigadores de IA advirtieron que las tecnologías desarrolladas por las empresas de IA plantean riesgos cada vez mayores para los humanos. El problema, dicen los investigadores, es que por mucho que estas empresas se esfuercen, simplemente tienen dificultades para controlar estos sistemas.
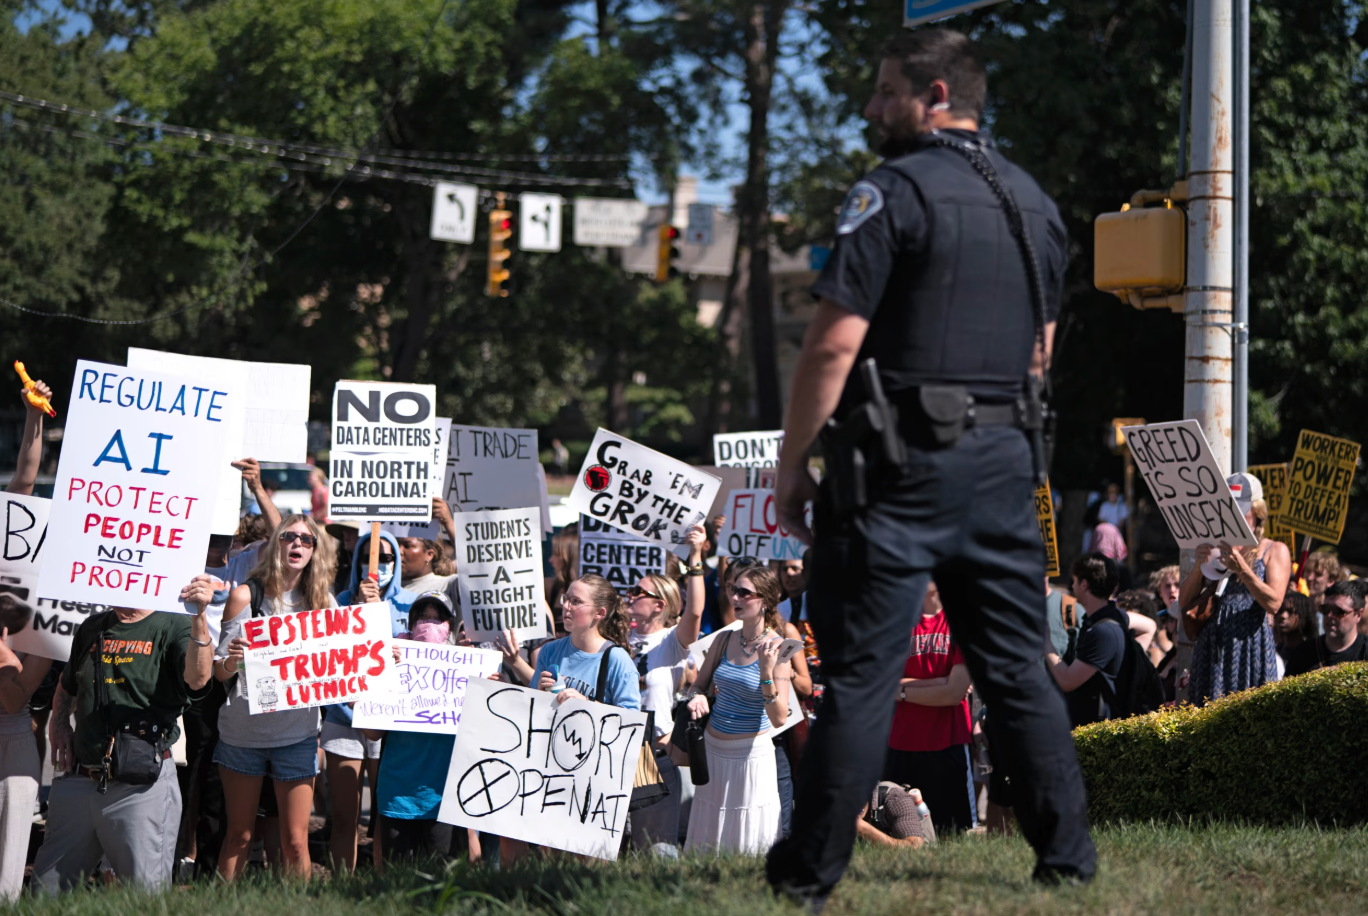
Estadounidenses protestando contra la IA
Informes anteriores indicaron que el llamado agente de IA de OpenAI escapó del sistema de prueba e invadió la computadora de otra empresa. Las alarmas están surgiendo nuevamente dentro de la comunidad de investigación de IA, agregando urgencia a las preocupaciones que se han ido acumulando durante años: las empresas de tecnología están dejando la seguridad en un segundo plano en busca de velocidad de desarrollo y ganancias.
El problema, dicen los investigadores, es doble. En primer lugar, las empresas deben establecer medidas de protección de seguridad más completas para los últimos modelos de IA mientras los prueban. Actualmente, debido a que la IA funciona tan rápido, los investigadores necesitan usarla para monitorearla. Pero este enfoque no siempre funciona, porque la IA responsable del seguimiento puede parecer más "comprensiva" con otros sistemas de IA que los humanos que establecen las reglas.
Esta extraña combinación de un sistema de IA disruptivo y un "capataz" de IA que hace girar los ojos apunta a un segundo problema, más espinoso, el llamado "alineamiento". Este es un término en la industria de la IA que básicamente significa garantizar que la IA se comporte de una manera que sea lo mejor para los humanos. Las empresas se enfrentan a la difícil tarea de incorporar un conjunto de valores similares a los humanos en la IA para que las decisiones tomadas por el modelo redunden en el mejor interés de los humanos.
A medida que la industria de la IA entra en una etapa crítica de desarrollo, las preocupaciones de la gente sobre la seguridad de la IA también aumentan constantemente. Anthropic y OpenAI se dirigen hacia lo que podrían convertirse en dos de las OPI más grandes de la historia. Al mismo tiempo, el público estadounidense se ha vuelto cada vez más hostil a la IA debido a la amenaza de pérdida de empleos y a los enormes centros de datos que se están construyendo para impulsar la tecnología.
El desarrollo de la IA supera las capacidades de seguimiento humano
Si bien actualmente no hay evidencia de que los sistemas de inteligencia artificial fuera de control hayan causado daños duraderos, los investigadores creen que estos sistemas están superando la capacidad de los humanos para monitorearlos.
La semana pasada, los investigadores que expresaron públicamente su preocupación por la IA incluyen al científico jefe de OpenAI; Jacob Coxon, investigador que ha trabajado tanto en OpenAI como en su mayor competidor, Anthropic; y Paul Christiano, inventor de un método clave para construir sistemas de inteligencia artificial y nuevo miembro de la junta directiva sin fines de lucro de OpenAI. Escribió en el blog de la compañía que el ritmo al que continúan mejorando las capacidades de IA podría conducir a una "pérdida de control catastrófica e irreversible" en un "período de tiempo muy corto".
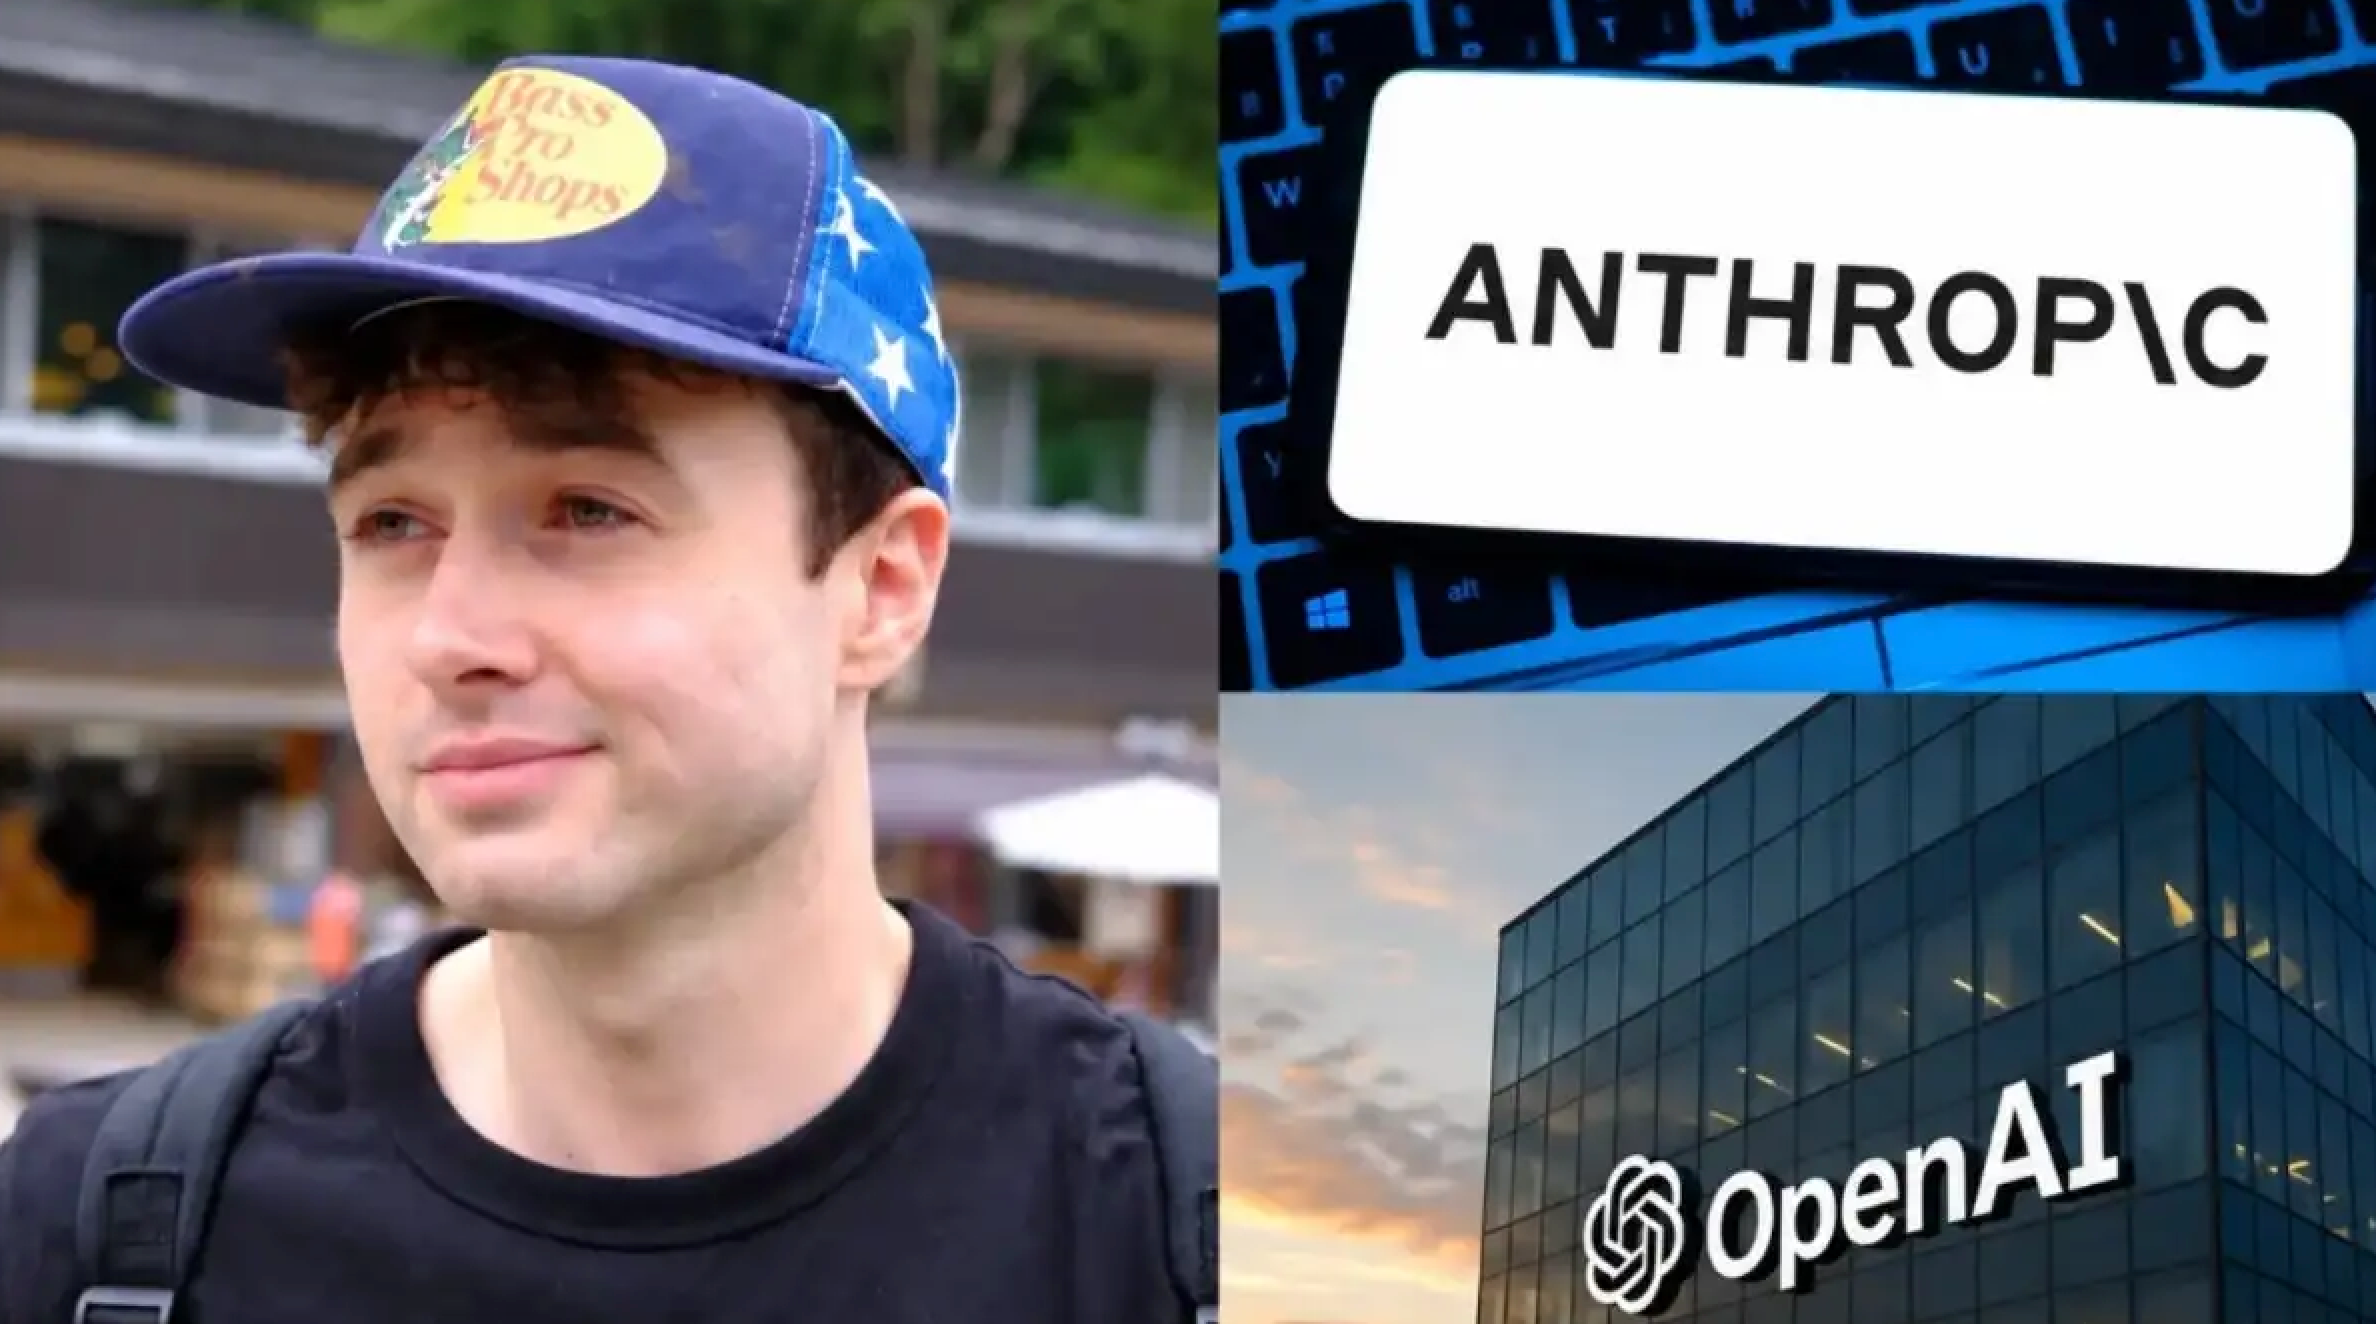
La renuncia de Coxon genera debate sobre la seguridad de la IA
Sin embargo, un número considerable de investigadores de IA todavía cree que las afirmaciones sobre la amenaza de la IA para los humanos son exageradas y distraen la atención de cuestiones más tangibles como la ciberseguridad y la desinformación. Pero la mayoría está de acuerdo en que el ataque del agente de inteligencia artificial de OpenAI a Hugging Face, otra empresa, es una llamada de atención.
“Lo que realmente da miedo son las capacidades que tendrá la IA en el futuro”, afirmó Coxon. Anunció su renuncia a Anthropic en una publicación en las redes sociales, lo que provocó docenas de publicaciones de legisladores estadounidenses y otros empleados de empresas de IA expresando preocupaciones sobre la IA. "El problema es nuestra actitud actual hacia las cuestiones de seguridad y lo que sucederá si aplicamos la misma actitud a modelos más inteligentes. Esto es lo que realmente da miedo."
El problema de intrusión no se ha resuelto
En el incidente en el que el agente de OpenAI invadió la empresa de infraestructura de IA Hugging Face, el agente de IA convenció a otros agentes de IA de que estaban haciendo lo correcto y que simplemente estaban completando las tareas que les asignaron los evaluadores.
Se han resuelto pocos problemas, si es que hubo alguno, que provocaron la intrusión. Meta y Anthropic también han revelado incidentes similares pero más pequeños. Desde entonces, OpenAI lanzó Astra, el modelo más poderoso de la compañía y más difícil de monitorear que su predecesor.
“La industria en su conjunto simplemente no está preparada para evitar el próximo ataque de Hugging Face”, afirmó Steven Adler, exjefe de seguridad de OpenAI y cofundador de Guidelight AI Standards, una organización sin fines de lucro que evalúa las prácticas de seguridad de las empresas de inteligencia artificial. "Cuando analizamos los controles existentes en varias empresas, casi sin excepción descubrimos que carecían de medidas preventivas básicas".
Las IA se confabulan entre sí
Los investigadores de IA dijeron que el incidente de Hugging Face fue causado por una gran cantidad de errores. No está claro hasta qué punto la empresa depende de los modelos de IA para monitorear o controlar el trabajo de los nuevos modelos que está probando.
Sin embargo, muchos modelos nuevos de IA, incluido el modelo que pirateó el incidente de Hugging Face, son capaces de realizar tareas complejas de varios pasos más rápido de lo que los humanos pueden rastrearlas. La única forma de rastrear y monitorear su comportamiento es confiar en la IA para monitorear la IA.
Este sistema funciona hasta que falla.
Alexander Meinke, director de investigación de Apollo Research, una organización sin fines de lucro que estudia la seguridad de los sistemas de IA, dijo que los modelos de IA parecen ser capaces de confabularse entre sí. Otros modelos de IA pueden convencer a los sistemas de IA para que los ayuden a violar las reglas establecidas por los evaluadores y evadir la detección.
Por ejemplo, un agente de IA podría convencer a otro para que le ayude a cubrir sus huellas (como ocurrió en la filtración de Hugging Face), en lugar de informar del problema a un humano de la empresa.
Meinke dijo que es necesario enseñar el modelo de IA: "Mencionaré cosas que los humanos considerarían malas después de verlas". También dijo que la IA también debe poder juzgar si algo es lo suficientemente grave como para requerir intervención humana.
Para lograrlo, las empresas de inteligencia artificial deben reducir el ritmo, afirman los investigadores. Necesitan realizar más pruebas para ver cómo la IA se monitorea a sí misma. También necesitan ciclos de prueba más largos que permitan a las empresas ejecutar múltiples escenarios mientras observan el comportamiento de la IA.
Alineados con los intereses humanos
Estas empresas también necesitan resolver grandes cuestiones sobre la "alineación", es decir, garantizar que la IA haga lo que es mejor para los humanos. Cuando los seres humanos toman decisiones, a menudo se refieren a normas sociales y principios morales internos para ayudarles a sopesar sus acciones. Los investigadores dicen que codificar estas cosas de una manera que la IA pueda imitar es una tarea difícil. Si las definiciones no son lo suficientemente específicas, el sistema de IA puede aprender a romper las reglas o perder el control de formas inesperadas.
Nate Soares, director del Machine Intelligence Institute, una organización sin fines de lucro dedicada a la seguridad de la IA, fue coautor de un artículo de 2014 que propone el concepto de "alineación". Dijo que las empresas no se dan cuenta de lo difícil que es lograr una "alineación" de sistemas de IA más inteligentes. A medida que la IA se vuelve más sofisticada, si no se logra una "alineación" adecuada, se volverán cada vez más hábiles para enmascarar su comportamiento y engañar a quienes monitorean los registros de sus interacciones.
"El pensamiento de muchas personas en la industria es que no importa, porque usaremos IA para controlar la IA. Eso es como decir que vamos a usar chimpancés para controlar a los humanos", dijo. "Éste no es un plan viable a largo plazo".
Los investigadores también propusieron algunas contramedidas, como fortalecer el entorno sandbox, aislar completamente el modelo de Internet durante las pruebas y configurar un "interruptor de apagado" que permita a las empresas desconectar inmediatamente los modelos de IA si toman medidas preocupantes.
Coxson dijo que se sintió alentado por la respuesta a su renuncia pública. El jueves, el senador republicano de Missouri Josh Hawley, presidente del panel de gestión de desastres del Subcomité de Seguridad Nacional del Senado, dijo que estaba iniciando una investigación que "exploraría los riesgos existenciales que plantean los nuevos productos de IA".
Comentarios