Resumen:
Un experimento realizado por un desarrollador muestra que conectar el iPhone 17 Pro Max a una MacBook Pro equipada con un chip M4 Pro a través de un software personalizado puede mejorar significativamente la eficiencia operativa del modelo local en lenguaje grande. Cuando se ejecuta el modelo Qwen3.8-27B, el rendimiento de precarga del sistema mejora hasta en un 44%.
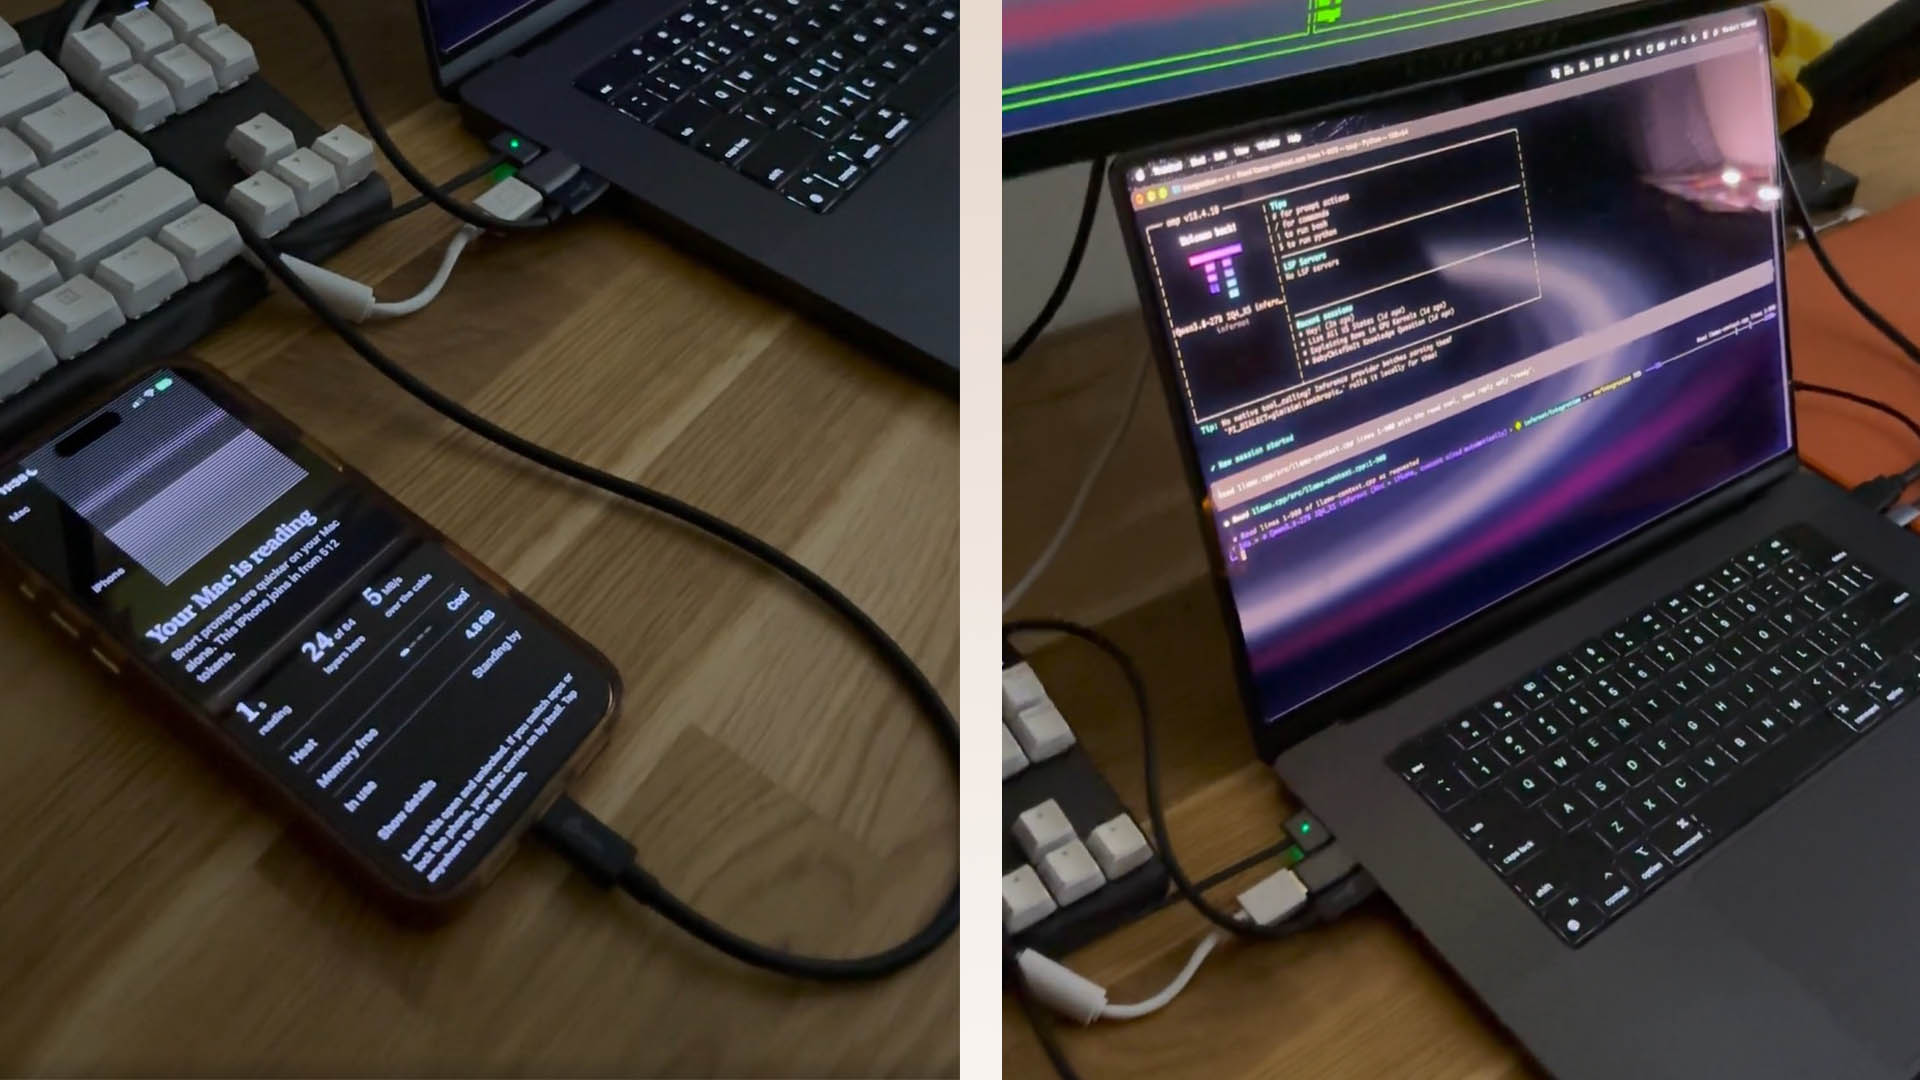
El trasfondo de este experimento es que los modelos de lenguajes grandes tienen requisitos extremadamente altos en memoria de video y capacidad de memoria del sistema. Aunque la MacBook Pro equipada con el chip M4 Pro tiene 24 GB de memoria unificada, todavía está limitada por la capacidad de la memoria y el tamaño de la ventana de contexto cuando se ejecuta un modelo grande con 27 mil millones de niveles de parámetros. Por lo tanto, los desarrolladores intentaron utilizar el iPhone 17 Pro Max como un nodo informático adicional para ejecutar modelos junto con MacBook Pro a través de la interfaz USB-C.
Según el plan anunciado por el desarrollador, la MacBook Pro es responsable de procesar las tareas informáticas desde la capa 1 hasta la capa 40 en cada lote de 256 tokens y transmite los datos de activación intermedia al iPhone en tiempo real. Posteriormente, el iPhone 17 Pro Max usa la GPU en el chip A19 Pro para continuar realizando operaciones de la capa 41 a la capa 64, mientras que la Mac comienza a procesar el siguiente lote de datos simultáneamente. A través de esta división del trabajo canalizada, dos dispositivos pueden participar en el proceso de inferencia del modelo al mismo tiempo.
Los resultados experimentales muestran que, en comparación con la ejecución del modelo solo en MacBook Pro, la velocidad de precarga mejora significativamente después de presentar el iPhone. En la ventana de contexto de 8K, la velocidad de procesamiento aumenta de 132 tokens por segundo a 177 tokens, un aumento del 35%; en la ventana de contexto de 16K, el rendimiento aumenta de 109 tokens por segundo a 157 tokens, un aumento del 44%; en el escenario de ventana de contexto de 32K, la velocidad de procesamiento aumenta de 101 tokens por segundo a 130 tokens, un aumento de aproximadamente el 29 %.
Además de la computación colaborativa GPU, el motor de red neuronal del chip A19 Pro también participa en algunas tareas. Los desarrolladores afirmaron que cada contexto histórico de 16K se convertirá en un modelo de red neuronal dedicado para su procesamiento. En la escala de contexto de 140.000 tokens, el tiempo de escritura de un único token se reduce de 279 milisegundos cuando se depende únicamente de la GPU a 176 milisegundos, lo que mejora aún más la eficiencia operativa en escenarios de contexto prolongado.
Sin embargo, esta solución no está exenta de limitaciones. Los desarrolladores señalaron que el iPhone ayuda principalmente a mejorar el rendimiento de la etapa de prellenado, mientras que en las tareas de generación de texto por debajo de 64K, la mayor parte del trabajo de razonamiento real todavía lo realiza principalmente Mac. Además, esta solución requiere soporte de software especialmente desarrollado y actualmente no es adecuada para su implementación directa por parte de usuarios comunes.
No obstante, este experimento demuestra el potencial de los dispositivos Apple de consumo para la informática local de IA. A medida que el rendimiento de los chips móviles siga mejorando, es posible que en el futuro se forme un sistema informático colaborativo más flexible entre teléfonos inteligentes, tabletas y computadoras personales, reduciendo así la dependencia de una configuración de hardware de un solo dispositivo para ejecutar grandes modelos de inteligencia artificial.
Comentarios