Resumen:
El desarrollador de Linux Osama Arif envió dos parches a la lista de correo del kernel destinados a reducir la contención de solicitudes cuando zswap carga páginas de intercambio. Zswap es el mecanismo de caché de compresión de Linux. Comprime las páginas que se van a intercambiar y las almacena temporalmente en la memoria. Si las páginas se pueden leer desde el caché de compresión, se puede reducir el acceso al dispositivo de intercambio, lo cual es especialmente útil para aliviar la presión de E/S del disco cuando la memoria es escasa.
El problema es que el código existente hace que las escrituras y lecturas comprimidas compartan solicitudes de compresión asincrónicas por CPU y bloqueos mutex. Si se adelanta una tarea de escritura de baja prioridad durante el período de bloqueo, es posible que también se obligue a esperar una tarea de lectura de alta prioridad. El primer parche establece solicitudes, objetos de espera y bloqueos mutex para compresión y descompresión respectivamente, de modo que la lectura ya no esté bloqueada por tareas de escritura; el segundo parche permite que el algoritmo de compresión de software síncrono utilice solicitudes en la pila para evitar aún más el bloqueo zswap. Los algoritmos que requieren procesamiento asincrónico o contexto de solicitud adicional aún usan solicitudes por CPU y bloqueos mutex.
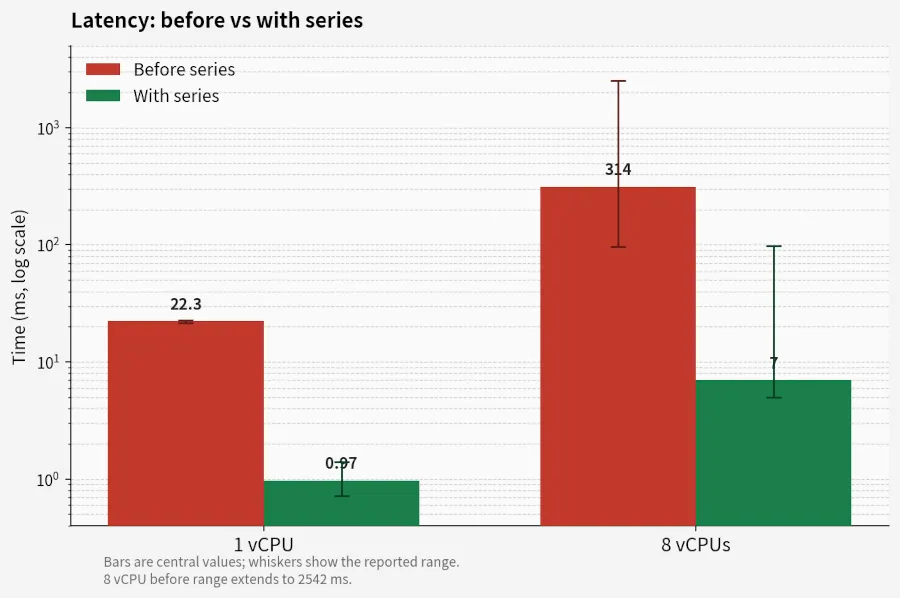
Las pruebas comparativas publicadas por el autor del parche muestran que en un único entorno de CPU virtual, la latencia de lectura más lenta media por ronda cayó de 22,3 milisegundos a 0,97 milisegundos; en un entorno de 8 CPU virtuales, cayó de 314 milisegundos a 7 milisegundos. Cada prueba se ejecutó durante 5 rondas, utilizando el compresor zstd, la máquina virtual y el disco de memoria como dispositivos de conmutación, y creando carga a través de diferentes tareas prioritarias; el número de lecturas superiores a 10 milisegundos también se redujo de 26 a 35 veces por ronda en un solo núcleo a cero, y en un entorno de múltiples núcleos se redujo de 3 a 18 veces por ronda hasta un máximo de una vez. Los autores afirman que los puntos de referencia y los programas de prueba se escriben con la ayuda de grandes modelos de lenguaje.
Estos números reflejan mejoras en la latencia de lectura en pruebas de esfuerzo específicas y no significan que todos los dispositivos Linux o cargas de trabajo diarias verán la misma aceleración general.
El parche aún se encuentra en la etapa de revisión de la lista de correo del kernel y aún no se ha fusionado con el kernel principal:
https://lore.kernel.org/lkml/
[correo electrónico protegido]
/
Comentarios