Resumen:
Un ingeniero de Google DeepMind demostró recientemente un experimento creativo: ejecutó con éxito el modelo de lenguaje pequeño Gemma 3 270M de Google directamente en una impresora láser de oficina común. El número de parámetros de este modelo es de unos 270 millones y la impresora utilizada en el experimento sólo tiene 14,1 MB de memoria disponible, pero aun así alcanza una velocidad de generación de más de 60 palabras por segundo.
Este resultado fue anunciado por el ingeniero Omar Sanseviero en la plataforma social X. Dijo que con la ayuda del proyecto Carbon, ejecutó el modelo Gemma directamente en la impresora de oficina. En todo el experimento no se modificó el firmware de la impresora ni se utilizó una placa informática externa u otro hardware. En cambio, se basó completamente en el lenguaje de descripción de páginas PostScript integrado en las impresoras láser modernas.
PostScript es un lenguaje de descripción de páginas completo de Turing que se utiliza comúnmente para controlar cómo las impresoras presentan texto, gráficos y diseño de página. El equipo experimental utilizó Carbon, un motor de inferencia Transformer liviano, y lo combinó con el modelo cuantificado Gemma 3 270M para generar finalmente un archivo de impresión PostScript original. Cuando la impresora ejecuta el archivo, en realidad completa el cálculo de inferencia del modelo de lenguaje dentro de su intérprete PostScript.
Para evitar quedarse sin memoria de la impresora durante la inferencia del modelo, el experimento adoptó tecnología de carga de flujo laminar dinámico. El sistema carga constantemente diferentes capas del modelo dentro y fuera de la memoria, manteniendo el uso máximo de memoria en sólo 14,1 MB, mientras que la impresora asigna 244,6 MB de memoria virtual PostScript. Aun así, la Gemma 3 270M alcanzó una velocidad de generación de 61,3 tokens/s en la CPU de la impresora.
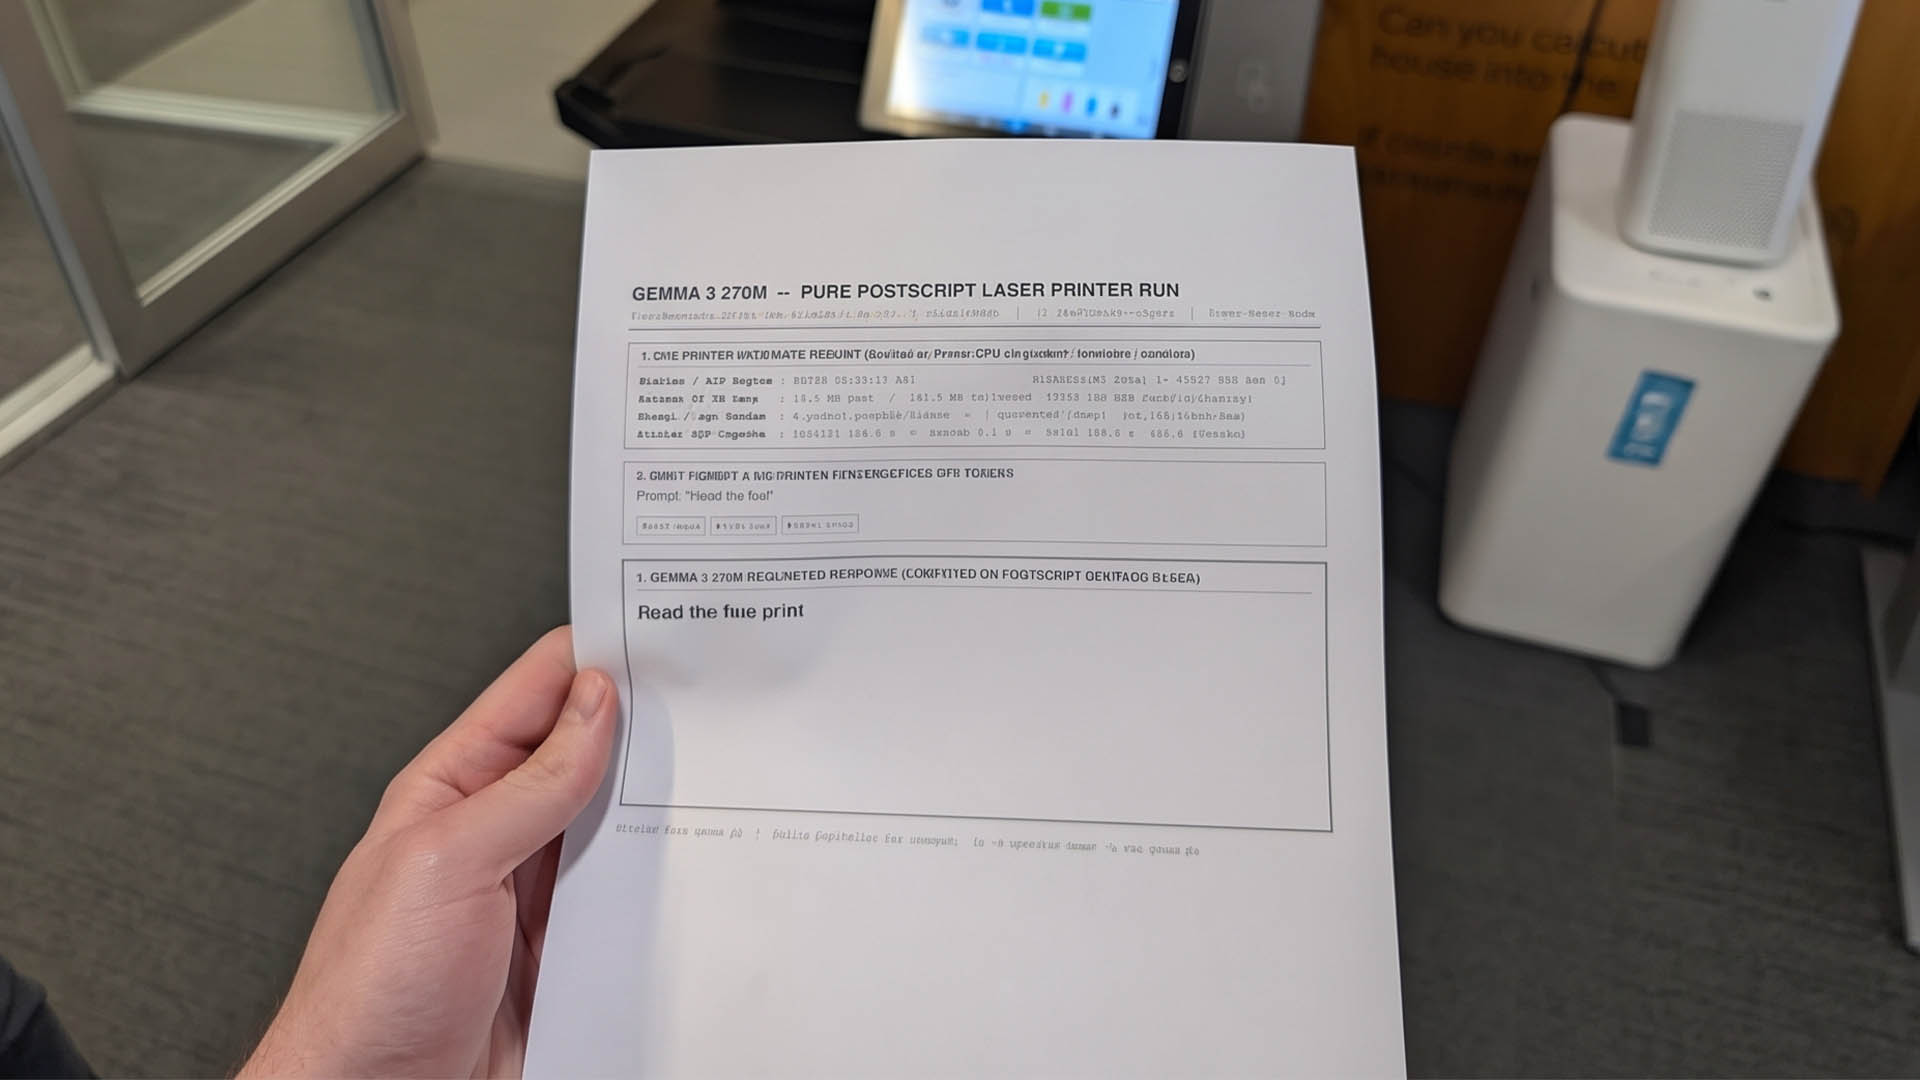
Según la información de hardware capturada en el experimento, esta impresora Ricoh realiza de forma nativa cálculos de transformador de 18 capas dentro del intérprete PostScript Nivel 3. Cuando se ingresa el mensaje "Lea la multa" que contiene solo cuatro tokens, la etapa de prellenado demora 184 segundos, mientras que el tiempo de decodificación para generar un solo token es de solo 0,1 segundos y todo el proceso de procesamiento totaliza 184 segundos.
Una vez completado el cálculo, la impresora finalmente imprime la respuesta de tres palabras "Lea la letra pequeña" directamente en el papel. Este resultado no sólo demuestra que el modelo realmente completa el razonamiento dentro de la impresora, sino que también muestra que el potencial del equipo de oficina diario a nivel de software supera con creces las expectativas de la gente. Aunque este modo de operación no es adecuado para entornos de producción reales, demuestra los límites de lo que es posible cuando se combinan pequeños modelos cuantitativos, motores de inferencia y capacidades de hardware existentes.
Comentarios