Resumen:
La controversia en torno a la legalidad de los datos de entrenamiento de inteligencia artificial generativa se ha vuelto a calentar recientemente. Un documento judicial revelado en la demanda por derechos de autor del New York Times muestra que un director de investigación senior de Microsoft describió una vez en una discusión interna que el método actual de entrenamiento de grandes modelos de lenguaje puede ser "el mayor robo de mano de obra en la historia de la humanidad". Declaraciones relacionadas han atraído una amplia atención en la industria.
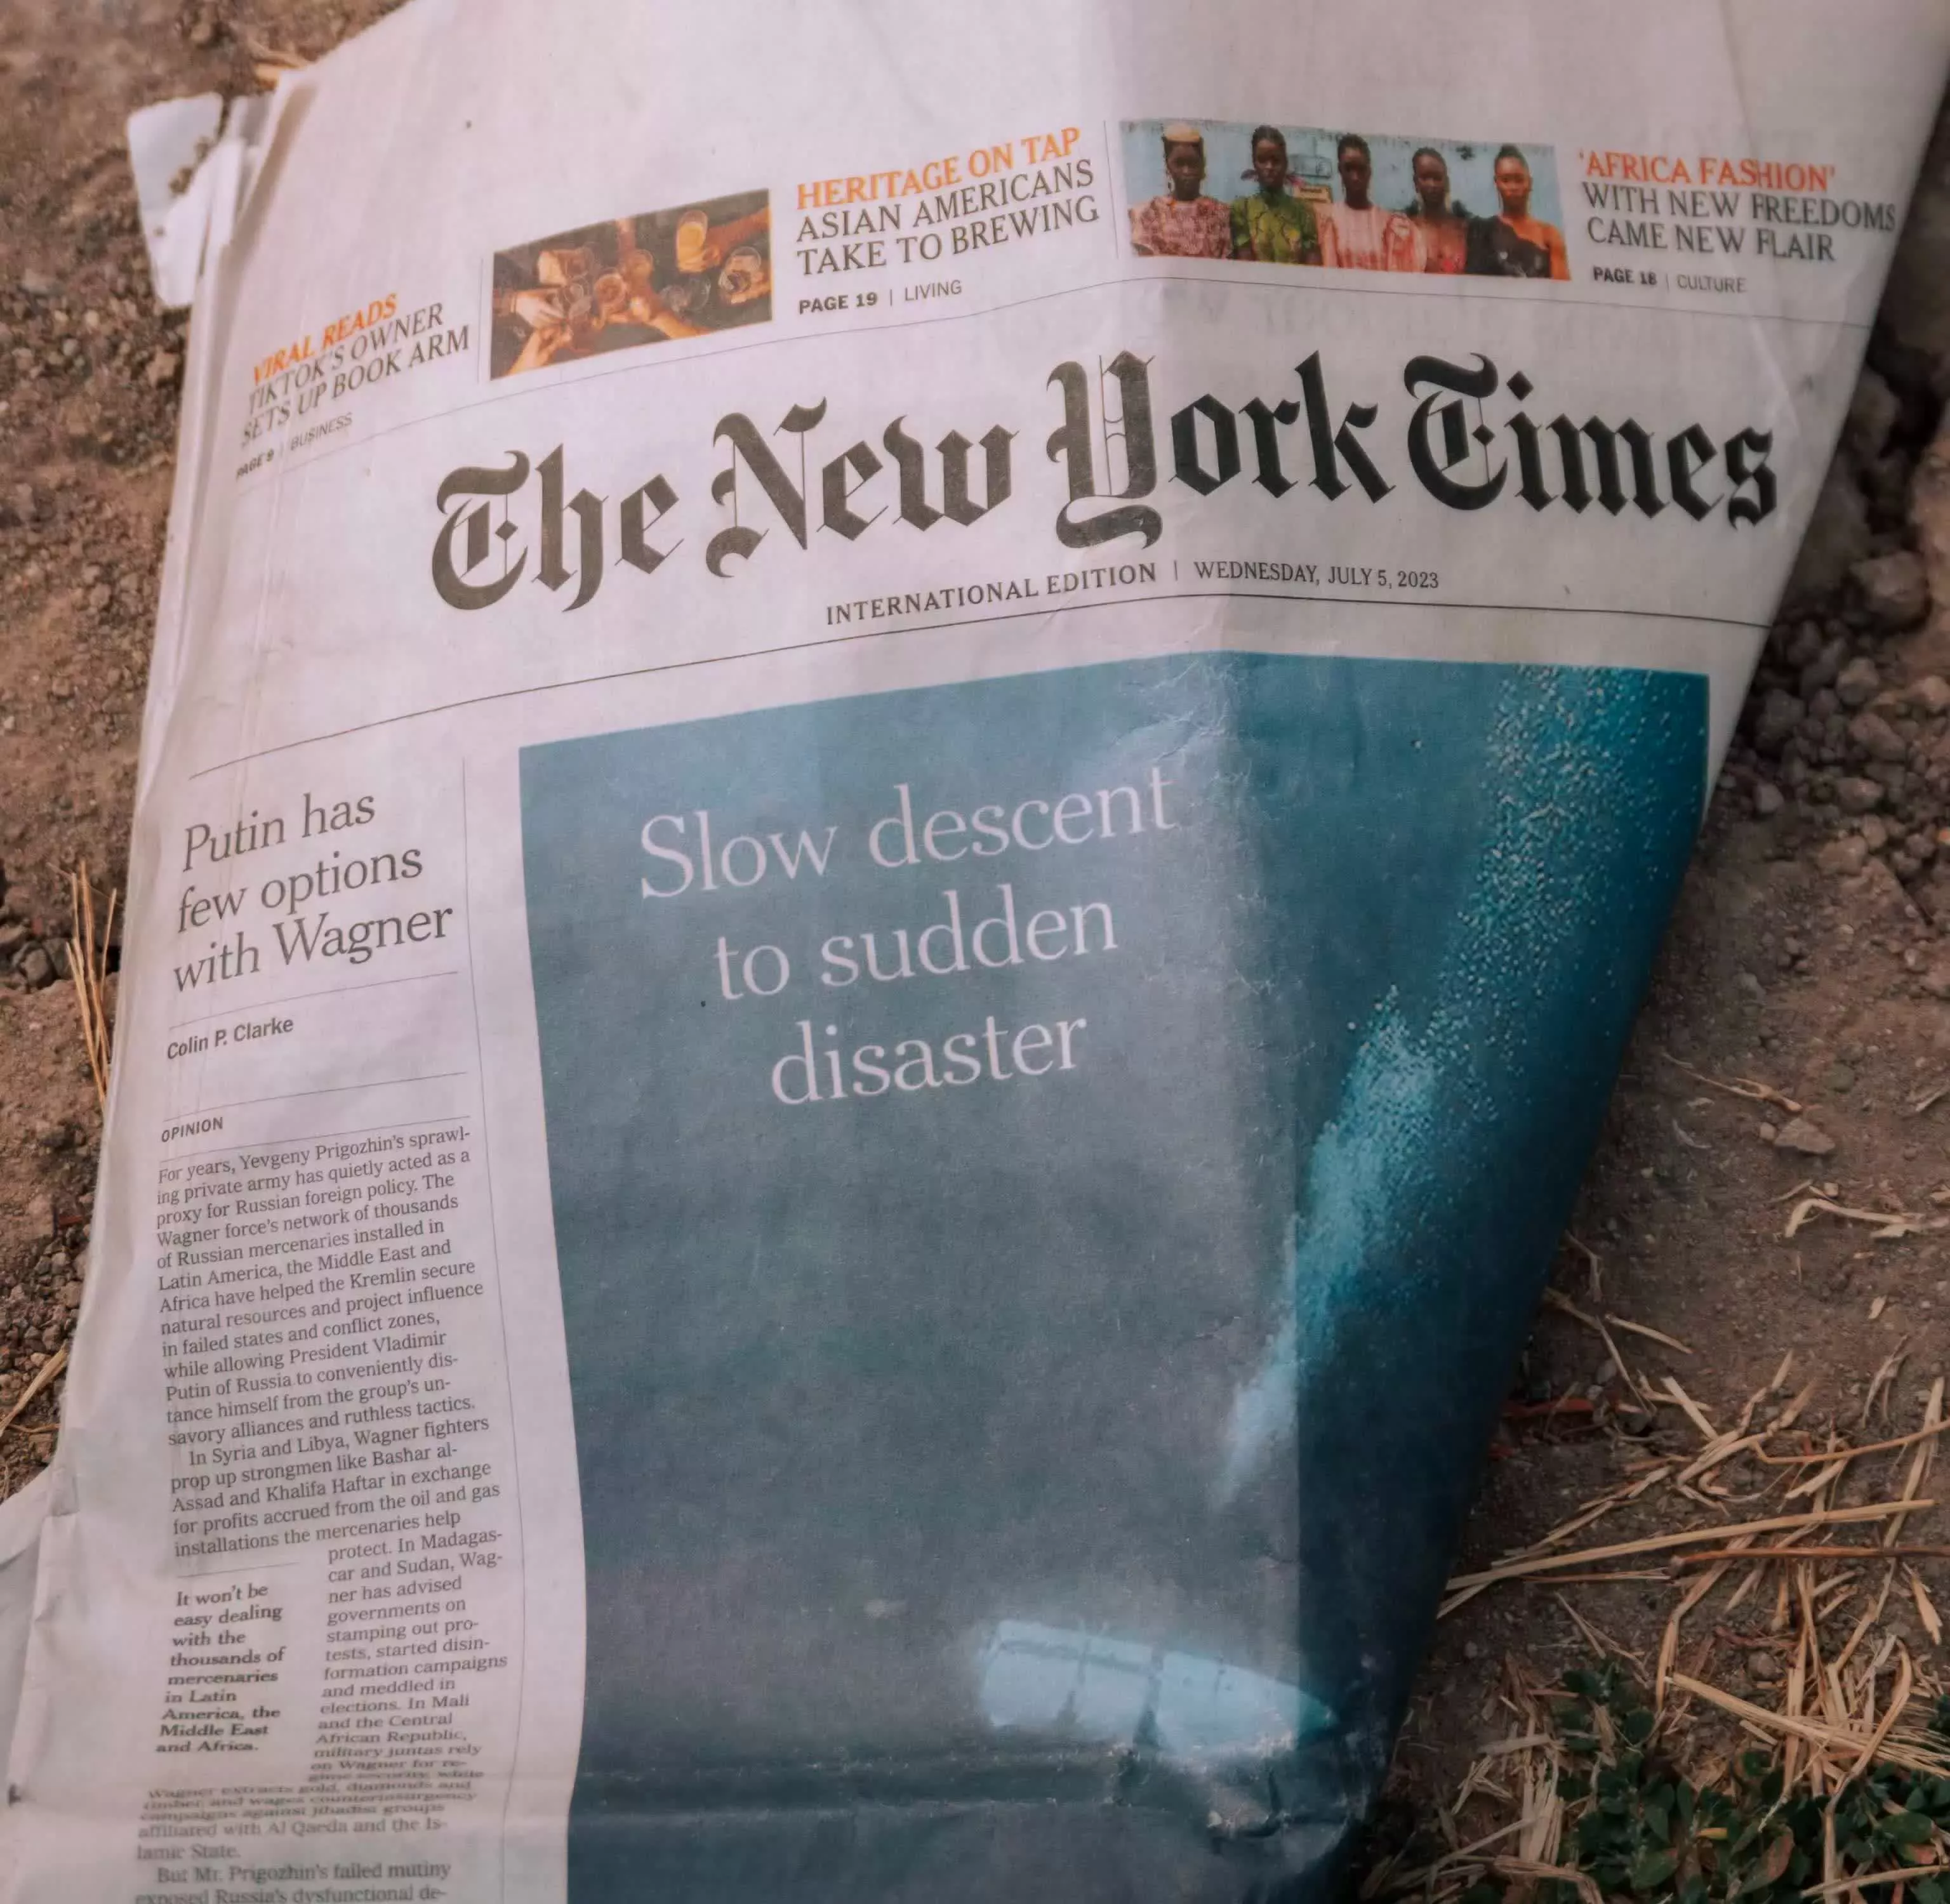
Los comentarios expuestos esta vez provinieron de Brent Hecht, director de ciencias aplicadas de Microsoft. Según los últimos documentos legales públicos, al discutir el uso de contenido masivo de Internet por parte de Microsoft, OpenAI y otras compañías de inteligencia artificial para entrenar modelos, Hecht una vez llamó a este proceso "un robo asombroso de escala sin precedentes" y afirmó además que este puede ser "el mayor robo de mano de obra en la historia de la humanidad".
Este contenido aparece en una demanda de derechos de autor presentada por The New York Times y otras publicaciones de noticias contra Microsoft y OpenAI. Los demandantes creen que las dos empresas utilizaron noticias y otros contenidos protegidos por derechos de autor para entrenar modelos de inteligencia artificial sin autorización y utilizarlos para desarrollar productos comerciales.
Microsoft y OpenAI siempre se han adherido a su postura de "uso justo". Las dos empresas creen que el proceso de formación del modelo es similar a la lectura de libros por parte de los estudiantes para adquirir conocimientos y está dentro del alcance del uso legítimo. También argumentan que el contenido generado por IA ha transformado lo suficiente el material original como para no constituir una copia directa.
Sin embargo, algunos registros de comunicación interna en los documentos recientemente revelados parecen contrastar claramente con esta posición pública.
Los documentos muestran que Hecht alguna vez creyó que si ganaban la demanda, las empresas involucradas podrían necesitar "burlarse completamente del concepto de uso legítimo". El demandante considera esta declaración como una prueba importante y la utiliza para cuestionar la lógica de defensa de los derechos de autor a la que las empresas de inteligencia artificial se han adherido durante mucho tiempo.
Al mismo tiempo, el documento también revela algunas discusiones internas de OpenAI. Uno de los registros muestra al cofundador de OpenAI, Greg Brockman, admitiendo que cuando el modelo estuvo expuesto al contenido del New York Times, ChatGPT pudo predecir y continuar oraciones en artículos relacionados. Los demandantes utilizan este tipo de contenido para demostrar que el modelo tiene la capacidad de reproducir el trabajo original, en lugar de simplemente abstraer la información aprendida.
Los documentos de la demanda también revelaron que las preocupaciones de Hecht sobre el desarrollo a largo plazo de la industria de la inteligencia artificial no se limitan a la cuestión de los derechos de autor en sí. Una vez propuso el concepto del llamado "bucle apocalíptico" en otro documento de presentación interno.
Siguiendo esta lógica, los motores de respuesta de inteligencia artificial están reduciendo gradualmente la necesidad de los usuarios de visitar sitios web de noticias, lo que resulta en una disminución en el tráfico de medios y en los ingresos comerciales. A medida que más y más organizaciones de producción de contenidos pierdan su viabilidad, también disminuirán las fuentes de información de alta calidad para que los sistemas de inteligencia artificial aprendan en el futuro, lo que en última instancia dañará el modelo y todo el ecosistema de Internet.
Señaló en documentos internos que es extremadamente raro que un producto amenace la base económica de sus proveedores clave, pero la industria de la inteligencia artificial se encuentra actualmente en esta situación. Dado que las organizaciones de noticias y los creadores de contenido son fuentes importantes de información para los modelos de IA, cuando estos grupos se ven afectados, toda la cadena de suministro de contenido está en riesgo.
El demandante también citó datos internos de Microsoft y afirmó que los sistemas de respuesta de inteligencia artificial como Copilot han tenido un impacto significativo en el tráfico de algunos sitios web de noticias. En algunos casos, la proporción de usuarios que hacen clic para ingresar a la página del New York Times se redujo en más del 90% en comparación con los resultados de búsqueda tradicionales.
De hecho, la disputa sobre la fuente de los datos de entrenamiento se ha convertido en uno de los desafíos legales más importantes en la industria actual de la inteligencia artificial.
OpenAI ha declarado públicamente anteriormente que es una tarea casi imposible entrenar sistemas avanzados de inteligencia artificial sin ningún contacto con contenido protegido por derechos de autor. El ex ejecutivo de Meta, Nick Clegg, también hizo una declaración similar, creyendo que si se siguen estrictamente las reglas tradicionales de derechos de autor, será difícil mantener el desarrollo de muchos sistemas de inteligencia artificial actuales.
Al mismo tiempo, muchas empresas, incluidas Microsoft, Meta y otras empresas de tecnología, continúan enfrentando críticas del mundo exterior debido a problemas con la fuente de datos de capacitación. Algunas empresas han sido acusadas de utilizar contenido de usuario, bibliotecas de códigos, artículos, imágenes y otros recursos en línea para entrenar modelos, a menudo sin autorización explícita o compensación de los creadores correspondientes.
A medida que continúa la demanda del New York Times, cada vez se hacen públicos más documentos internos. Los conocedores de la industria creen que estos materiales no solo están relacionados con el resultado del litigio de derechos de autor que enfrentan Microsoft y OpenAI, sino que también pueden afectar la futura dirección regulatoria global en materia de capacitación en inteligencia artificial, protección de la propiedad intelectual y la distribución de derechos e intereses de los productores de contenido.
Actualmente, los casos relevantes aún están bajo revisión. Independientemente del veredicto final, esta disputa legal sobre la legalidad del entrenamiento en inteligencia artificial se está convirtiendo en un hito importante en la determinación de las futuras reglas de desarrollo de la industria de la IA.
Comentarios