
Resumen:
Para los usuarios de Windows que desean ejecutar modelos de inteligencia artificial en sus propias computadoras, siempre ha existido un cierto umbral para instalar y configurar herramientas de inteligencia artificial locales. Los usuarios no sólo necesitan encontrar archivos de modelo adecuados, sino también considerar cuestiones como el formato del modelo, la compatibilidad del hardware, la instalación del motor de inferencia y los parámetros de inicio. Hoy, la aplicación de código abierto Llama para Windows, lanzada por desarrolladores relacionados con los equipos Hugging Face y llama.cpp, intenta simplificar este proceso en unas pocas operaciones simples, permitiendo a los usuarios descargar y ejecutar modelos de lenguaje local de gran tamaño en computadoras con Windows sin usar la línea de comando.
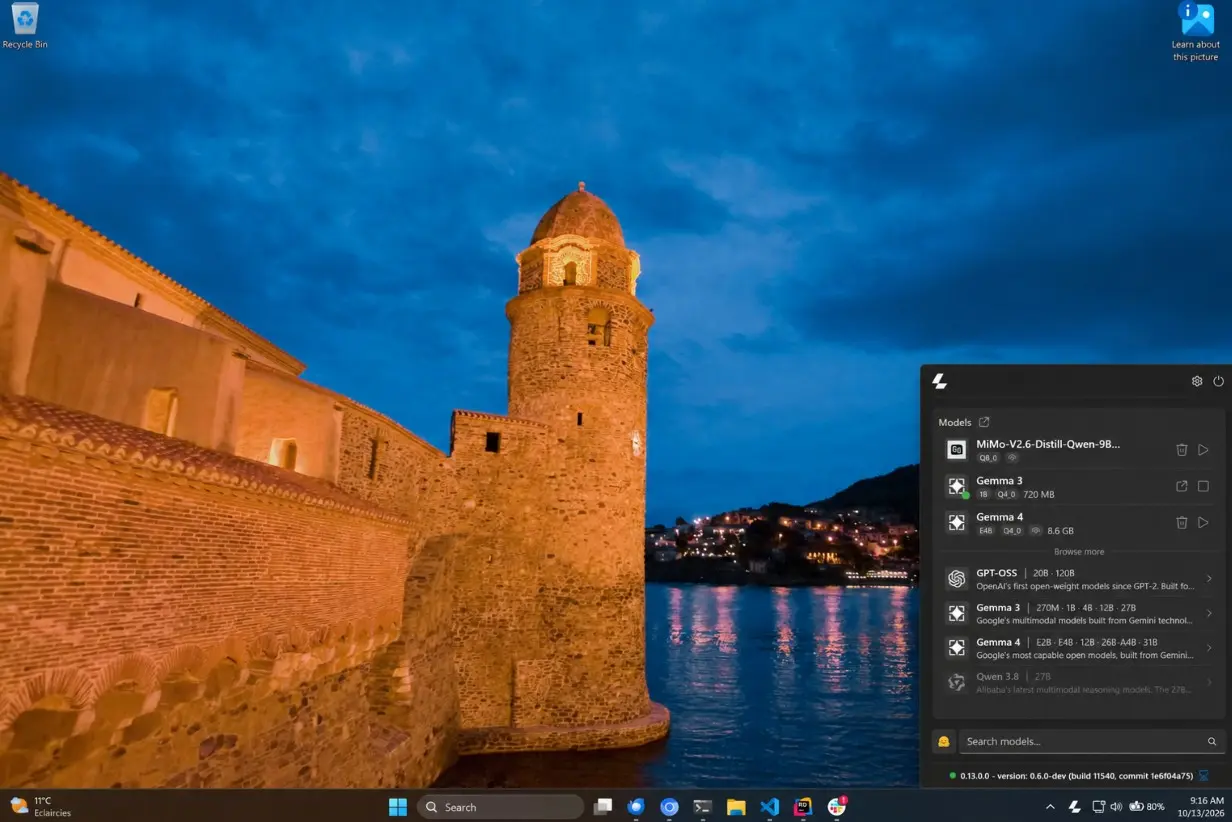
Llama para Windows se lanzará en octubre de 2026 y es la contraparte para Windows de la versión macOS de la aplicación Llama. Es una aplicación de Windows 11 gratuita y de código abierto basada en la tecnología WinUI 3 de Microsoft y se ejecuta principalmente en el área de notificación del sistema. Una vez que los usuarios lo instalan, pueden abrir el panel de control a través del ícono de la aplicación en el área de notificación de la barra de tareas, sin tener que mantener una ventana independiente como el software tradicional.
La característica más importante de esta aplicación es su capacidad para conectarse directamente al almacén de modelos de Hugging Face. Hugging Face es actualmente una importante plataforma de alojamiento de modelos de inteligencia artificial de código abierto, que reúne una gran cantidad de modelos y sus versiones derivadas de diferentes equipos de desarrollo. En el pasado, los usuarios generalmente tenían que encontrar un archivo de modelo adecuado por sí mismos, determinar si el formato del archivo era correcto, luego descargar la versión correspondiente e iniciarla a través del motor de inferencia. Para el usuario medio que no está familiarizado con la tecnología de inteligencia artificial, este proceso puede resultar bastante tedioso.
Llama para Windows proporciona una lista de modelos recomendados dentro de la aplicación. Los usuarios pueden verificar el tamaño de los parámetros del modelo, el espacio en disco y si admite funciones visuales como la comprensión de imágenes, y luego seleccionar un modelo adecuado para descargar en su computadora. Después de seleccionar el modelo, simplemente haga clic en la opción correspondiente y la aplicación comenzará a descargarse automáticamente y mostrará el progreso de la descarga.
Esta herramienta utiliza principalmente modelos de cuantificación en formato GGUF. GGUF está impulsado por el ecosistema llama.cpp y se ha convertido en uno de los formatos de archivo de modelo más utilizados para ejecutar localmente modelos de lenguaje grande de código abierto. La tecnología de cuantificación puede reducir el espacio de almacenamiento y la memoria de ejecución requerida por el modelo al reducir la precisión numérica de los parámetros del modelo, brindando a los modelos que originalmente requieren configuraciones de hardware más altas la oportunidad de ejecutarse en computadoras personales comunes. Sin embargo, la cuantificación generalmente también trae consigo un cierto grado de pérdida de precisión, y el impacto específico depende del modelo, el método de cuantificación y el escenario de uso.
En términos de gestión de modelos, Llama para Windows enumerará los modelos que se han descargado en la computadora. Los usuarios pueden cargar o descargar directamente los modelos y hablar con los modelos a través de la interfaz web incorporada. La aplicación también muestra el estado de ejecución actual del modelo, lo que permite a los usuarios saber si el modelo se ha iniciado sin tener que verificar manualmente el proceso en segundo plano.
La aplicación también puede manejar automáticamente el motor de inferencia subyacente. Llama para Windows utiliza llama.cpp como componente principal de ejecución. Si ya existe un servicio llama.cpp utilizable en el sistema, la aplicación puede conectarse al servicio existente; si no está instalado, se puede instalar a través del instalador oficial. Todo el proceso no requiere derechos de administrador y los usuarios no tienen que compilar el código fuente ellos mismos ni configurar manualmente parámetros de inicio complejos.
Este diseño reduce la barrera de entrada para la IA local, pero no significa que todos los modelos puedan funcionar sin problemas en cualquier computadora. El rendimiento real del modelo aún depende del procesador, la memoria, la tarjeta gráfica, la capacidad de la memoria de video y el tamaño del modelo en sí. Los modelos con tamaños de parámetros más pequeños generalmente son más fáciles de ejecutar en una computadora normal, mientras que los modelos más grandes pueden requerir mucha memoria o incluso una estación de trabajo con una tarjeta gráfica de alto rendimiento para lograr buenos tiempos de respuesta.
Llama para Windows también proporciona una interfaz de chat similar a un iniciador rápido a nivel de sistema. Los usuarios pueden presionar la tecla de acceso directo Alt+Espacio en otras aplicaciones para abrir la ventana de chat flotante e interactuar directamente con el modelo cargado actualmente. La ventana adopta un diseño liviano y la conversación no se cerrará inmediatamente después de ocultarse y podrá continuar usándose cuando se vuelva a llamar. Esto significa que los usuarios no tienen que cambiar repetidamente a aplicaciones de IA independientes cuando escriben documentos, navegan por la web o escriben código.
Además de la función de chat para usuarios normales, el software también tiene en cuenta las necesidades de los desarrolladores. La aplicación puede iniciar un servidor local basado en llama.cpp en la máquina local y proporcionar servicios modelo a través de una API compatible con la interfaz OpenAI. La dirección de servicio predeterminada es
http://localhost:9931. Los desarrolladores pueden hacer que sus scripts, aplicaciones o agentes de IA llamen a modelos locales sin tener que enviar todas las solicitudes a servicios remotos en la nube.
Debido a que la interfaz es compatible con la API de OpenAI, algunas herramientas desarrolladas originalmente para la interfaz OpenAI pueden tener la oportunidad de acceder a modelos que se ejecutan localmente simplemente ajustando la dirección del servicio y las configuraciones relacionadas. Sin embargo, la compatibilidad de la interfaz no significa que todas las funciones sean completamente consistentes. Si se puede utilizar aún depende de las capacidades API requeridas por el cliente y de si el modelo cargado admite las funciones correspondientes.
Esto también convierte a Llama para Windows no solo en una herramienta de chat local, sino también en una plataforma que ejecuta IA en computadoras personales. Varias aplicaciones pueden compartir el mismo archivo de modelo y los desarrolladores no necesitan descargar un modelo separado para cada programa, lo que reduce la ocupación repetida de espacio en disco. Esta arquitectura tiene cierto valor práctico para los usuarios que desean crear asistentes de programación, herramientas de análisis de documentos u otras aplicaciones de IA localmente.
En términos de privacidad, la principal ventaja de ejecutar modelos localmente es que el proceso de inferencia no tiene que depender de servicios remotos de IA. Según la descripción del proyecto, las palabras de aviso ingresadas por el usuario y la inferencia del modelo se realizan de forma nativa, y la aplicación no recopila telemetría, analiza eventos ni genera identificadores de instalación especializados. Sin embargo, los usuarios aún necesitan conectarse a Internet para descargar archivos de modelos y obtener actualizaciones de software. La descripción del proyecto también menciona que estas solicitudes de red llevarán una identificación de Agente de Usuario estándar que contiene información como la versión de software, la versión de Windows y la arquitectura del procesador. Por lo tanto, la llamada operación local no significa que todo el proceso de instalación y mantenimiento no requiera ninguna red, sino que la inferencia del modelo y el procesamiento rápido de textos pueden permanecer localmente.
La compatibilidad de hardware también es un punto central de esta aplicación. Llama para Windows es compatible con las plataformas x64 y ARM64 de Windows 11 y proporciona soporte nativo para dispositivos Windows en Arm. Esto es especialmente importante para las computadoras portátiles con Windows equipadas con procesadores Arm, porque algunas herramientas de inteligencia artificial locales se desarrollaron principalmente para computadoras x86 tradicionales en el pasado y es posible que deban depender de la simulación que se ejecuta en dispositivos Arm o carezcan de los componentes precompilados correspondientes.
El proyecto también mencionó la compatibilidad con la plataforma NVIDIA RTX Spark. La plataforma está orientada a aplicaciones informáticas de IA locales y puede proporcionar otra opción de hardware para los usuarios que desean ejecutar modelos más grandes en un entorno de escritorio. Sin embargo, el hecho de que el software sea compatible con una determinada plataforma no significa que todos los modelos puedan lograr un rendimiento ideal. Los resultados operativos específicos aún dependen del tamaño del modelo, la capacidad de memoria y la configuración de inferencia.
Llama para Windows se puede obtener a través del sitio web oficial de Llama, o puede descargar el paquete de instalación correspondiente desde la página de lanzamiento de GitHub del proyecto. Una vez instalada, los usuarios pueden abrir la aplicación, seleccionar un modelo, esperar a que se complete la descarga y luego comenzar a usarla a través de una ventana de chat flotante o una interfaz web. Cabe señalar que la aplicación es actualmente para Windows 11 y no incluye Windows 10 como plataforma compatible.
En general, Llama para Windows no reinventa la tecnología en ejecución de modelos de lenguaje locales grandes, sino que integra los pasos originalmente dispersos en almacenes de modelos, motores de inferencia y herramientas de línea de comandos en una interfaz liviana. Su mayor valor radica en reducir el umbral de uso y al mismo tiempo conservar capacidades de escalabilidad, como las API locales y los flujos de trabajo de los desarrolladores.
A medida que el modelo de código abierto continúa desarrollándose, ejecutar la IA localmente se está transformando gradualmente de un proyecto que requiere cierta experiencia técnica a un escenario de aplicación que los usuarios comunes de computadoras pueden probar. Que Llama para Windows pueda convertirse en una herramienta convencional depende de su estabilidad, el rango de soporte del modelo y la experiencia de ejecución real, pero al menos lo hace más fácil para los usuarios de Windows: pueden comenzar a explorar la ejecución de modelos de IA en sus propias computadoras sin tener que aprender primero operaciones complejas de línea de comandos.
Dirección de descarga:
https://llama.app/download/windows
https://github.com/ggml-org/Llama-Windows
Comentarios