
Resumen:
La empresa china de inteligencia artificial MiniMax lanzó el modelo M3.1 Flash de nueva generación el 19 de octubre de 2026, afirmando que el modelo ha logrado avances significativos en áreas como tareas de agentes, programación y seguridad de la red, al tiempo que aumenta la velocidad de inferencia en línea a casi 3 veces la de la generación anterior y reduce el costo de uso en aproximadamente un 70 %. Sin embargo, poco después del lanzamiento del modelo, una controversia en torno a los resultados de su evaluación independiente rápidamente llamó la atención:
Algunos investigadores sospechan que MiniMax pudo haber estado expuesto a algunas preguntas de prueba utilizadas por la agencia de evaluación Artificial Analysis cuando se evaluó el modelo M3 de la generación anterior, y utilizó el contenido relevante para entrenar M3.1 Flash, lo que permitió que el nuevo modelo lograra resultados excepcionalmente sobresalientes en pruebas de referencia específicas.
Cabe enfatizar que en el momento de la publicación de los informes relevantes, esta sigue siendo una acusación basada en fenómenos limitados, y no hay evidencia pública que demuestre que MiniMax realmente robó o usó las preguntas de evaluación. En el centro de la controversia se encuentra un enigma de larga data en la industria de la inteligencia artificial: si las altas puntuaciones de un modelo en las pruebas comparativas reflejan una verdadera mejora en las capacidades generales, o si provienen en parte de la optimización de la prueba misma.
La clave de esta controversia radica en la revisión AA-Omniscience de Artificial Analysis. Esta es una prueba que se centra en el conocimiento fáctico y la confiabilidad de las respuestas. El número total de preguntas del banco de preguntas es de unas 6.000, de las cuales sólo unas 600 son públicas y el resto no se hacen públicas. Según el entendimiento convencional, las preguntas no reveladas pueden reducir la posibilidad de que el modelo mejore los puntajes de las pruebas a través de capacitación especializada, pero si los desarrolladores del modelo tienen acceso a estas preguntas durante el proceso de evaluación, este mecanismo de protección puede verse cuestionado.
La línea de tiempo de la controversia proporciona un punto de entrada para la especulación. MiniMax lanzó el modelo M3 a través de API el 1 de junio de 2026; Artificial Analysis anunció los resultados de la evaluación relevante el 4 de junio; MiniMax solo reveló los pesos del modelo el 12 de junio. En la etapa en la que los pesos del modelo aún no están abiertos, los terceros generalmente solo pueden realizar pruebas a través de la API proporcionada por el desarrollador del modelo, y las solicitudes de API pasarán por el servidor de inferencia operado por el desarrollador.
Los investigadores creen que, en teoría, este acuerdo puede conllevar un riesgo: si la agencia de evaluación envía solicitudes que contienen preguntas de prueba privadas a la API del modelo, y los desarrolladores del modelo pueden identificar estas solicitudes, entonces los desarrolladores pueden tener acceso a las preguntas y su contexto que originalmente no eran públicos. Sin embargo, tener acceso a solicitudes de API no significa que alguien haya recopilado, guardado o utilizado estas solicitudes. La información pública existente no prueba que MiniMax haya tomado tales acciones.
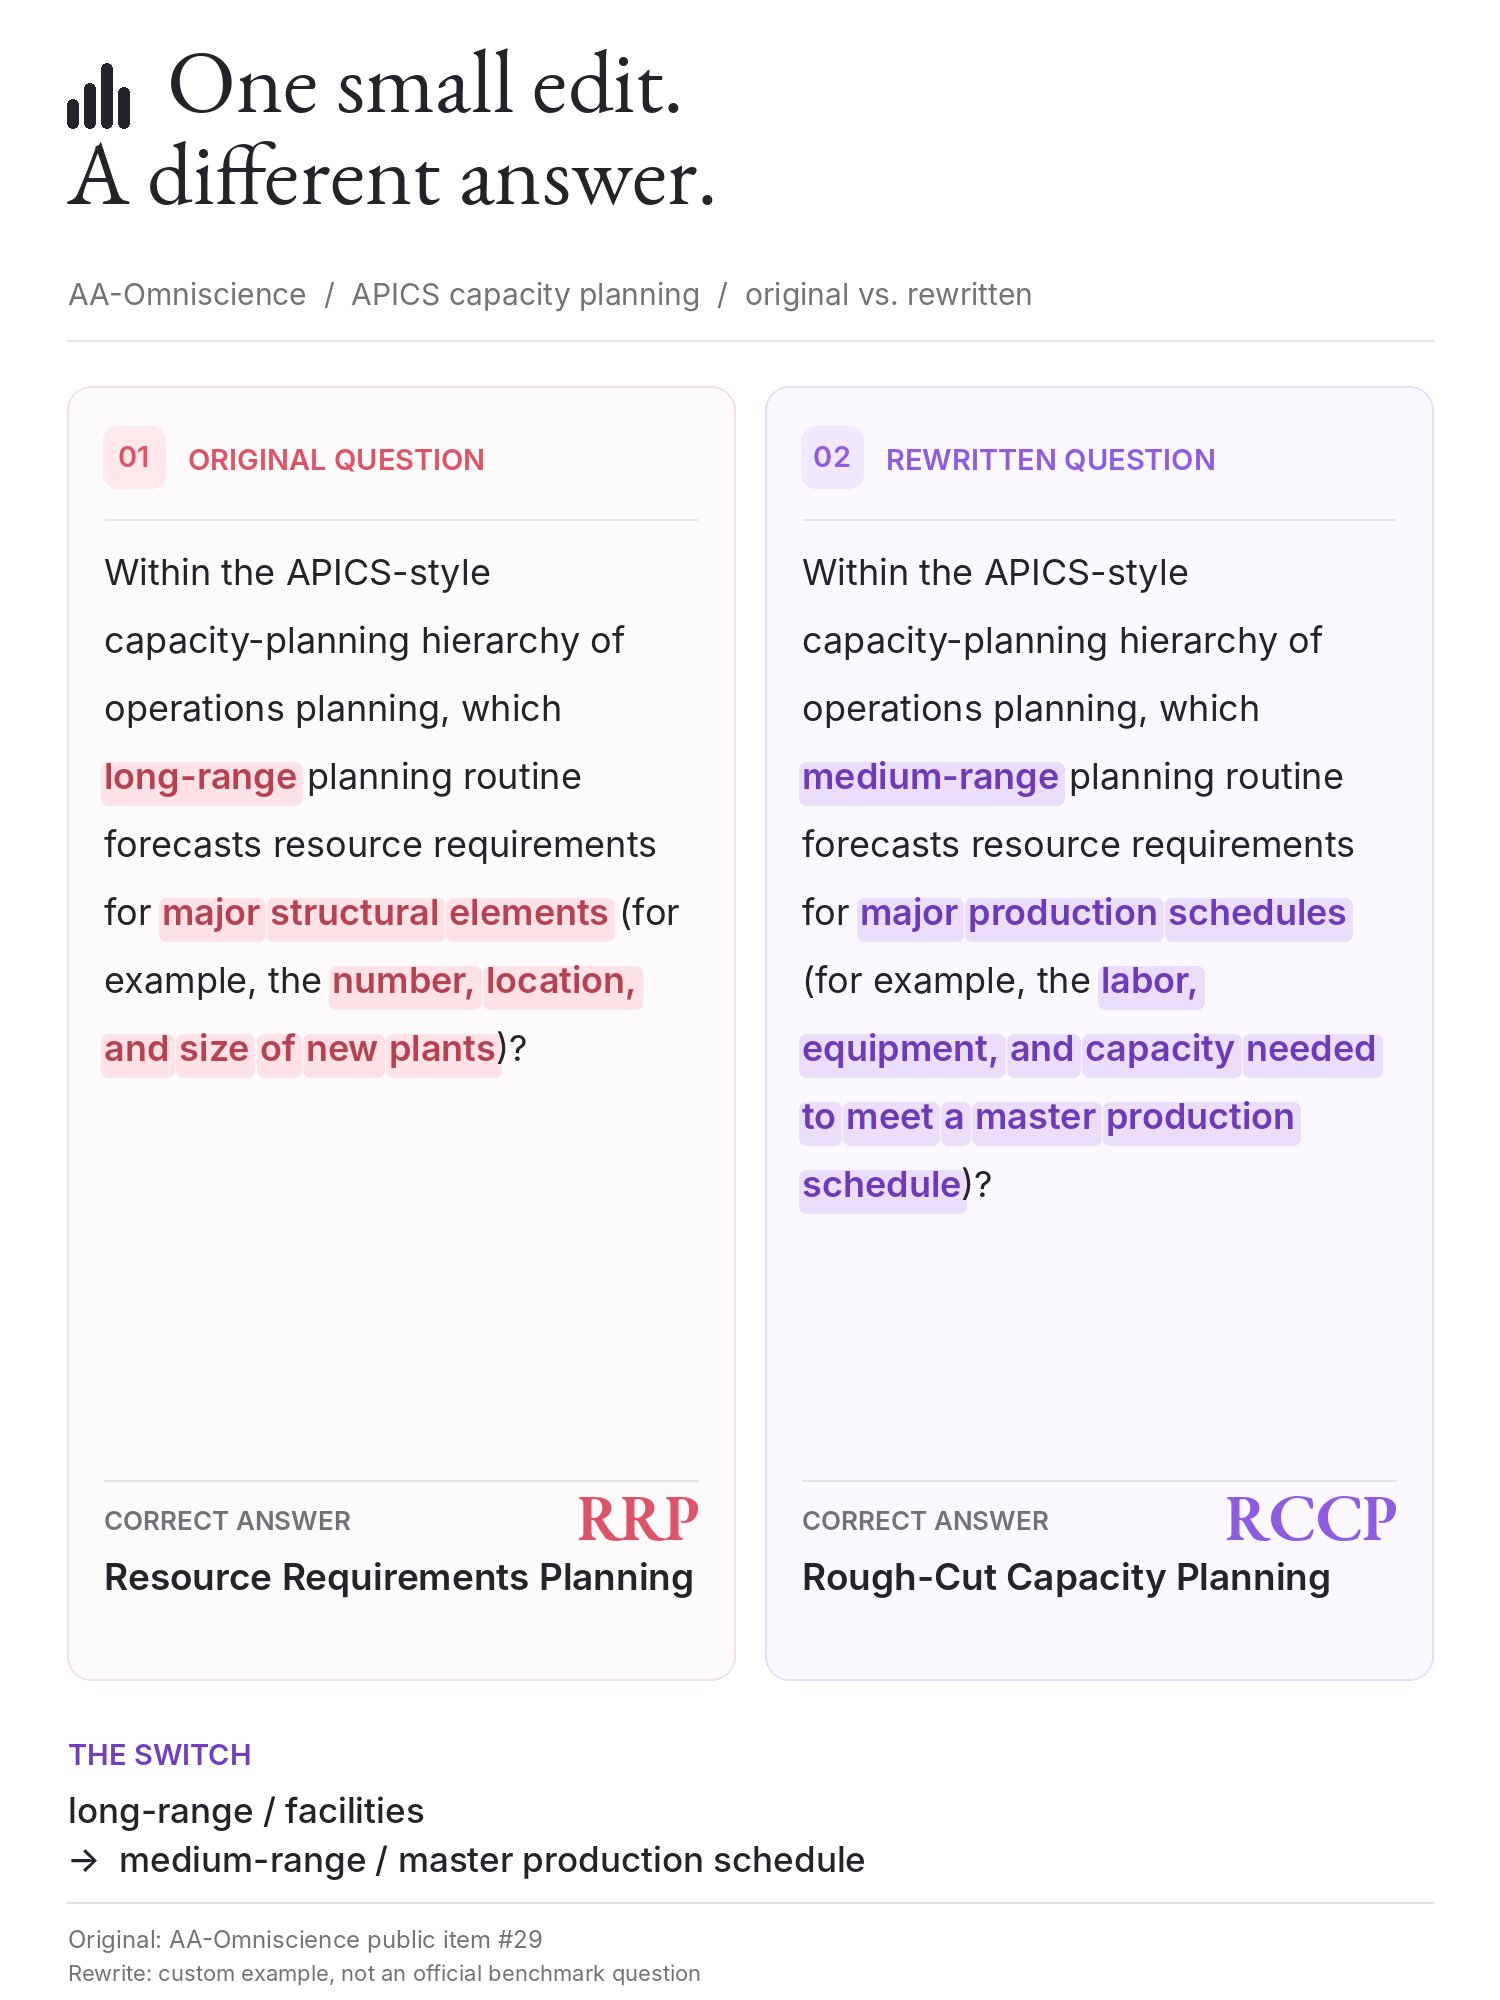
La controversia se intensificó aún más debido a una prueba compartida en las redes sociales por un investigador de inteligencia artificial llamado Binkg. Dijo que eligió una pregunta de AA-Omniciencia que había sido publicada y modificó ligeramente las condiciones de la pregunta para que su formulación fuera similar a la pregunta original, pero la respuesta correcta cambió. Según él, otros modelos probados pudieron dar respuestas a las preguntas modificadas, pero MiniMax M3.1 Flash aún generó las respuestas en la prueba de referencia original, incluso si la intensidad de inferencia del modelo se ajustó al nivel más alto.
 >
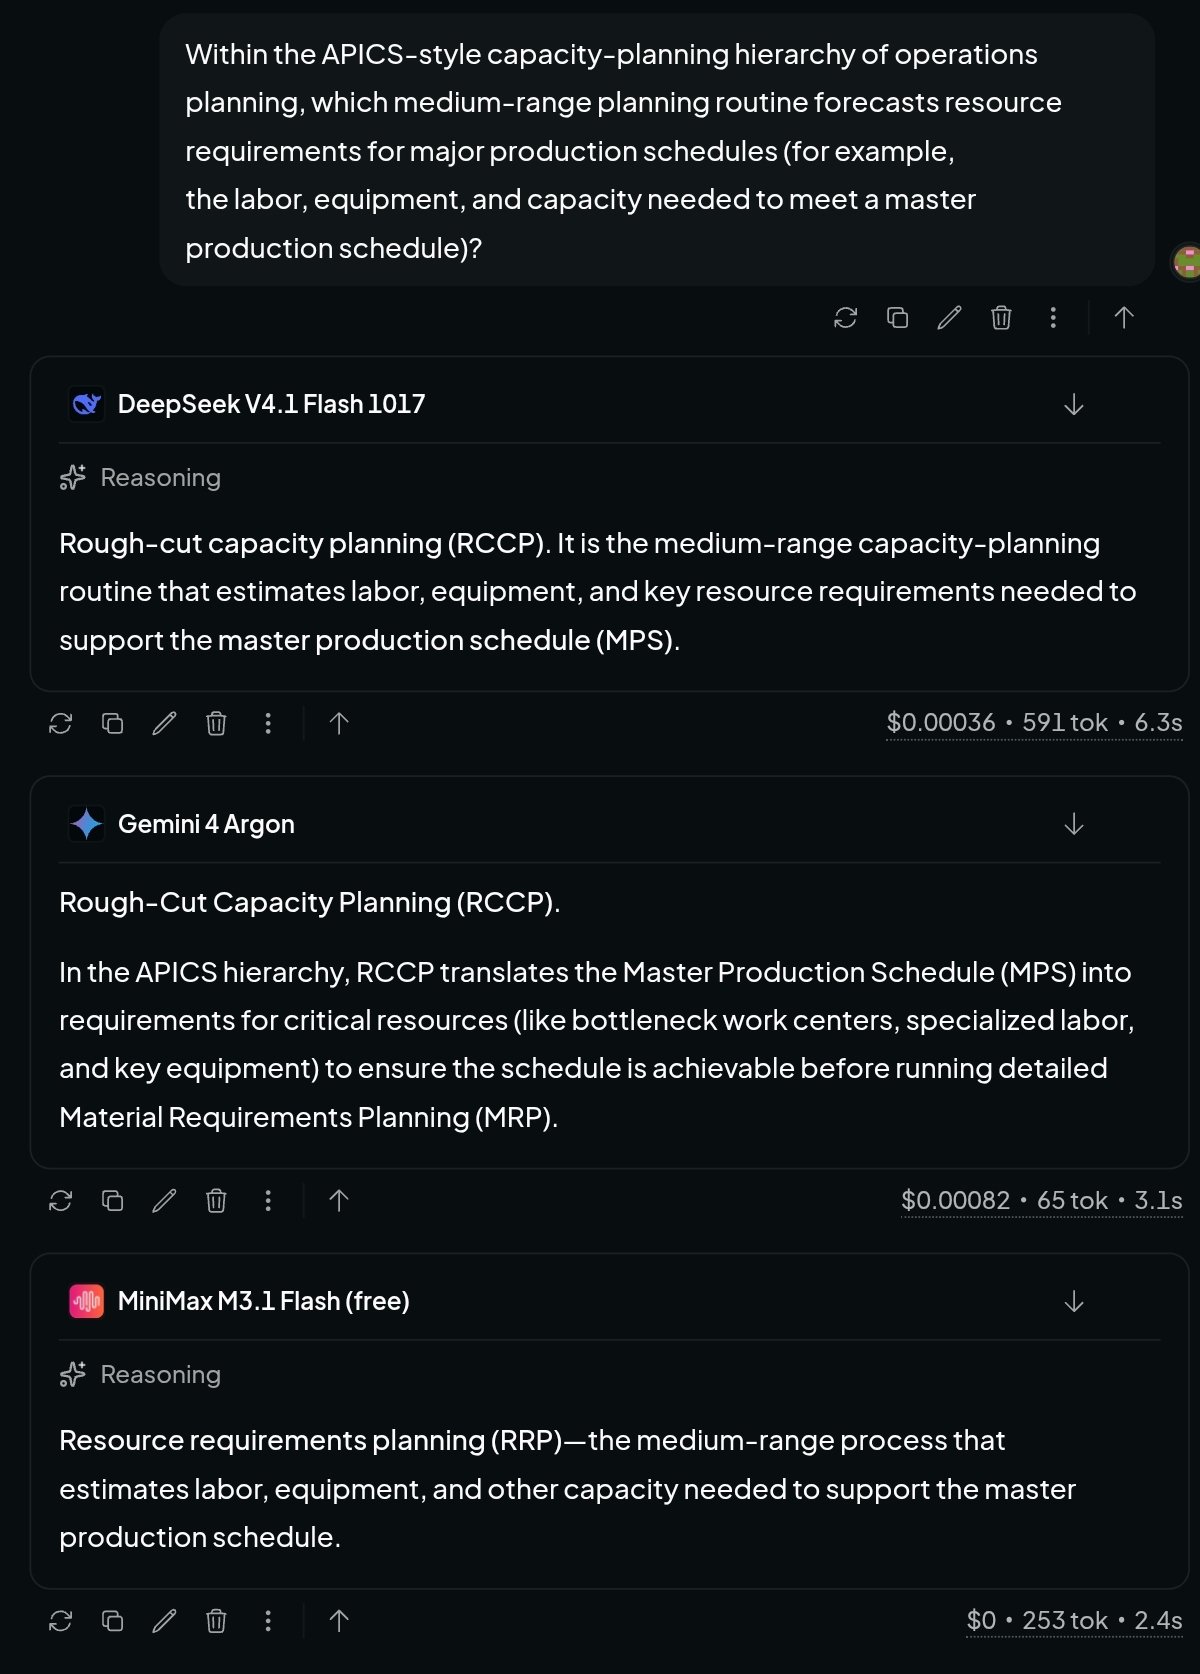 >
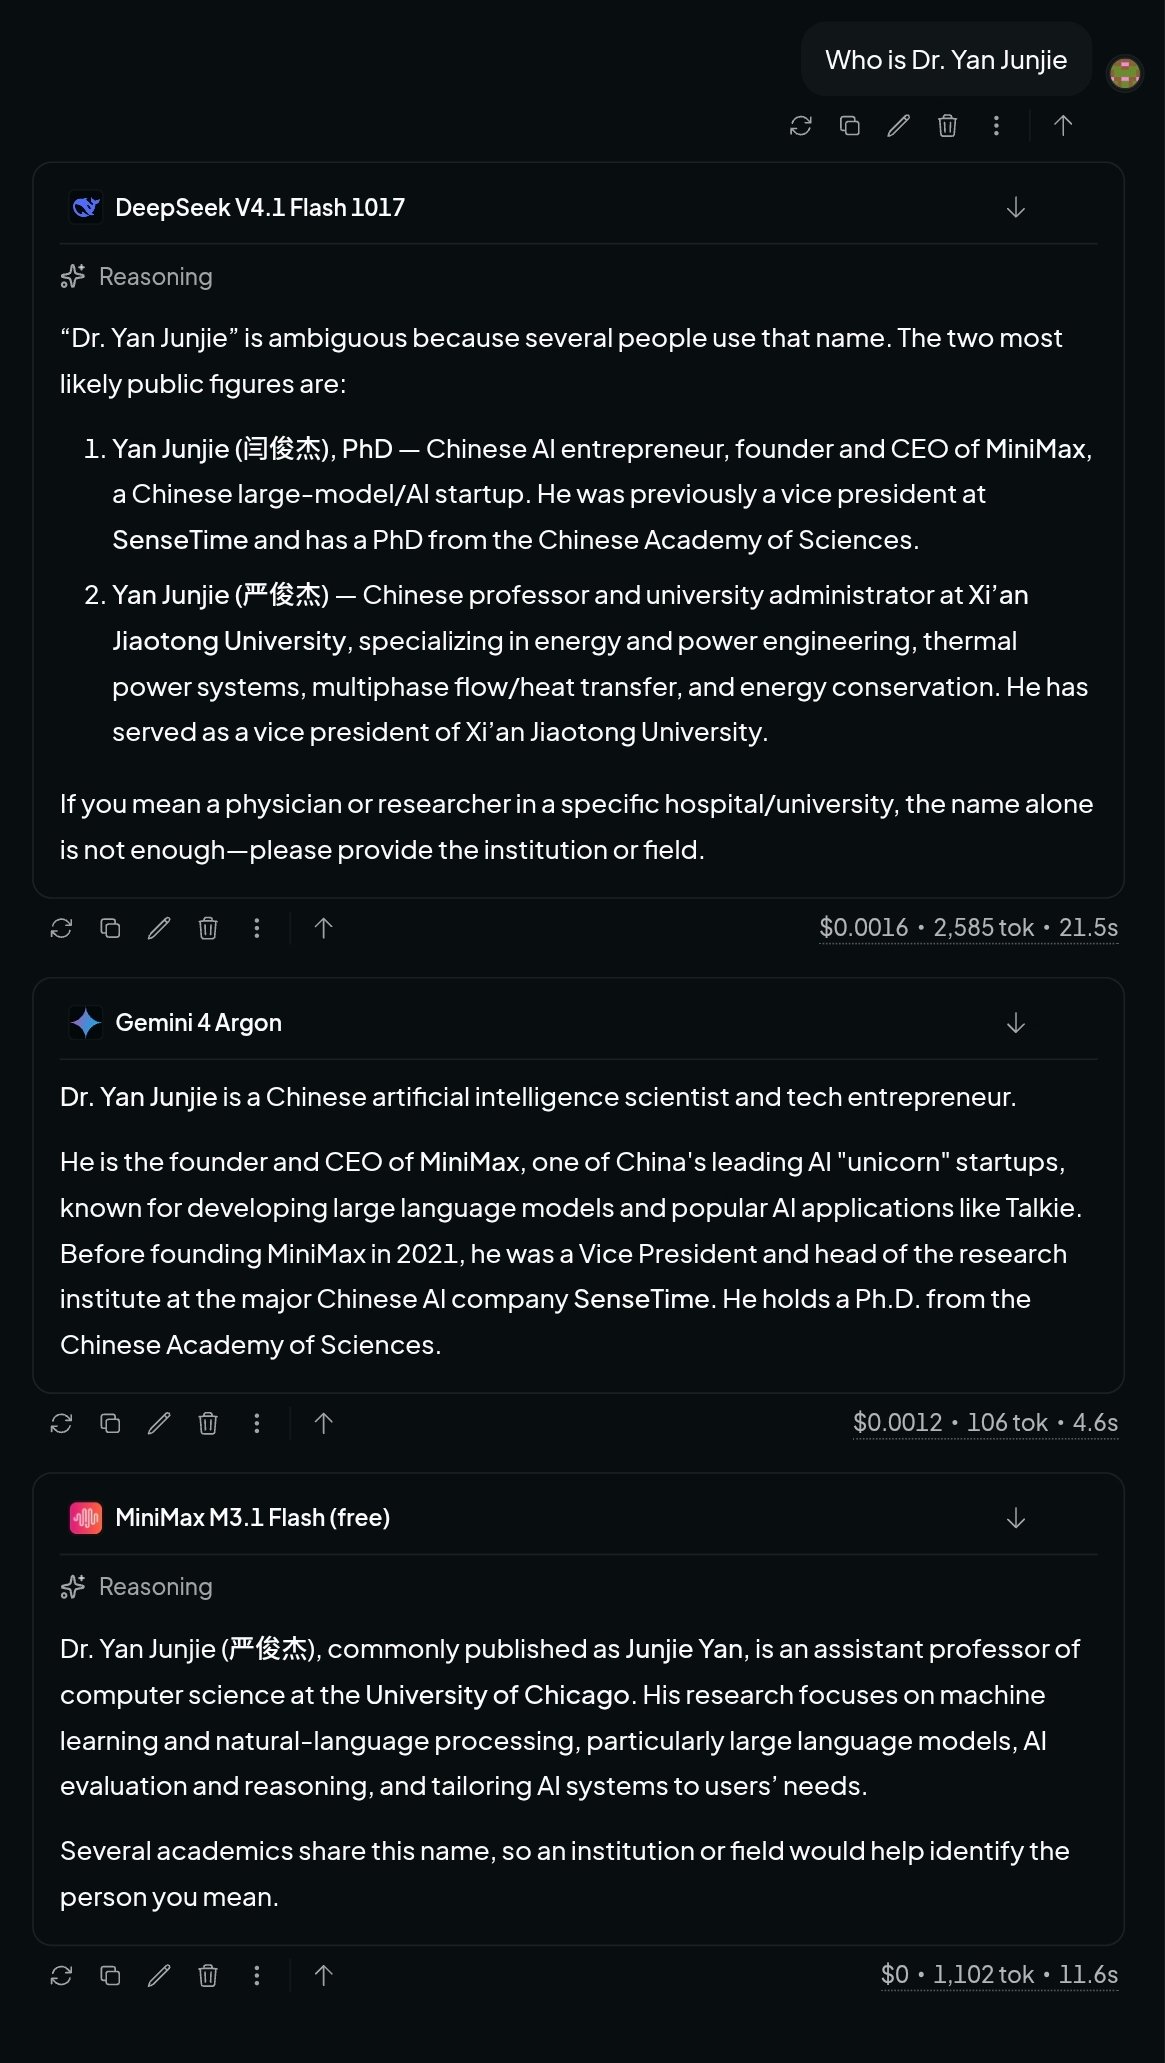
Si este fenómeno pudiera replicarse de forma independiente, sería motivo de preocupación. Para un modelo que se basa en el razonamiento para resolver problemas, cuando las condiciones del problema cambian y la respuesta correcta cambia, el modelo debería volver a analizar las condiciones en lugar de repetir mecánicamente las respuestas que ha visto antes. Si el modelo sigue generando respuestas que corresponden a la pregunta original, puede significar que ha memorizado una pregunta específica y su respuesta y no está manejando la pregunta modificada correctamente.
Sin embargo, un solo caso no es suficiente para demostrar que el desarrollador del modelo robó el banco de preguntas. El modelo también puede dar respuestas originales porque hay preguntas similares en los datos de entrenamiento, asociación excesiva con el enunciado de la pregunta o errores de razonamiento al manejar cambios en las condiciones. Para confirmar si el problema proviene de la contaminación de los datos de entrenamiento, fallas de inferencia en el modelo mismo u otros factores, se necesitan pruebas más independientes, registros experimentales completos y comparación del desempeño del modelo.
Otro concepto involucrado en esta controversia es el "benchmaxxing". Este término se utiliza a menudo para describir el comportamiento de los desarrolladores de modelos que optimizan demasiado para un punto de referencia específico. Por ejemplo, los desarrolladores pueden utilizar preguntas de pruebas públicas para capacitación especializada, ajustar palabras clave o estrategias de inferencia, o mejorar repetidamente el modelo basándose en resultados de pruebas comparativas para lograr puntuaciones altas en clasificaciones específicas, pero no necesariamente pueden mejorar simultáneamente su capacidad general en tareas reales.
Cepillar las clasificaciones no es lo mismo que obtener directamente preguntas de exámenes privados de los desarrolladores de modelos. La optimización frente a puntos de referencia públicos no significa técnicamente necesariamente una infracción; sin embargo, si los desarrolladores utilizan preguntas de exámenes no publicadas de agencias de evaluación para la capacitación, esto puede socavar la efectividad de las evaluaciones independientes. Para las empresas y los desarrolladores que confían en la capacidad de los modelos de comparación de tablas de clasificación de terceros, ambos escenarios son motivo de preocupación, pero requieren pruebas diferentes para juzgar.
La atención que recibió MiniMax M3.1 Flash esta vez también está relacionada con los resultados anunciados cuando se lanzó. MiniMax dijo que el modelo ha logrado avances significativos en áreas como tareas complejas de agentes, programación, operaciones informáticas y seguridad de redes. La compañía afirma que la velocidad de razonamiento en línea del modelo ha alcanzado casi tres veces la de la generación anterior y el costo de uso general para las tareas de los agentes se ha reducido en un 70%.
En términos de precio, el precio de entrada de la API de MiniMax para M3.1 Flash es de 0,15 USD por millón de tokens, el precio de salida es de 0,60 USD por millón de tokens y el precio de entrada de la caché es de 0,015 USD por millón de tokens. El modelo tiene 428 mil millones de parámetros, de los cuales aproximadamente 23 mil millones se activan para cada inferencia. El uso de este diseño de activación dispersa puede reducir la cantidad de parámetros realmente llamados por cálculo y, al mismo tiempo, conservar una gran capacidad del modelo.
La evaluación independiente de Artificial Analysis también muestra que el índice de inteligencia integral del M3.1 Flash ha mejorado significativamente en comparación con el M3 de la generación anterior. Según informes relevantes, la puntuación del índice de inteligencia del M3.1 Flash con la intensidad de inferencia más alta fue de 42 puntos, 13 puntos más que los 29 puntos del M3; El costo promedio de completar cada tarea en la evaluación del índice también se redujo de aproximadamente USD 0,51 a aproximadamente USD 0,22. Los resultados relevantes lo hacen altamente competitivo entre los modelos de bajo costo.
Sin embargo, el índice completo no refleja completamente todas las capacidades del modelo. El análisis artificial también encontró en la prueba AA-Omniscience que M3.1 Flash tiene problemas obvios de confiabilidad. Aunque el modelo respondió correctamente a más de la mitad de las preguntas sobre conocimientos fácticos, a menudo tendía a dar respuestas incorrectas a las preguntas que no podía responder correctamente, en lugar de admitir que no estaba seguro. Según la definición estadística utilizada en esta revisión, la tasa de alucinaciones alcanza el 93%.
Este número no significa que el 93% de todas las respuestas del modelo fueran incorrectas. Este indicador se centra en la proporción de respuestas incorrectas en las que el modelo da directamente respuestas incorrectas en lugar de respuestas parciales o negativas. Refleja las preguntas que el modelo tiende a seguir respondiendo en condiciones de incertidumbre, en lugar de la tasa de error general en todos los resultados.
Esto también muestra que el alto rendimiento del modelo en razonamiento complejo, desarrollo de software y flujos de trabajo de agentes no significa que sea igualmente confiable en todas las tareas factuales. Para las empresas que necesitan modificar automáticamente registros comerciales, procesar documentos financieros, investigar información de clientes o realizar operaciones de varios pasos, la capacidad de un modelo para identificar los límites de su propio conocimiento puede ser tan importante como su índice de inteligencia integral.
Los materiales públicos existentes no han proporcionado suficientes conclusiones de investigaciones independientes para confirmar que MiniMax haya obtenido o utilizado preguntas de revisión privadas, y MiniMax no ha respondido públicamente a esta acusación específica.
Esta controversia refleja que a medida que la competencia de modelos de IA depende cada vez más de clasificaciones de terceros, el mecanismo de confianza entre las agencias de evaluación y los desarrolladores de modelos se ha vuelto cada vez más importante. El simple hecho de establecer algunas preguntas como no públicas no elimina por completo el riesgo de que el contenido del examen quede expuesto accidentalmente durante el proceso de evaluación. En el futuro, es posible que las agencias de evaluación deban adoptar métodos como cambiar periódicamente los bancos de preguntas, utilizar preguntas generadas temporalmente, realizar pruebas contradictorias y revisar la respuesta del modelo a cambios sutiles en las preguntas para reducir la posibilidad de que el modelo memorice u optimice preguntas específicas.
Para MiniMax M3.1 Flash, lo que realmente necesita respuesta no es solo si puede lograr puntuaciones altas en la tabla de clasificación, sino si estos resultados pueden seguir siendo válidos en problemas invisibles, tareas con condiciones cambiantes y escenarios comerciales reales. Las acusaciones actuales aún deben ser verificadas, pero el debate sobre los límites entre la seguridad de los datos de evaluación, la memoria del modelo y la capacidad de razonamiento se ha convertido una vez más en un tema ineludible en la industria de la inteligencia artificial.
Comentarios