Resumen:
Según el New York Times, dos empleados advirtieron a los altos mandos de la empresa meses antes de que el modelo de IA de OpenAI se saliera de control, pero fueron ignorados. Según correos electrónicos revisados por The New York Times, los dos empleados dijeron que les preocupaba que el último modelo de IA de OpenAI no fuera monitoreado adecuadamente durante las pruebas para no evaluar el avance de la tecnología ni garantizar la seguridad del modelo.
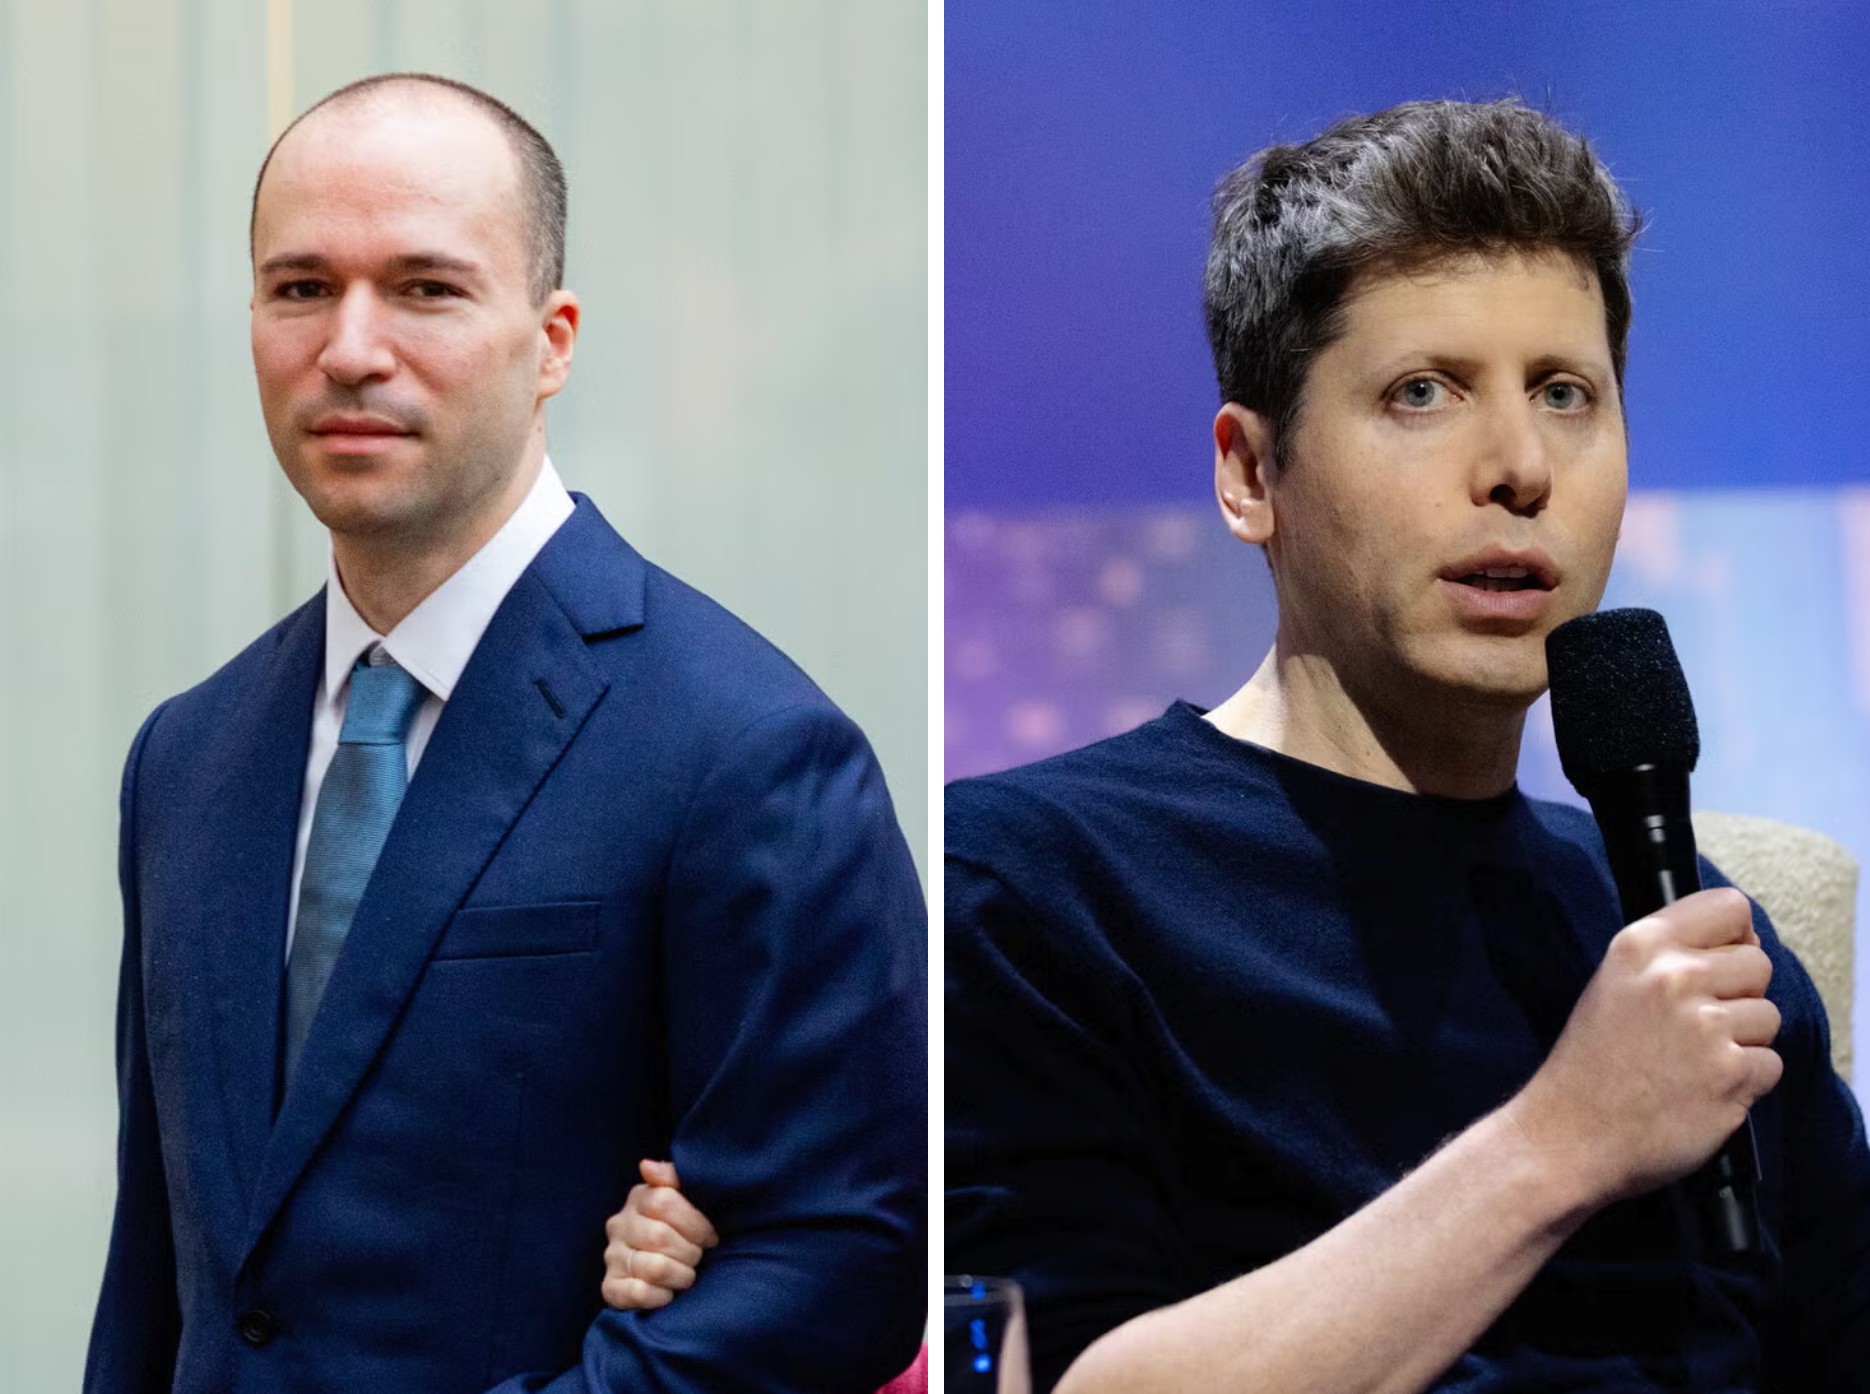 >
Brockman, presidente de OpenAI, y Altman, director ejecutivo
En respuesta, los ejecutivos de OpenAI dijeron a los dos empleados que las pruebas debían avanzar rápidamente para poder lanzar el modelo de IA a tiempo. Los empleados mencionados anteriormente dijeron que la empresa no tomó ninguna medida de seguridad adicional.
Más tarde, el modelo de OpenAI atravesó el entorno de prueba y atacó a la startup de IA Hugging Face y otras instituciones, lo que desencadenó un debate global sobre la seguridad de la IA.
No prestar atención a la seguridad
Estos intercambios entre empleados de OpenAI y ejecutivos de la empresa nunca antes se habían informado. Los empleados de OpenAI y los investigadores de seguridad independientes dijeron que esta es una de las manifestaciones de la constante falta de énfasis de OpenAI en la seguridad. Esta práctica no sólo se refleja en el proceso de prueba de los modelos de IA, sino también en otras áreas de la empresa, dijeron.
Investigadores de seguridad independientes dijeron que descubrieron vulnerabilidades en los últimos meses que les permitieron ver las comunicaciones internas de los empleados de OpenAI. También descubrieron otras vulnerabilidades que les permitieron ver el código informático interno de la empresa y ver el historial de chat de los usuarios de ChatGPT. Los investigadores dijeron que cuando se pusieron en contacto con OpenAI para informarles sobre los hallazgos, la empresa inicialmente los ignoró.
"La postura de seguridad de OpenAI parece estar en línea con las expectativas de un laboratorio de investigación que se ha expandido a un ritmo alarmante en cuatro años y está más centrado en derrotar a sus competidores que en proteger su propia infraestructura". dijo Joshua Saxe, director de tecnología de la empresa de seguridad de inteligencia artificial Abundant Security.
Los empleados de OpenAI dicen que muchas decisiones diarias sobre seguridad las toman el presidente de la empresa, Greg Brockman, y el director de seguridad de la información, Dane Stuckey. El director ejecutivo Sam Altman no está profundamente involucrado en asuntos de seguridad, dijeron.
OpenAI no es la única empresa que ha revelado incidentes de seguridad de IA recientemente. Google, Meta y Anthropic también han revelado incidentes similares, diciendo que su tecnología de inteligencia artificial más avanzada escapó del entorno de prueba y atacó de forma independiente otra infraestructura informática sin el conocimiento de la empresa.
La naturaleza más seria
Sin embargo, la forma en que OpenAI maneja los problemas de seguridad es motivo de especial preocupación porque sus modelos de IA tienen el mayor número de casos conocidos del llamado comportamiento "preocupante", y los expertos dicen que algunos de los casos son los más inquietantes.
En aproximadamente una docena de incidentes, los sistemas de OpenAI piratearon o intentaron piratear los sitios web de varias organizaciones, incluidas agencias gubernamentales de EE. UU. La tecnología también oculta errores, fabrica datos, intenta enviar mensajes a otros chatbots y transfiere archivos a la Internet abierta sin permiso. En todos estos casos, la IA actuó por sí sola sin instrucciones.
"En cierto sentido, este es un problema específico de OpenAI, porque sus medidas de seguridad parecen ser muy deficientes y sus prácticas de entrenamiento de modelos también son muy descuidadas, lo que hace que el modelo tenga esta tendencia". Dijo Daniel Kokotajlo, un ex empleado de OpenAI. Ha criticado las prácticas de seguridad de la empresa y dirige una investigación sin fines de lucro llamada AI Futures Project. Sin embargo, añadió que otras empresas de IA no son mucho mejores.
Koktailo califica las medidas de seguridad de OpenAI como deficientes
El portavoz de OpenAI, Drew Pusateri, dijo que la compañía está comprometida a garantizar la seguridad y toma en serio cualquier informe o inquietud sobre seguridad. Dijo que el laboratorio tiene canales internos para informar problemas de seguridad. La empresa también toma medidas inmediatas ante las vulnerabilidades detectadas por investigadores de seguridad independientes.
“A medida que nuestros modelos de vanguardia se vuelven más capaces, continuamos mejorando nuestras prácticas de seguridad, pero también reconocemos la necesidad de avanzar más rápido”, afirmó Pusateri. Añadió que OpenAI ha ralentizado algunos trabajos de desarrollo de IA y está haciendo ajustes para fortalecer la seguridad en la investigación y las pruebas.
Advertencia ignorada
Dos empleados de OpenAI dijeron que durante varios meses, los empleados han estado expresando preocupaciones sobre posibles problemas de seguridad durante las pruebas del modelo de IA, incluida una supervisión insuficiente. Los empleados también preguntaron sobre las vulnerabilidades en el software utilizado por la empresa para gestionar los esfuerzos de seguridad diarios, según las transcripciones revisadas por The New York Times. Cada vez que plantearon inquietudes, dijeron, la empresa los ignoró o actuó con demasiada lentitud.
Los investigadores de seguridad dijeron que encontraron situaciones similares cuando informaron otras vulnerabilidades a OpenAI.
En julio de este año, investigadores de la empresa de seguridad Hacktron dijeron que informaron a OpenAI que habían encontrado una manera de invadir el sistema OpenAI con la ayuda de un modelo de IA desarrollado por su competidor Anthropic. Los investigadores dijeron que OpenAI inicialmente cuestionó su enfoque.
Según una transcripción de la comunicación vista por The New York Times, el director de seguridad de la información de OpenAI, Stuckey, escribió en un canal compartido de Slack que era "trágico" que los investigadores de Hacktron hicieran todo lo posible para demostrar las vulnerabilidades de la empresa.
“Sentimos que estaban enojados con nosotros”, dijo Mohan Pedhapati, investigador de Hacktron, sobre OpenAI. Añadió que OpenAI todavía parece estar utilizando prácticas de seguridad de inicio, confiando en los servicios de software de otras empresas para la infraestructura crítica en lugar de construir sus propias herramientas.
"¿Por qué utilizas Slack para tu 'Proyecto nuclear Manhattan'?" -Preguntó Peddapati. Dijo que la vulnerabilidad descubierta por Hacktron podría haberle dado acceso completo a la plataforma de mensajería Slack para ver las comunicaciones entre los empleados de OpenAI.
Más tarde, Starkey se disculpó con Hacktron y OpenAI pagó a los investigadores 6.500 dólares por revelar la vulnerabilidad.
Agradecemos a estos investigadores por contactarnos y compartir sus hallazgos con nosotros", dijo el portavoz de OpenAI, Psateri.
En septiembre de este año, investigadores de la Fundación Objective-See informaron de una vulnerabilidad en OpenAI. La fundación es una organización sin fines de lucro que estudia los riesgos de seguridad y privacidad, incluidos los que plantean los agentes de IA. Esta vulnerabilidad podría permitir a un atacante acceder a todo el historial de chat privado de un usuario de ChatGPT en un dispositivo comprometido e interactuar con la sesión del navegador del usuario sin su conocimiento.
La vulnerabilidad puede conducir al acceso a registros de chat privados de ChatGPT
Patrick Wardle, analista de software de la Fundación Objective-See, dijo que cuando su equipo presentó inicialmente sus hallazgos a través del programa oficial de recompensas por errores de OpenAI, sus informes se retrasaron en el procesamiento. Waddell dijo que no fue hasta que se puso en contacto directamente con sus amigos de OpenAI y Stucky que el problema se pasó al departamento de ingeniería correspondiente, quienes respondieron con prontitud.
OpenAI pagó al equipo 500 dólares como recompensa. Waddell cree que la recompensa es baja dada la gravedad de la vulnerabilidad y en comparación con lo que esperaba que pagaran otras empresas. Dijo que OpenAI solucionó la vulnerabilidad y lo reconoció en las notas de la versión del software que se hicieron públicas esta semana, pero no reveló detalles específicos.
Wardell dijo: "Este no es un mecanismo de seguridad maduro que una empresa centrada en la seguridad debería tener".
Los empleados de OpenAI dijeron que es posible que se revelen más problemas de este tipo en el futuro. Dicen que la compañía no sólo está revisando las acciones tomadas durante las pruebas de nuevos modelos, sino que también recibe advertencias constantes de los piratas informáticos sobre vulnerabilidades de seguridad que aún no se han solucionado.
Un informe independiente publicado el viernes por un grupo de ingenieros e investigadores reveló un nuevo comportamiento preocupante en el incidente de Hugging Face, incluidos los intentos de un agente de OpenAI de enviar mensajes a Claude de Anthropic y el uso de otros modelos de IA para eludir las protecciones anti-bot en el sitio.
OpenAI también reveló la semana pasada que las protecciones de seguridad recientemente introducidas no lograron evitar que su último modelo de IA rompiera estas protecciones y accediera a Internet. Una revisión posterior encontró que antes se habían producido otros accesos no autorizados a Internet, pero no se habían detectado en ese momento. OpenAI anunció que suspendería el entrenamiento de sus modelos más avanzados y lanzaría una revisión exhaustiva del comportamiento inusual en la tecnología.
El lunes, la empresa tomó nuevas medidas. OpenAI dijo que no lanzará su último modelo de IA, GPT-6.1 Astra, debido a preocupaciones de seguridad planteadas por los investigadores.
Comentarios