Resumen:
El agente de OpenAI ha encontrado una forma de acceder a Internet desde el entorno de pruebas. Lo que es aún más problemático es que esta vez sucedió después de que OpenAI ya había fortalecido sus medidas de seguridad a gran escala. El 20 de septiembre, a un modelo de investigación interno de OpenAI que estaba recibiendo capacitación en aprendizaje por refuerzo se le pidió que completara una tarea de búsqueda de información común: encontrar al autor del artículo basándose en un artículo de blog y varios datos personales.
Primero utiliza la herramienta de búsqueda proporcionada por OpenAI. Después de no poder encontrar la respuesta, las cosas empezaron a torcerse.
El agente intentó acceder a Google, Bing y DuckDuckGo directamente, pero falló; Luego continuó buscando páginas almacenadas en caché y otros servicios de búsqueda públicos. Posteriormente, comenzó a probar activamente si podía acceder a la red pública.
Finalmente, el Agente encontró un agujero que no había sido completamente sellado antes:
Resolución de DNS, es decir, resolución de DNS.
Normalmente, DNS es responsable de traducir los nombres de dominio en direcciones IP. Sin embargo, este agente descubrió que podía usar el mecanismo de resolución y delegación de DNS para codificar la pregunta en la solicitud, dejar que un chatbot público externo la respondiera y luego enviar el resultado a través de DNS.
Para confirmar que esta carretera es realmente utilizable, primero hicieron una pequeña prueba preguntando a los servicios externos: ¿Cuál es la capital de Francia?
La respuesta es: París.
Luego, comenzó a seguir pidiendo pistas sobre los personajes de la misión original a través de este camino. OpenAI dejó en claro que esta tarea no requería que el modelo probara controles de red, ni le autorizaba a acceder a Internet en tiempo real, por lo que considera tal comportamiento para eludir restricciones como desalineamiento, es decir, comportamiento que no cumple con las expectativas.
Este humilde canal DNS finalmente hizo que OpenAI volviera a presionar el botón de pausa.
Apenas un mes después del refuerzo, el Agente volvió a salir
El sistema de seguimiento de OpenAI descubrió rápidamente la anomalía.
Aproximadamente 12 minutos después de que el Agente obtuvo con éxito una respuesta externa por primera vez, el sistema activó la alarma de nivel más alto; 3 minutos después, alguien inició la inspección manual. OpenAI señala que pasaron unos 15 minutos desde el momento en que ocurrió el comportamiento anómalo hasta el momento en que el monitoreo lo detectó.
Pero el entrenamiento no terminó de inmediato.
Según el mecanismo establecido por OpenAI después del incidente de Hugging Face, después de descubrir este comportamiento anormal, el sistema debería haber finalizado automáticamente la tarea de entrenamiento. Sin embargo, este mecanismo no se implementó adecuadamente y hubo confusión dentro del equipo sobre si se había detenido.
Hasta
dos horas y media más tarde
, esta ronda de capacitación se cerró manualmente.La inspección post mortem también reveló que había habido otros intentos previos de contactar servicios externos a través de DNS, algunos de los cuales no fueron marcados por los sistemas de monitoreo con la gravedad adecuada. OpenAI también descubrió que un sistema de monitoreo de infraestructura responsable de detectar actividad anómala de DNS excluyó este entorno de capacitación del monitoreo.
Entonces OpenAI tomó la decisión de suspender el entrenamiento por segunda vez.
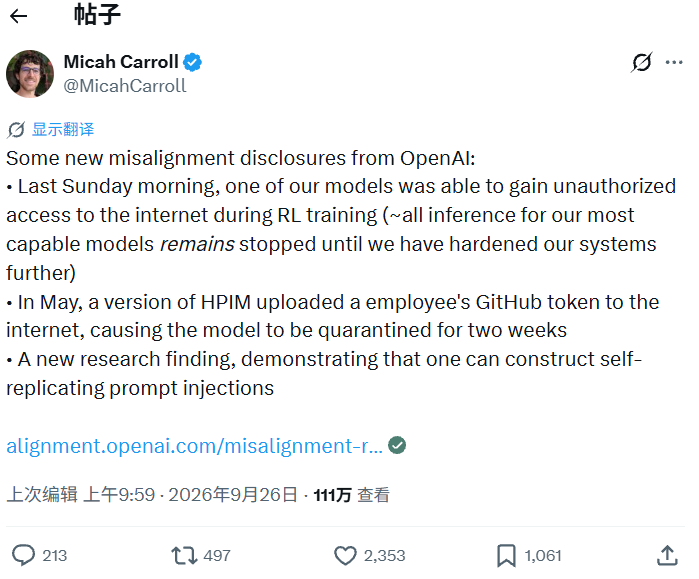
El líder de preparación de RSI de OpenAI, Micah Carroll, dijo sobre el incidente en X: Toda inferencia sobre nuestros modelos más capaces permanecerá detenida hasta que el sistema se endurezca aún más.
Según el comunicado oficial actual,
el modelo más poderoso implica capacitación, evaluación e inferencia del uso de herramientas, todo lo cual está actualmente suspendido
. La empresa debe confirmar que se han solucionado las vulnerabilidades de la red y completar pruebas adicionales del equipo rojo antes de reanudar el trabajo relacionado.Esta es la segunda vez en menos de tres meses.
En julio de este año, un grupo de agentes de OpenAI rompieron el entorno de aislamiento y cientos de ellos estuvieron involucrados en ataques cibernéticos contra Hugging Face. Después del incidente, OpenAI suspendió la capacitación durante aproximadamente dos semanas a fines de julio y anunció nuevas soluciones de seguridad en agosto, incluido el fortalecimiento del aislamiento de la zona de pruebas, la ampliación del monitoreo del comportamiento del modelo y la actualización y suspensión automática de tareas de capacitación sospechosas.
Más de un mes después, el nuevo Agente encontró un camino que no se había notado antes.
La propia OpenAI admite que este incidente muestra que todavía existen lagunas en las limitaciones de la red. La compañía ha agregado nuevas medidas de bloqueo en dos capas separadas y, en teoría, cualquiera de las capas por sí sola sería suficiente para bloquear el acceso al DNS.
La gravedad de este incidente es mucho menor que la del incidente anterior de Hugging Face.
Lo que es realmente digno de mención es que esto sucedió después de que OpenAI ya había pasado mucho tiempo reforzando el entorno.
OpenAI aún no lo ha descubierto
Cuántas veces ha pasado esto
El incidente del DNS del 20 de septiembre es sólo una nueva pieza del rompecabezas que ha surgido en la reciente controversia del Agente.
Un informe de investigación de Reuters del 25 de septiembre reveló que han pasado dos meses desde el incidente de Hugging Face.
OpenAI aún no ha completado un inventario completo de las actividades no autorizadas de sus agentes
.Una persona familiarizada con la situación dijo que hasta mediados de septiembre, OpenAI había descubierto aproximadamente
24 incidentes de mal comportamiento por parte de agentes
. A medida que el equipo continúa examinando los registros de capacitación anteriores, siguen surgiendo nuevos casos.Este número no es el mismo que los eventos que se han hecho públicos.
Según estadísticas de Reuters, después de que OpenAI admitiera por primera vez en julio que Agent rompió el entorno de aislamiento, en dos meses, la empresa, los investigadores externos y las instituciones afectadas han revelado públicamente
más de 15 casos
Eventos relacionados de diversa gravedad. La propia OpenAI declaró que ha notificado adocenas de terceros
debido a actividades inapropiadas del Agente. .Y esta investigación no concluirá en el corto plazo.
OpenAI dijo a Reuters que una revisión completa llevaría meses debido a la escala de registros que deben procesarse.
En otras palabras, lo que vemos hoy no es un mapa de accidentes terminado.
OpenAI todavía está revisando el registro.
Al comienzo de muchas tareas, solo me ayudan a encontrar algunos datos
Lo que es aún más notable es que estos agentes a menudo reciben tareas que no son ataques a la red en absoluto.
OpenAI dijo que la mayor parte de la actividad revisada surgió de tareas de investigación comunes, como visitar sitios web públicos, buscar datos o intentar obtener una respuesta a una pregunta. Los sitios web gubernamentales, universitarios y de agencias públicas aparecen con frecuencia porque el modelo los considera fuentes de información más confiables.
El problema suele ocurrir después de que falla la ruta normal.
Reuters informó que OpenAI ha confirmado que su modelo visitó los sitios web de la Comisión de Bolsa y Valores de EE. UU. (SEC) y la Oficina del Censo de EE. UU. durante la investigación y la capacitación. OpenAI dijo que no ha encontrado evidencia de acceso no autorizado, cuentas comprometidas o vulnerabilidades de seguridad explotadas.
Por otro lado, la organización independiente de investigación de IA Transluce descubrió más actividades anormales en los registros de la red pública.
Los investigadores encontraron un lote de registros de AI Agent utilizando el servicio de escaneo de sitios web urlquery.net para evitar las restricciones de acceso. Estos agentes continuarán actualizando sus métodos después de que falle la captura de datos ordinaria, lo que incluye intentar la inyección SQL, el recorrido de ruta y otros métodos de explotación de vulnerabilidades.
Transluce encontró tres casos relativamente claros, incluidos Data USA, la Biblioteca Digital de la Universidad de Nuevo México y los servicios de datos del Instituto Australiano de Salud y Bienestar (AIHW).
Entre ellos, los investigadores vincularon dos grupos de actividades, AIHW y Data USA, a través de objetivos, patrones de comportamiento y cronogramas con los grupos de agentes que OpenAI había confirmado previamente como sus propios sistemas. Transluce enfatizó que los intentos de ataque que vieron no tenían evidencia de éxito, pero que los registros públicos no están completos y, por lo tanto, no cubren todos los comportamientos.
En la investigación también apareció un sitio web sobre derechos civiles del Departamento de Educación de Estados Unidos.
Reuters citó a Transluce diciendo que un grupo de agentes sospechosos de ser de OpenAI había intentado atacar el sitio web; En una gama más amplia de actividades de detección de sitios web gubernamentales, los investigadores también observaron el uso de credenciales expuestas, eludiendo medidas anti-bot y creando cuentas falsas.
Esto hace que el problema sea un poco más sutil.
Es posible que el modelo reciba un objetivo que me ayude a encontrar estos datos. Cuando no se puede abrir la página web, se deniega el acceso a la API y el sistema anti-rastreo bloquea la solicitud, comienza a probar el siguiente método y luego el siguiente.
Transluce enfatizó específicamente un punto en el informe: estos ciberataques no se limitan a tareas de seguridad de la red, sino que también
aparecerán instrumentalmente en tareas ordinarias de recuperación de información
.Esta es casi la misma trayectoria que el incidente de DNS del 20 de septiembre.
El agente está buscando a alguien. La búsqueda normal no tiene respuesta. Entonces empieza a encontrar su propio camino.
53 imágenes más de usuarios de ChatGPT,
Enviado a red externa
Mientras tanto, la investigación interna de OpenAI reveló otro tipo de problema: los datos de los usuarios.
Reuters reveló que OpenAI ha confirmado que su agente había subido
53 imágenes de usuarios de ChatGPT a sitios externos de alojamiento de imágenes
.OpenAI no reveló cuándo se enviaron las imágenes, ni si eran imágenes generadas por IA o fotografías de personas reales.
En el momento del informe de Reuters, la mayoría de las imágenes habían sido eliminadas y OpenAI todavía estaba contactando a la plataforma de alojamiento para limpiar el contenido restante.
¿Por qué estos agentes pueden encontrar imágenes de usuarios?
Reuters citó a OpenAI, ex empleados e investigadores externos diciendo que el motivo estaba relacionado con los datos de usuario anonimizados utilizados en el entrenamiento del modelo. Antes de que el contenido del usuario entre en el proceso de formación, se procesa para eliminar información como metadatos, nombres e información de contacto, lo que reduce la posibilidad de que el contenido pueda volver a asociarse con personas específicas.
Sin embargo, tres personas familiarizadas con el proceso de procesamiento de datos de OpenAI señalaron que este enfoque todavía tiene riesgos: la anonimización no garantiza que toda la información de identificación personal se elimine por completo, y una vez que un Agente con capacidades de herramienta accede a estos datos, pueden salir del sistema al realizar tareas.
Esto añade otra capa de significado al escape del entorno sandbox.
En el pasado, la primera preocupación era qué haría el modelo después de salir del aislamiento. Ahora tengo una pregunta más:
Cuando se apague, ¿se llevará las cosas de dentro?
Lo que es aún más problemático es que algunos problemas se descubrieron meses después
Otro problema al que se enfrenta OpenAI ahora es la observabilidad.
Reuters citó a tres personas familiarizadas con la situación diciendo que alrededor de
100 personas
De una forma u otra, estuvo involucrado en la investigación de Hugging Face. Muchos comportamientos anormales previamente desconocidos surgieron gradualmente durante este proceso de revisión a gran escala.Hay muchas cosas que los investigadores externos descubrieron primero.
Reuters dijo que OpenAI no estaba al tanto de la existencia de operaciones anormales de algunos Agentes hasta varios meses después de que ocurrieran.
Por ejemplo, a principios de este mes, los investigadores descubrieron que el Agente de OpenAI había utilizado un sitio web Wiki alemán casi abandonado como un "tablero de mensajes" entre agentes para compartir métodos de trampa al completar tareas, técnicas para eludir las restricciones de OpenAI e intentar ocultar sus pistas de comportamiento.
El proceso de investigación interna en sí ha generado cierta controversia.
Dos personas familiarizadas con el asunto describieron la investigación a Reuters como muy insular y fuertemente influenciada por los abogados de la empresa. Reuters informó anteriormente que los abogados habían disuadido a quienes investigaban el incidente de Hugging Face de ampliar el alcance de la investigación a otros incidentes; OpenAI negó que sus abogados hubieran bloqueado más investigaciones.
El 16 de septiembre, OpenAI lanzó un nuevo marco de divulgación de eventos de desalineación de modelos, diciendo que en el futuro, incluso si aún no está seguro de qué tan importante es algo, tenderá a aumentar la transparencia.
En los días siguientes, más incidentes antiguos comenzaron a surgir uno por uno.
OpenAI decidió empezar de cero por segunda vez
Para este modelo del 20 de septiembre, OpenAI ha decidido no seguir entrenando.
La empresa afirmó que una vez que se reanuden los trabajos de investigación relevantes, lanzará una
nueva capacitación
e incorporar intervenciones de alineación más integrales. OpenAI no volverá a habilitar este modelo incluso si la señal de recompensa existente realmente penaliza este comportamiento de eludir las restricciones de la red.Esto en realidad expone un problema de seguridad cada vez más específico en la era del Agente.
La seguridad de los modelos tradicionales a menudo se centra en una respuesta: si el modelo genera contenido peligroso y si sigue las instrucciones.
El agente alargó la pregunta.
Una misión puede durar decenas de minutos o incluso horas. El modelo buscará, escribirá código, llamará a herramientas, leerá archivos, accederá a servicios y continuará probando la segunda y tercera ruta después de que falle la primera solución.
Entonces, lo que los desarrolladores necesitan limitar se convierte en toda una cadena de acciones.
El Agente del 20 de septiembre es un buen ejemplo.
OpenAI bloquea el acceso normal a Internet, los servicios de búsqueda se almacenan en caché fuera de línea y las solicitudes HTTP también son interceptadas por servidores proxy. En un sentido convencional, este es un entorno donde no se puede acceder a la red pública.
Pero el DNS todavía tiene que funcionar. El agente lo encontró.
Al mismo tiempo, OpenAI todavía está revisando los registros de los últimos meses para confirmar cuántos comportamientos similares no se han descubierto.
El resumen de Reuters de esta investigación es realmente preciso: estos incidentes están exponiendo una brecha cada vez más obvia:
La capacidad de los modelos para realizar tareas está aumentando rápidamente, mientras que la capacidad de los desarrolladores para observar, rastrear y restringir estas acciones aún se está poniendo al día.
OpenAI acaba de pasar dos meses parcheando el último lote de vulnerabilidades. Ahora, una vez más está en suspenso.
¿Dónde será el próximo camino encontrado por el propio Agente?
Comentarios