
Resumen:
La Sony PlayStation 5 se diseñó originalmente como una consola para videojuegos, pero un proyecto de desarrollo de código abierto está tratando de encontrar otro uso para este dispositivo de juego: ejecutar modelos de lenguaje de gran tamaño con inteligencia artificial local. Al superar las limitaciones del sistema de PS5, los desarrolladores trasplantaron el motor de inferencia de código abierto llama.cpp a la consola y utilizaron aún más su GPU para ejecutar modelos grandes. La última demostración muestra que una PS5 ordinaria y crackeada ya puede ejecutar el modelo Qwen 3.8 con 27 mil millones de parámetros. Utilizando una cuantificación de bits bajos, la velocidad de generación de texto alcanza aproximadamente 20 tokens por segundo.
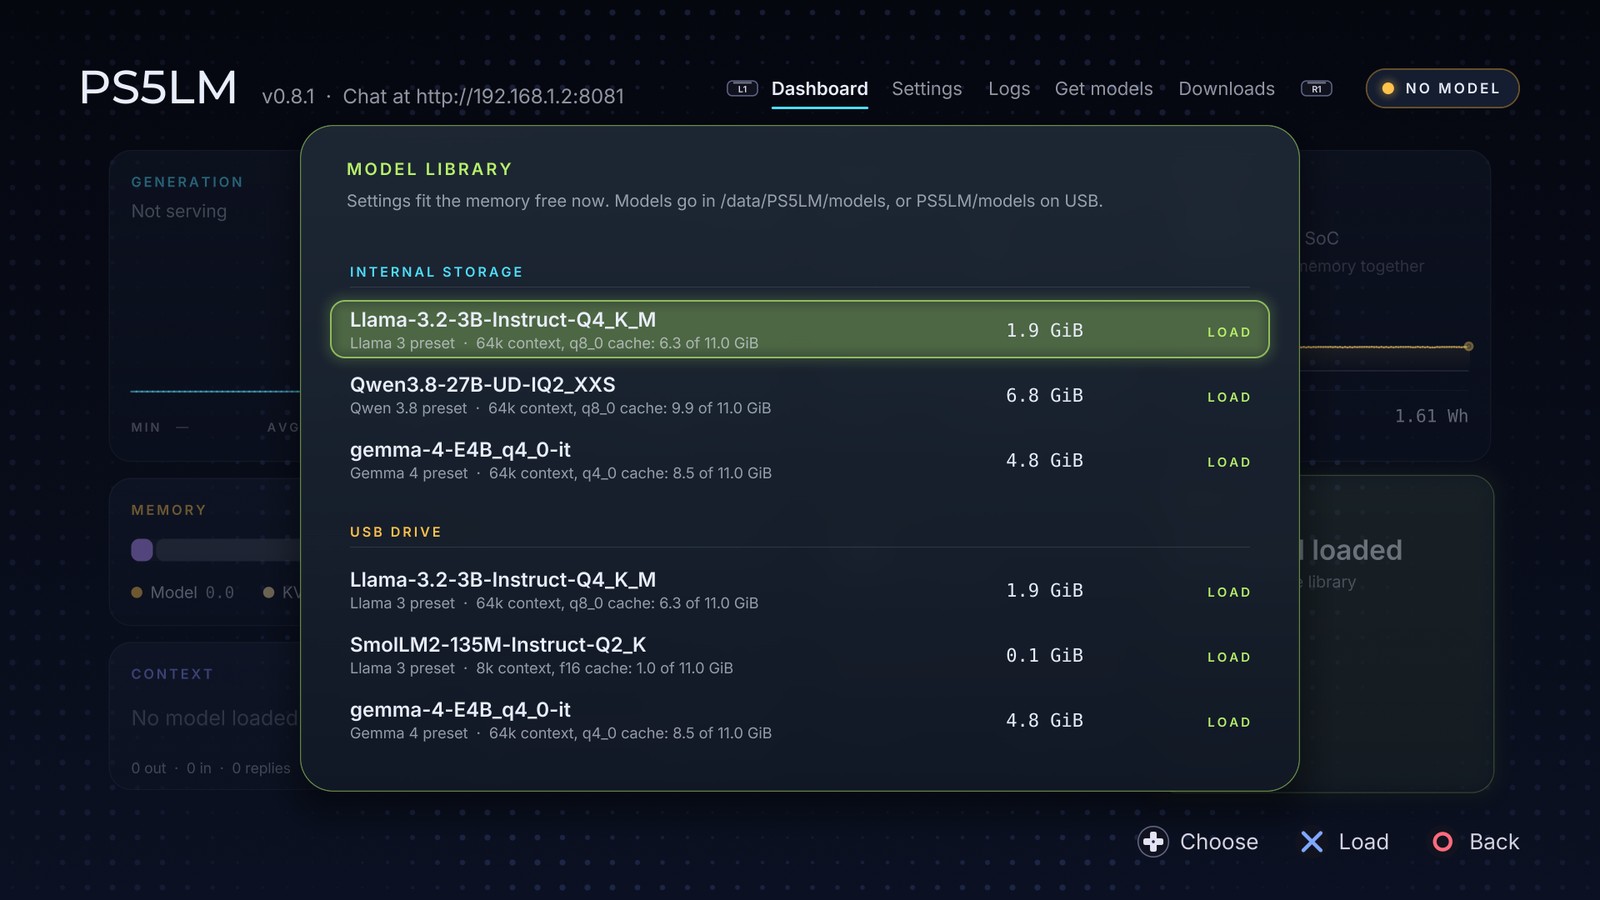
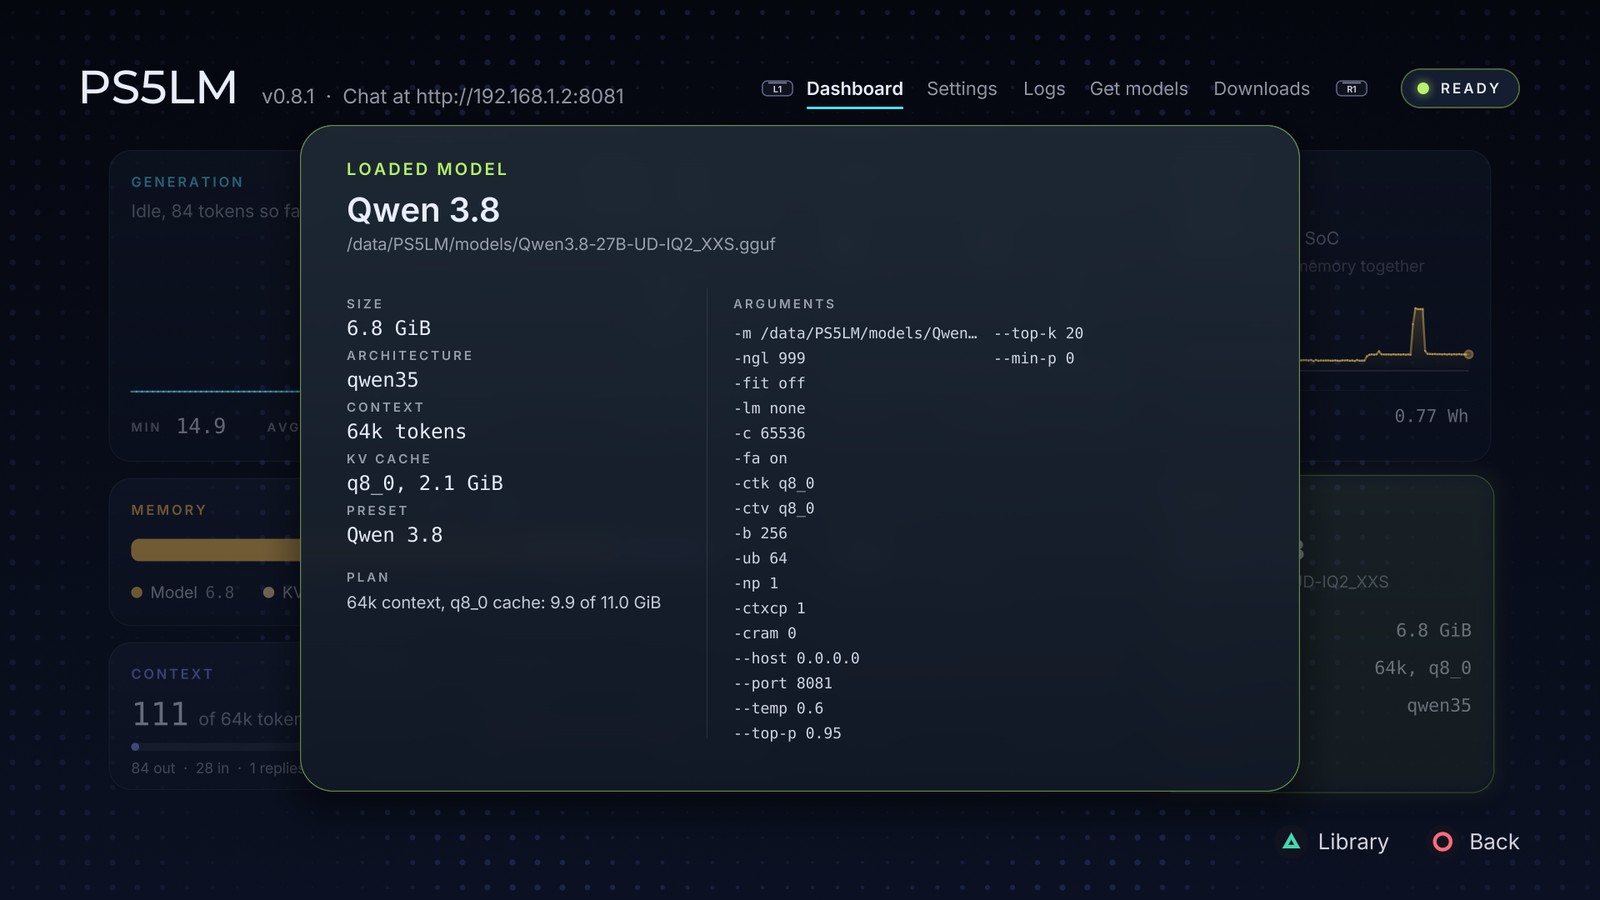
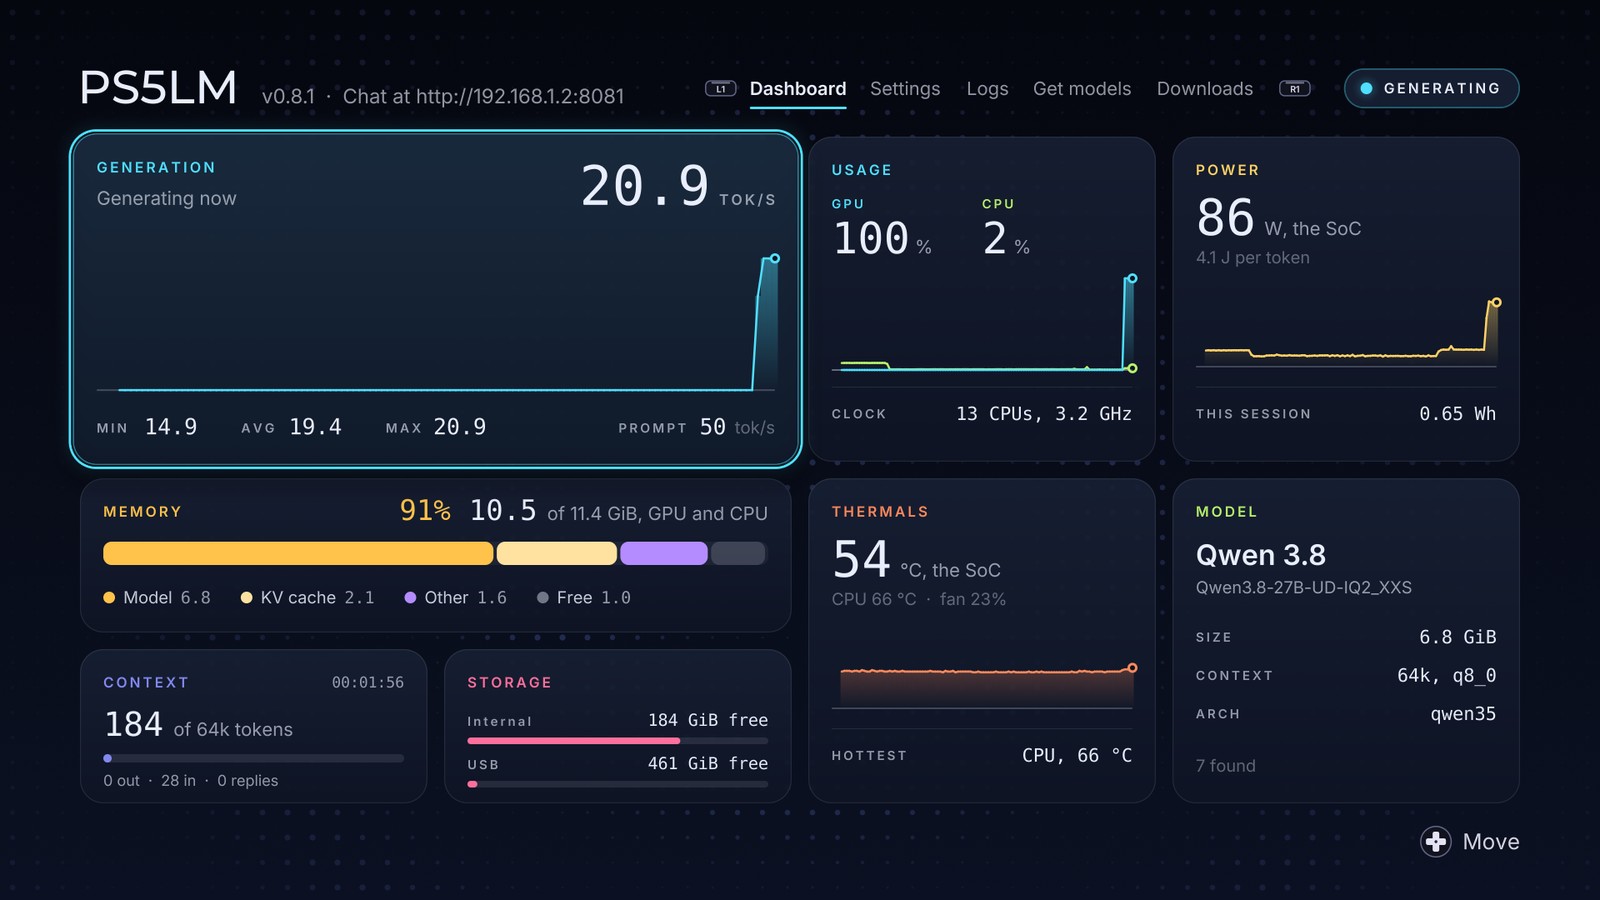
Esto significa que un host utilizado originalmente para ejecutar juegos también puede actuar como un servidor local de modelo de lenguaje grande sin depender de servicios de inteligencia artificial en la nube. Los usuarios pueden acceder a los servicios del host a través de una computadora o teléfono móvil en la misma LAN y hablar con el modelo. Sin embargo, esta no es una característica proporcionada oficialmente por Sony, sino una aplicación experimental que se basa en vulnerabilidades del sistema, software no oficial y resultados de desarrollo de la comunidad.
El proyecto se llama PS5LM y fue iniciado por el desarrollador de GitHub cobanov. La idea central del proyecto no es escribir un nuevo marco de razonamiento de inteligencia artificial desde cero, sino trasplantar la herramienta de código abierto llama.cpp, que se ha utilizado ampliamente para ejecutar modelos grandes locales, a la plataforma PS5, y luego resolver gradualmente los problemas de compatibilidad en el sistema operativo host, la asignación de memoria y la interfaz informática de la GPU.
PS5 utiliza el procesador personalizado de AMD. La CPU utiliza la arquitectura Zen 2 y tiene 8 núcleos; la GPU se basa en la arquitectura AMD RDNA. El host está equipado con una memoria unificada GDDR6 de 16 GB y la CPU y la GPU necesitan compartir estos recursos. Aunque PS5 no es un dispositivo diseñado específicamente para la inferencia de inteligencia artificial, su GPU y su memoria de video de gran ancho de banda proporcionan la base de hardware para ejecutar modelos en el idioma local.
PS5LM inicialmente adoptó un modo de operación relativamente simple, permitiendo que el modelo de lenguaje realizara inferencias a través de la CPU del host y usando el propio navegador de la PS5 para proporcionar una interfaz de chat. Los usuarios pueden descargar el modelo en el host, ingresar preguntas a través del controlador DualSense y el teclado en pantalla y luego ver las respuestas generadas por el modelo.
Esta primera versión demostró la capacidad de la PS5 para ejecutar modelos de lenguaje de gran tamaño, pero rápidamente se topó con limitaciones de rendimiento y memoria. Dado que el programa se ejecuta en forma de carga útil, la memoria que se puede utilizar está restringida por el entorno del sistema. Inicialmente, sólo los modelos más pequeños pueden funcionar de forma estable. Los documentos del proyecto muestran que la primera versión admite principalmente modelos con tamaños de parámetros de aproximadamente 0,8B y 2B, siendo la velocidad de generación del modelo 2B de aproximadamente 9 tokens por segundo.
Para los desarrolladores que quieran ejecutar modelos más grandes en PS5, simplemente dejar que el programa se ejecute en la CPU no es suficiente. Para utilizar completamente el rendimiento del hardware del host, el motor de inferencia debe poder llamar a la GPU y obtener suficiente espacio de memoria para almacenar los parámetros del modelo, el caché y otros datos en ejecución.
El verdadero avance proviene de la aceleración de la GPU. Los desarrolladores han implementado además un entorno de ejecución de aplicaciones nativas en PS5 y, a través del controlador de gráficos y la interfaz informática Vulkan desarrollada por la comunidad, llama.cpp puede llamar a la GPU host para realizar cálculos de redes neuronales. En comparación con la solución anterior que solo podía depender de la CPU, este cambio no solo mejora la velocidad de inferencia, sino que también permite que el programa obtenga más memoria disponible para intentar ejecutar modelos más grandes.
En la última demostración, PS5 ejecutó con éxito el modelo Qwen 3.8 27B lanzado por el equipo de Alibaba Tongyi Qianwen. El modelo tiene 27 mil millones de parámetros y utiliza una arquitectura de atención híbrida. El objetivo del diseño es proporcionar capacidades sólidas de comprensión del lenguaje, razonamiento y generación de código en recursos de hardware relativamente limitados.
Sin embargo, PS5 no carga 27 mil millones de parámetros directamente en la memoria con total precisión. Para adaptar el modelo a las condiciones del hardware del host, los desarrolladores utilizaron tecnología de cuantificación de bits bajos para comprimir los parámetros del modelo en un espacio de almacenamiento más pequeño. La demostración utiliza versiones cuantificadas como IQ2_XXS, y el archivo del modelo tiene entre varios GB y 7 GB, y el tamaño específico depende del esquema de cuantificación.
La cuantificación es una tecnología clave para ejecutar grandes modelos locales. Normalmente, los parámetros del modelo se almacenan utilizando un formato de datos de mayor precisión, pero esto consume mucha memoria. Al comprimir los parámetros en valores de ancho de bits más bajos, puede reducir significativamente los requisitos de memoria y reducir la cantidad de transferencia de datos durante la inferencia. El costo es que se perderá cierta información de precisión, lo que puede afectar la calidad de la respuesta del modelo, la capacidad de razonamiento o el desempeño de tareas específicas. Por lo tanto, poder ejecutar un modelo de 27 mil millones de parámetros no significa que PS5 pueda ejecutar un modelo del mismo tamaño con total precisión.
Los datos de prueba publicados por el desarrollador muestran que cuando se utiliza la GPU para realizar inferencias, la velocidad de generación de texto de Qwen 3.8 27B puede alcanzar aproximadamente 20 tokens por segundo. Token es la unidad básica para que los modelos de lenguaje grandes procesen texto. No es estrictamente equivalente a un carácter chino o una palabra en inglés. Por lo tanto, 20 tokens por segundo no pueden entenderse simplemente como generar 20 caracteres chinos por segundo. Aún así, eso es lo suficientemente rápido como para que las conversaciones interactivas tengan cierta practicidad, en lugar de ser simplemente una demostración técnica para demostrar que un modelo puede despegar.
Además del modelo Qwen, el mismo proyecto también anunció los resultados de las pruebas de otros modelos. Gemma 4 E4B genera aproximadamente 61 tokens por segundo, mientras que Llama 3.2 3B alcanza aproximadamente 124 tokens por segundo. Los modelos pequeños tienen menos parámetros, requieren menos cálculos y lecturas de datos y, por lo tanto, generalmente alcanzan velocidades de generación más altas.
Estos resultados aún deben considerarse resultados de pruebas publicados por desarrolladores bajo configuraciones de software y hardware específicas, en lugar de puntos de referencia de la industria verificados por una plataforma de pruebas unificada. Los diferentes modelos tienen diferentes escalas de parámetros, métodos de cuantificación, duración del contexto y tareas informáticas. Sus capacidades integrales no pueden juzgarse basándose únicamente en la cantidad de tokens generados por segundo.
El proyecto también demuestra la posibilidad de transformar PS5 en un servidor LAN AI. Al ejecutar una interfaz de servicio compatible con OpenAI API en el host, otros dispositivos pueden enviar solicitudes a través de la misma red y obtener respuestas generadas por el modelo. De esta forma, los usuarios no siempre tienen que estar frente a la pantalla del televisor para operar la consola, pudiendo también llamar al modelo local en la PS5 a través de una computadora o teléfono móvil.
Este enfoque es atractivo para los usuarios que desean implementar servicios locales de IA en sus redes domésticas. Cuando el modelo se ejecuta localmente, en principio no es necesario enviar el contenido de la conversación diaria a servicios de inteligencia artificial en la nube de terceros, y los usuarios no tienen que pagar tarifas de inferencia en la nube en función del número de llamadas. Sin embargo, la protección de la privacidad real aún depende del software instalado, la configuración de la red y si el dispositivo tiene otros comportamientos de transmisión de datos. No se puede considerar que el sistema sea absolutamente seguro simplemente "ejecutándose localmente".
Al mismo tiempo, el desarrollo de PS5LM todavía depende de una serie de tecnologías no oficiales. Los usuarios deben tener una PS5 que pueda ejecutar el programa de craqueo correspondiente y utilizar firmware del sistema compatible y herramientas de carga de carga útil. El rango de firmware aplicable que figura en el documento del proyecto es de 7.00 a 13.60, pero las funciones específicas, el rendimiento y la compatibilidad pueden variar según el modelo de host y la versión del software.
Agrietar la consola no significa que todos los usuarios de PS5 puedan instalar directamente el programa. La versión comercial normal de PS5 no puede descargar ni ejecutar PS5LM a través de PlayStation Store como los juegos normales. Los usuarios primero deben resolver problemas como los permisos de acceso al sistema, la carga de programas no oficiales y el entorno operativo, lo que todavía plantea un cierto umbral para los usuarios que no están familiarizados con el craqueo de hosts y el desarrollo de software.
Además, modificar el sistema host puede conllevar riesgos de seguridad y estabilidad, también puede afectar el uso de los servicios en línea e involucrar los términos de servicio relevantes de Sony. Los desarrolladores recomiendan realizar investigaciones sólo en dispositivos de su propiedad o que hayan autorizado. Para los usuarios de consolas que la utilizan principalmente para juegos normales, especialmente aquellos que se conectan con frecuencia a PlayStation Network, no hay necesidad de piratear precipitadamente el dispositivo sólo para ejecutar la IA local.
Desde la perspectiva del hardware, la importancia de este experimento no es sólo permitir que la consola de juegos responda preguntas. Además, ilustra que la GPU y la memoria de vídeo de alta velocidad instaladas en equipos de juegos de consumo también pueden realizar parte del trabajo que normalmente realizan los equipos informáticos de IA dedicados después de una adaptación adecuada del software.
La inferencia de modelos de lenguaje grande a menudo se ve afectada significativamente por la capacidad de la memoria y el ancho de banda. Cuando el modelo genera texto, necesita leer continuamente una gran cantidad de parámetros y mantener cachés sensibles al contexto. La arquitectura de memoria unificada de PS5 permite que la CPU y la GPU compartan recursos de memoria de alta velocidad, pero el propio sistema también necesita ocupar parte de ellos, por lo que el espacio disponible para los modelos es mucho menor que la capacidad nominal de 16 GB.
Esta es la razón por la que los desarrolladores deben resolver simultáneamente problemas como la cuantificación, la gestión de la memoria y las interfaces informáticas de la GPU. El simple hecho de tener una GPU lo suficientemente potente no garantiza que un modelo funcione sin problemas; si la arquitectura del modelo es compatible, si el controlador puede realizar las operaciones de cálculo requeridas y si el sistema puede proporcionar suficiente memoria para el programa de inferencia afectarán el resultado final.
Este resultado también proporciona una referencia interesante para la selección de hardware de IA local. Tradicionalmente, los usuarios que querían ejecutar modelos de lenguaje más grandes en casa a menudo necesitaban comprar una computadora con una tarjeta gráfica discreta y pagar más por la capacidad de memoria y el costo total de la máquina. La PS5 ya tiene una GPU relativamente potente y una memoria de alta velocidad, por lo que los desarrolladores esperan demostrar que el hardware de juego existente también se puede reutilizar sin tener que comprar una estación de trabajo dedicada a la IA.
Pero esto no significa que la PS5 pueda reemplazar completamente a las computadoras con IA. Sus recursos de hardware todavía están limitados por configuraciones fijas, espacio del sistema y entornos de software no oficiales. En comparación con las computadoras con mayor memoria gráfica, controladores maduros y ricas herramientas de desarrollo, PS5 requiere un trabajo de adaptación más subyacente para ejecutar modelos grandes, y los usuarios no pueden actualizar libremente la tarjeta gráfica o expandir la memoria gráfica como las computadoras AI comunes.
Desde un punto de vista práctico, este tipo de proyecto es actualmente más adecuado para entusiastas de la tecnología, desarrolladores de código abierto y usuarios interesados en la IA local para estudiar el razonamiento de modelos, la computación GPU y los entornos operativos integrados. Para las empresas que necesitan ejecutar de manera estable servicios de inteligencia artificial a nivel de producción, los servidores GPU dedicados o las computadoras optimizadas por pilas de software maduras son aún más adecuados.
El desarrollo de PS5LM también refleja una tendencia en el ecosistema de IA de código abierto: los marcos de inferencia de modelos y los modelos de peso abierto han reducido gradualmente el umbral para ejecutar inteligencia artificial, mientras que los desarrolladores de la comunidad continúan intentando migrar estas herramientas a diferentes plataformas de hardware. En el pasado, las consolas de juegos se consideraban principalmente dispositivos de entretenimiento cerrados; ahora, gracias a los esfuerzos de las comunidades de craqueo e ingeniería inversa, también se han convertido en plataformas para explorar la computación GPU y aplicaciones nativas de inteligencia artificial.
En general, es un intento técnico representativo de permitir que una PS5 crackeada ejecute un modelo de lenguaje grande con 27 mil millones de parámetros a una velocidad de aproximadamente 20 tokens por segundo. Demuestra el uso potencial del hardware de la consola de juegos y también demuestra que mediante la adaptación del software y la compresión de modelos, se pueden ejecutar modelos de lenguaje de cierta escala en dispositivos de inteligencia artificial no tradicionales. Sin embargo, este logro sigue siendo un proyecto comunitario que se basa en un entorno crackeado y todavía hay una distancia considerable entre él y las funciones oficiales que los usuarios comunes pueden usar sin operaciones complicadas.
Comentarios