Resumen:
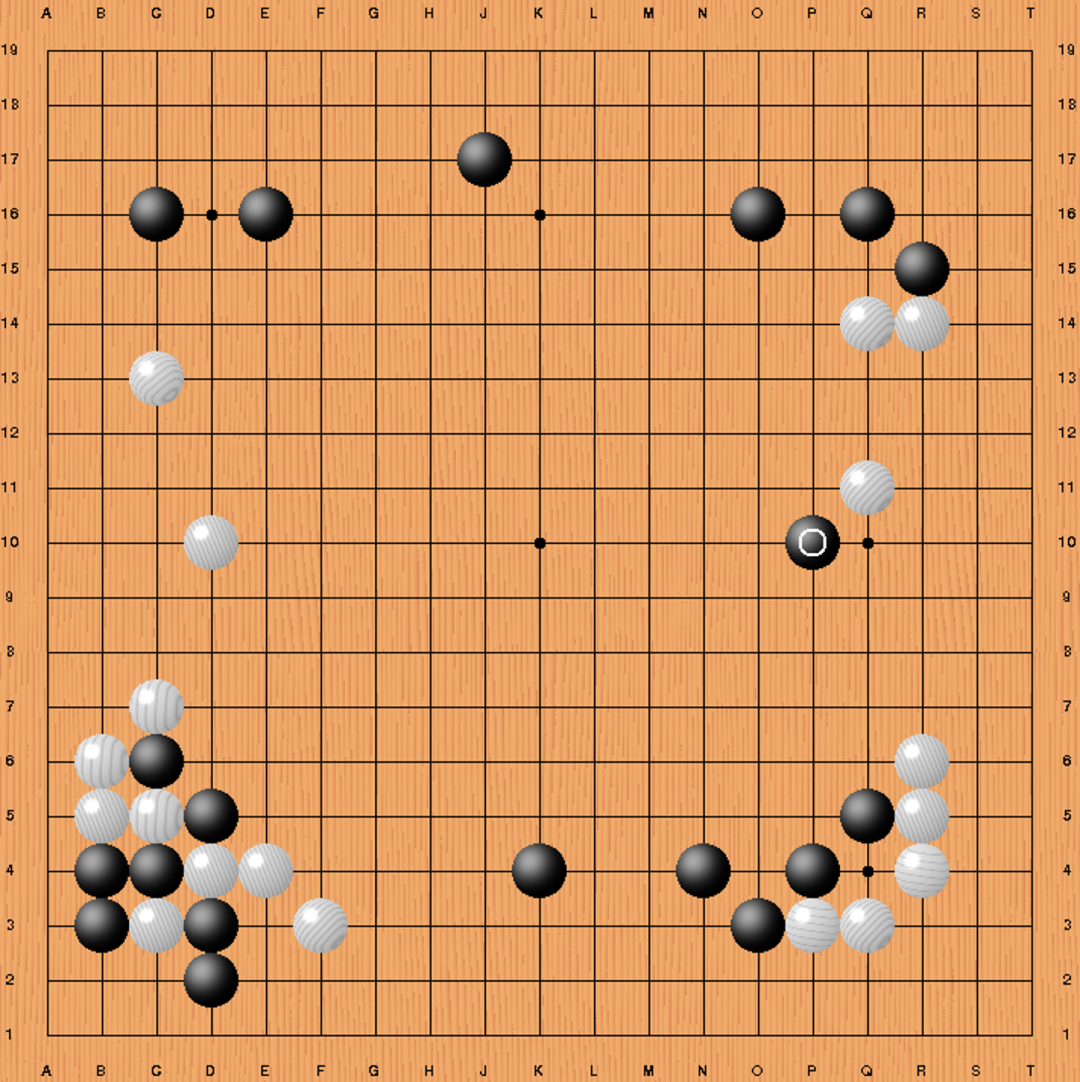
Marzo de 2016, Four Seasons Hotel Seúl. A mitad del segundo juego de la batalla entre humanos y máquinas, AlphaGo dejó caer una mancha solar en la quinta línea. Los comentarios en el sitio se quedaron sin palabras y algunas personas sospecharon que había un error en el programa, porque según el sentido común de los ajedrecistas profesionales, este movimiento era casi un tiro libre.
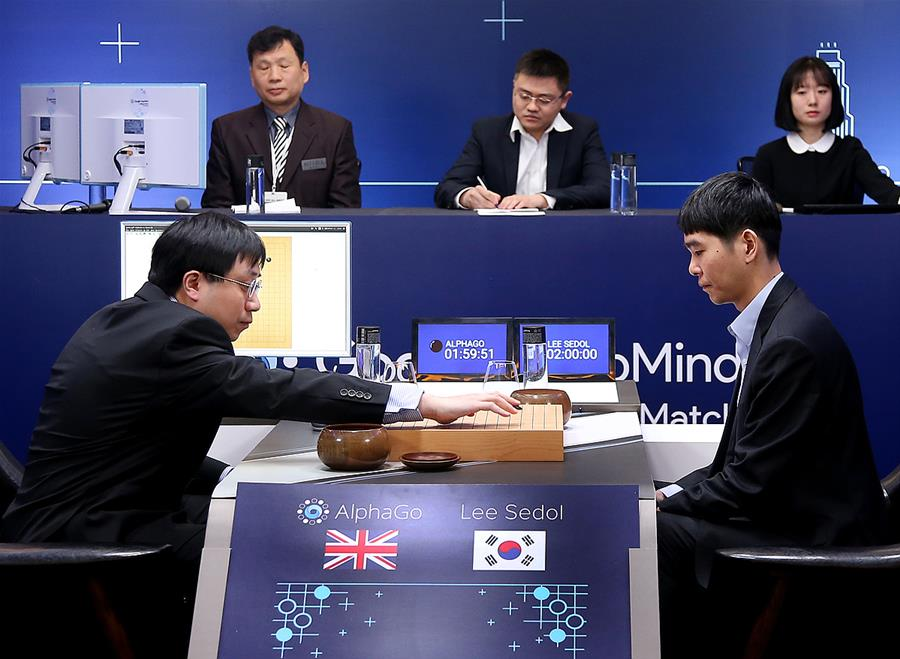
Todo el mundo conoce la historia posterior. AlphaGo no sólo ganó ese juego, sino que también derrotó a Lee Sedol con un marcador total de 4:1. Después del juego, Lee Sedol dijo algo que se cita a menudo: "Originalmente pensé que AlphaGo era solo una máquina basada en el cálculo de probabilidades. Pero después de ver esa mano, cambié de opinión. AlphaGo debe ser creativo".
Ese es el famoso movimiento 37.
Diez años más tarde, el hombre que construyó AlphaGo se puso de pie y dijo: la IA actual no tiene las capacidades en las que se basa ese juego de ajedrez.
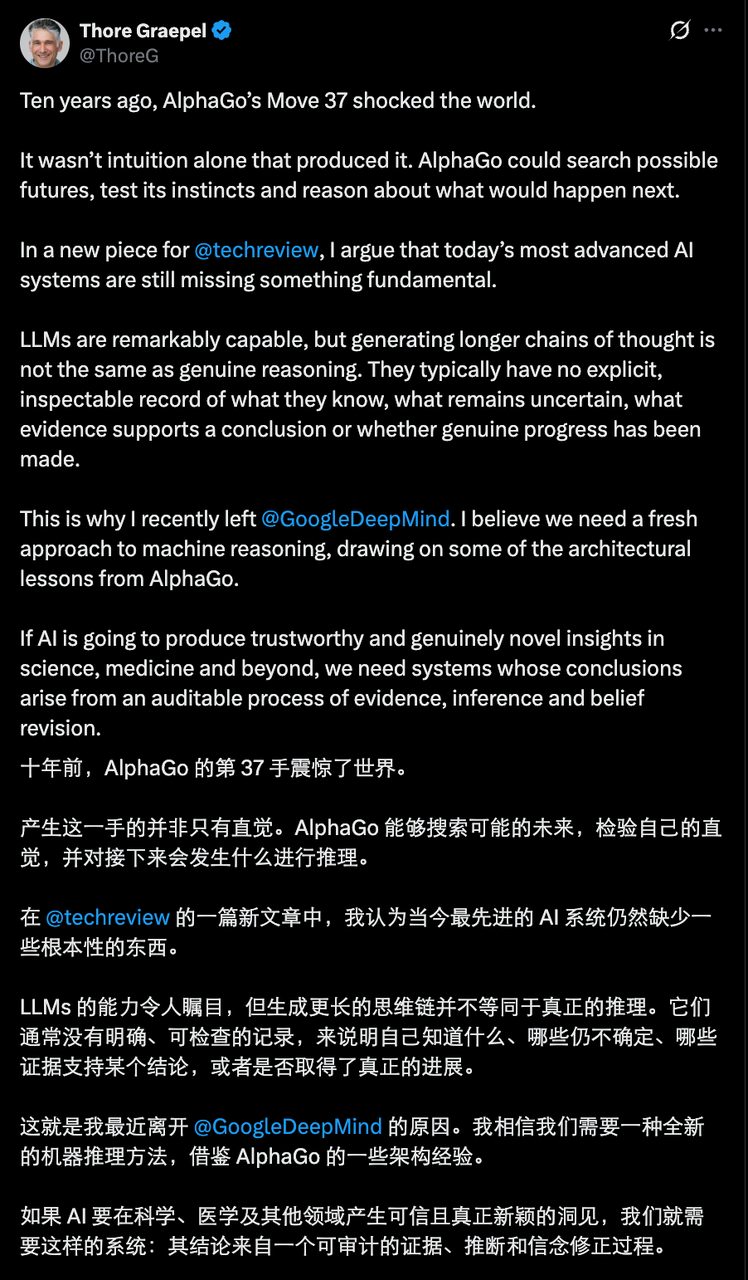
La persona que dijo esto es Thore Graepel, uno de los autores principales de AlphaGo y ha estado involucrado en la investigación del aprendizaje automático durante mucho tiempo. Recientemente, tomó una decisión intrigante: dejar Google DeepMind para iniciar un negocio y hacer algo que considera más importante: equipar a las máquinas con capacidades reales de razonamiento.
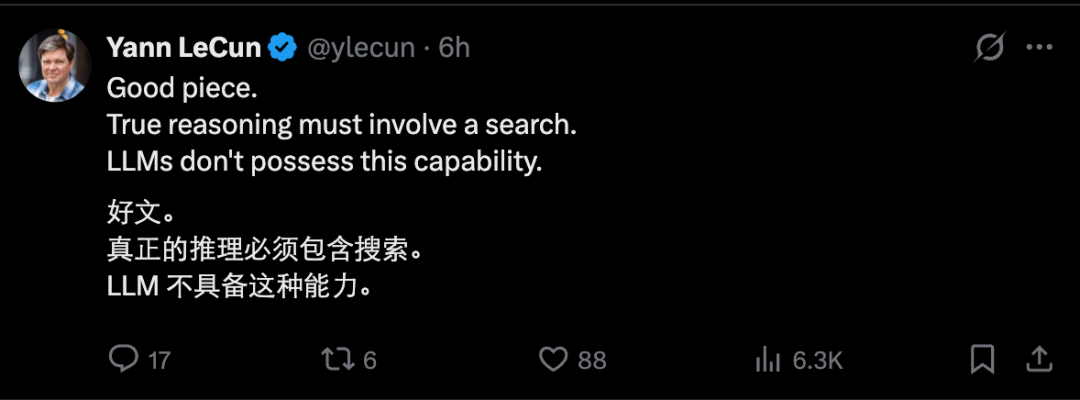
Ese punto conmovedor proviene de un artículo que publicó recientemente en MIT Technology Review. El título del artículo es muy sencillo y se llama "No se deje engañar: los LLM no pueden razonar". Después de leer este artículo, el ganador del Premio Turing Yann LeCun expresó su agradecimiento y enfatizó que "el razonamiento real debe implicar la búsqueda, y LLM no tiene esta capacidad".
¿Por qué Thore Graepel dijo eso? Echemos un vistazo a lo que está escrito en este artículo.
La jugada 37 no fue un “destello de inspiración”,
Es producto del razonamiento
Muchas personas describen el movimiento 37 como un "momento mítico de la intuición de la máquina": en un relámpago, la IA vio un movimiento magistral más allá de los mil años de historia del ajedrez humano. Graepel dijo que este es el mayor malentendido sobre AlphaGo.
Para entender esto, primero debemos desmantelar la estructura interna de AlphaGo. Consta de dos sistemas: uno es una red de políticas, que aprende de enormes registros de ajedrez humanos para predecir "cómo jugará el maestro en esta situación". Esta es la parte intuitiva. El otro es un mecanismo de búsqueda, al que no le importa si una determinada jugada de ajedrez "parece haber sido jugada por un humano", sino que construye explícitamente un árbol de juego que contiene miles de ramas para deducir el futuro al que conduce cada posición candidata.
El punto clave es: a los ojos de la red estratégica, el movimiento 37 no tiene nada de especial: la probabilidad de que un ajedrecista humano profesional realice este movimiento es sólo de 1 entre 10.000. Si sólo escuchas tu intuición, esta mano no será elegida en absoluto. Fue el mecanismo de búsqueda el que descubrió, tras un cuidadoso cálculo, que este movimiento "increíble" conducía a un final mejor.
Graepel toma prestado el famoso marco de Kahneman para explicar esto. El pensamiento humano se divide en dos modos: el Sistema 1 es rápido, intuitivo y sin esfuerzo; El sistema 2 es lento, paso a paso y sopesado cuidadosamente. AlphaGo resulta ser una rara combinación de estos dos modos en la máquina: la red neuronal proporciona la intuición de "este movimiento tiene una oportunidad" y "esta situación se puede ganar", y el mecanismo de búsqueda es responsable de probar estas intuiciones en futuros cambios ofensivos y defensivos. No funcionará sin la mitad: la intuición por sí sola nunca hará el movimiento 37; La búsqueda violenta por sí sola no podrá descartar las posibilidades astronómicas del Go.
Aquí hay otra comparación que a menudo se pasa por alto. Deep Blue derrotó a Kasparov en 1997 confiando en reglas codificadas por humanos para evaluar 200 millones de posiciones de ajedrez por segundo y mirar de seis a ocho pasos por delante. La complejidad de Go está completamente en otro nivel. El valor de una pieza depende del crecimiento y declive del impulso y del campo después de decenas de rondas. Incluso si sólo se calculara una pequeña parte de todos los cambios, una supercomputadora tendría que calcularlos durante miles de millones de años. Por lo tanto, AlphaGo debe aprender a "ver la situación claramente de un vistazo" e incluso crear movimientos en los que los humanos nunca habían pensado. No se gana aplastando la potencia informática, que es crucial.
Modelo de lenguaje grande:
Un sistema entrenado al extremo 1
Veamos la IA actual.
El principio de funcionamiento de los modelos de lenguaje grandes es predecir el siguiente token una y otra vez. Esto es esencialmente el Sistema 1 en acción: rápido, asociativo y capaz de completar patrones sorprendentes en casi todos los campos sobre los que los humanos han escrito alguna vez, pero sin la parte de "pensar antes de responder".
No mucho después de que naciera ChatGPT, la industria se dio cuenta de que la fluidez del idioma por sí sola no podía respaldar una utilidad real. Todo el mundo está familiarizado con el plan de solución: no permita que el modelo se apresure a responder, primero genere pasos intermedios, descomponga el problema y traiga los resultados intermedios, es decir, la cadena de pensamiento.
La mejora de la cadena de pensamiento es real, especialmente en matemáticas y codificación. Pero Graepel señaló un hecho que la emoción oscurece fácilmente: estos pasos intermedios de razonamiento siguen siendo el mismo proceso de "predecir el siguiente token", solo que se repite un poco más antes de dar la respuesta final. No introduce un mecanismo de razonamiento verdaderamente independiente como la búsqueda de AlphaGo. La intuición se estira, pero no se convierte en prudencia.
Además, enumeró tres deficiencias para explicar por qué lo que hace el chatbot no alcanza "el tipo de razonamiento reconocido por los científicos".
En primer lugar, el modelo no tiene un estado cognitivo claro, continuamente actualizado e inspeccionable. Qué hipótesis está considerando en este momento, cuánta confianza deposita en las diversas explicaciones, qué pruebas está sopesando y qué preguntas quedan sin respuesta. Estas cosas deberían revisarse sistemáticamente a medida que llega nueva información, pero no existe tal "libro mayor abierto" dentro del modelo.
En segundo lugar, el modelo no logra la separación entre "qué saber" y "cómo utilizar el conocimiento". El conocimiento y el razonamiento están estrechamente entrelazados en los pesos de la red neuronal y no existe un sistema de creencias independiente y expresado explícitamente.
Tercero y más sutil: las cadenas de pensamiento parecen una deliberación reflexiva, pero las investigaciones han demostrado que los modelos a menudo las inventan después del hecho. La respuesta se obtiene caminando por un lado, pero lo que se te informa es por otro. Una "historia que suena razonable" y un "razonamiento que realmente sucedió" son dos cosas diferentes.
Si el razonamiento es verdadero o falso,
¿Es tan importante?
Si simplemente estás charlando y charlando, puede que no importe si el razonamiento es verdadero o falso. Pero en los campos de alto riesgo que realmente nos interesan (medicina, ingeniería, investigación científica), lo que un sistema alcanza es tan importante como cómo lo alcanza. Cuando algo sale mal, como un error en el diagnóstico o el tratamiento, debemos ser capaces de identificar dónde reside el error: ¿hay algún problema con el proceso de razonamiento, se están aceptando pruebas no válidas o se está haciendo una suposición errónea? En tales escenarios no se puede confiar ni responsabilizar a un sistema que sólo puede inventar historias a posteriori.
Esta es exactamente la razón por la que Graepel dejó DeepMind. Él cree que necesitamos una nueva vía de razonamiento automático y la inspiración proviene de AlphaGo hace diez años.
AlphaGo mantiene un registro de todo su conocimiento de la situación actual en cualquier momento, que es el árbol del juego. El árbol contiene todos los cambios que ha considerado, todos los futuros posibles, y cada movimiento y cada situación está marcado con el juicio de la red neuronal. A medida que avanza la deducción, actualiza continuamente el árbol y finalmente determina el movimiento en función de la información del árbol.
Graepel cree que lo mismo se aplica a los sistemas de razonamiento general: mantener un estado cognitivo que exprese claramente lo que se confirma, lo que está en duda, lo que se ha descartado y las preguntas que permanecen abiertas. Y el "razonamiento" es una serie de "acciones" que cambian este estado cognitivo: derivar conclusiones, desmantelar problemas y, lo más importante, decidir qué preguntas hacer a continuación, qué cálculos hacer y qué experimentos realizar.
Por supuesto, razonar en un mundo abierto es mucho más difícil que jugar al ajedrez. El estado en el tablero Go es completamente visible y las reglas son fijas; En el mundo real, la situación actual se conoce sólo parcialmente, las acciones disponibles son numerosas y complejas, y las consecuencias de las acciones están llenas de aleatoriedad o incluso son completamente desconocidas.
Pero la buena noticia es que el progreso de LLM y otros modelos neuronales a lo largo de los años acaba de proporcionar partes para esto: LLM puede proponer un camino para resolver el problema basándose en información conocida y recursos disponibles; puede interactuar con herramientas a través de API y códigos; puede ayudar a evaluar si una conclusión está respaldada por la evidencia existente. Lo más importante es que debe haber un "árbitro" independiente en el sistema que evalúe cada movimiento de razonamiento basándose en "cuánta incertidumbre se resuelve con este paso" y sólo actualice las creencias cuando estén respaldadas por evidencia. Una vez establecidas las reglas, el sistema puede acumular conocimiento certificado, aprender de experiencias pasadas de razonamiento y mejorar sus propias estrategias de razonamiento.
Graepel le dio a esta imagen una expresión vívida: el método científico con esteroides. Sólo hay un objetivo: producir conocimientos que puedan resistir el escrutinio.
Sistema más grande 1,
El sistema 2 no crecerá automáticamente
Al final del artículo, dejó clara su actitud: no se puede lograr una inteligencia artificial confiable haciendo que el Sistema 1 sea más grande. La escala agudiza la intuición, pero no la prudencia.
La razón por la que el movimiento 37 es importante es porque una máquina defendió una posición, sopesó los posibles futuros y luego seleccionó un movimiento que incluso su propio "instinto" probablemente habría rechazado.
La sociedad humana necesita más "manos de Dios" en los campos del descubrimiento de fármacos, nuevos materiales, el clima y el diagnóstico médico. El tablero de ajedrez no se parecía en nada al Go y nadie nos pasó siquiera las reglas. Tales ideas sólo pueden provenir de sistemas que verdaderamente razonan: conclusiones extraídas de una cadena de evidencia auditable, inferencias y revisiones de creencias, en lugar de una historia convincente inventada después del hecho.
Hace diez años, AlphaGo utilizó su mano número 37 para decirle al mundo que las máquinas pueden superar la intuición humana.
Diez años después, uno de sus creadores nos recuerda: no dejes que el lenguaje fluido te engañe. Ese salto real no le ha vuelto a ocurrir a LLM hasta ahora.
Dijiste que LLM no puede razonar,
¿Es sostenible?
Después de la publicación de este artículo de opinión, causó bastante controversia sobre X.
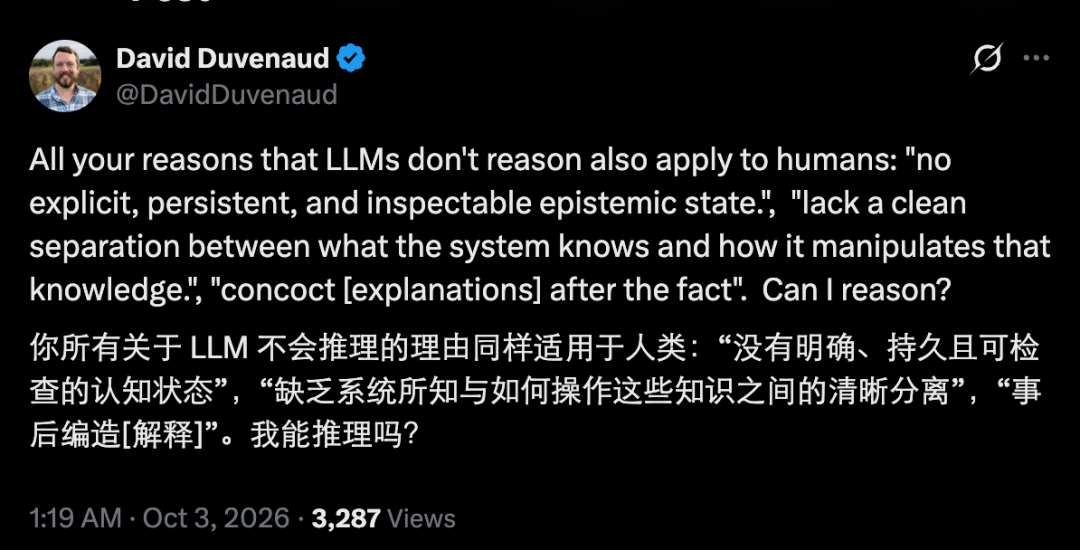
La pregunta más mordaz provino del profesor David Duvenaud de la Universidad de Toronto (uno de los autores del mejor artículo de NeurIPS sobre EDO neuronal). Mencionó: Los tres cargos de Graepel contra LLM (falta de estado cognitivo comprobable, falta de separación del conocimiento y razonamiento, y fabricación de explicaciones a posteriori) son igualmente válidos para los humanos. "Según este estándar, ¿se me puede considerar bueno razonando?"
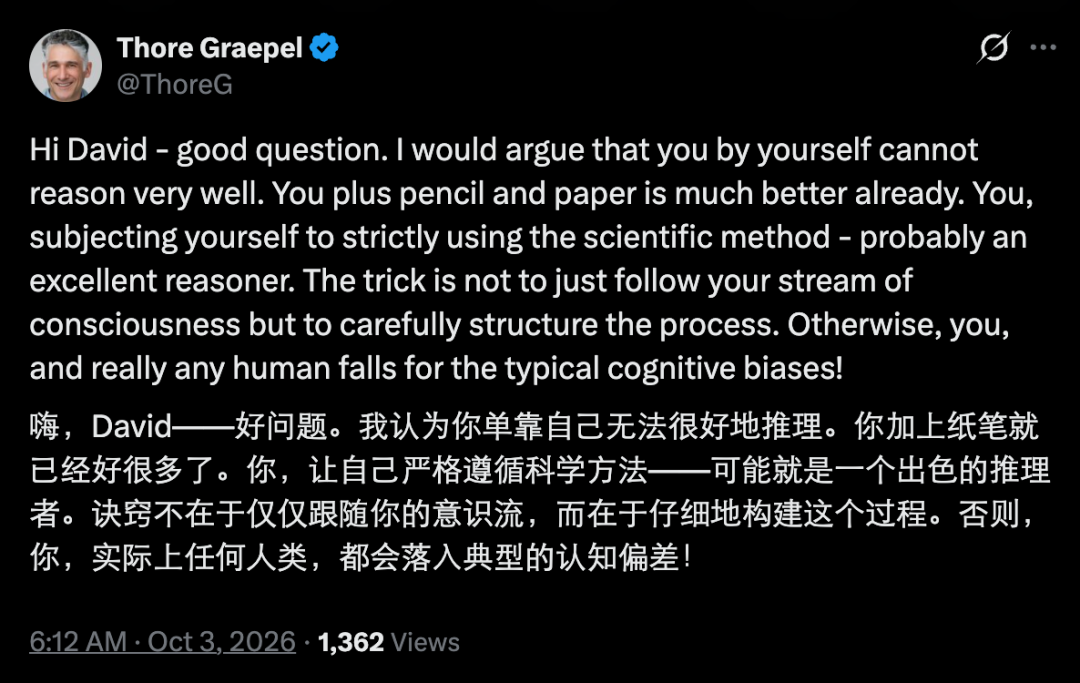
Graepel respondió: No puedes razonar bien por tu cuenta; si te dan papel y bolígrafo, será mucho mejor; y si te piden que sigas estrictamente el método científico, serás considerado un excelente razonador. El truco no consiste nunca en seguir la corriente de la conciencia, sino en estructurar el proceso; de lo contrario, nadie podrá escapar de los sesgos cognitivos.
Duvenaud captó inmediatamente las implicaciones de esta frase: "Parece que podemos lograr un razonamiento real según su definición siempre que equipemos el LLM con herramientas similares. ¿No es esto lo que pretende hacer?"
La "teoría de la mejora del lápiz y papel" de Graepel también atrajo dudas de otros internautas. El internauta KingBroken señaló que el papel y el bolígrafo son esencialmente un complemento para la memoria de trabajo. Te permite razonar sobre más datos al mismo tiempo, pero no cambia la existencia de la capacidad de razonamiento "de la nada"; pero tiene un beneficio adicional: las palabras y los números escritos resultan ser evidencia comprobable del "estado cognitivo" humano.
Inmediatamente después, el internauta Daniel Grant hizo una pregunta más precisa: Según esto, el método de razonamiento humano es equivalente al "modelo existente + sistema de complemento", entonces, ¿está construyendo un modelo con capacidades de razonamiento interno más fuertes que ambos? ¿O me falta algún matiz?
Graepel aún no ha respondido a estas consultas.
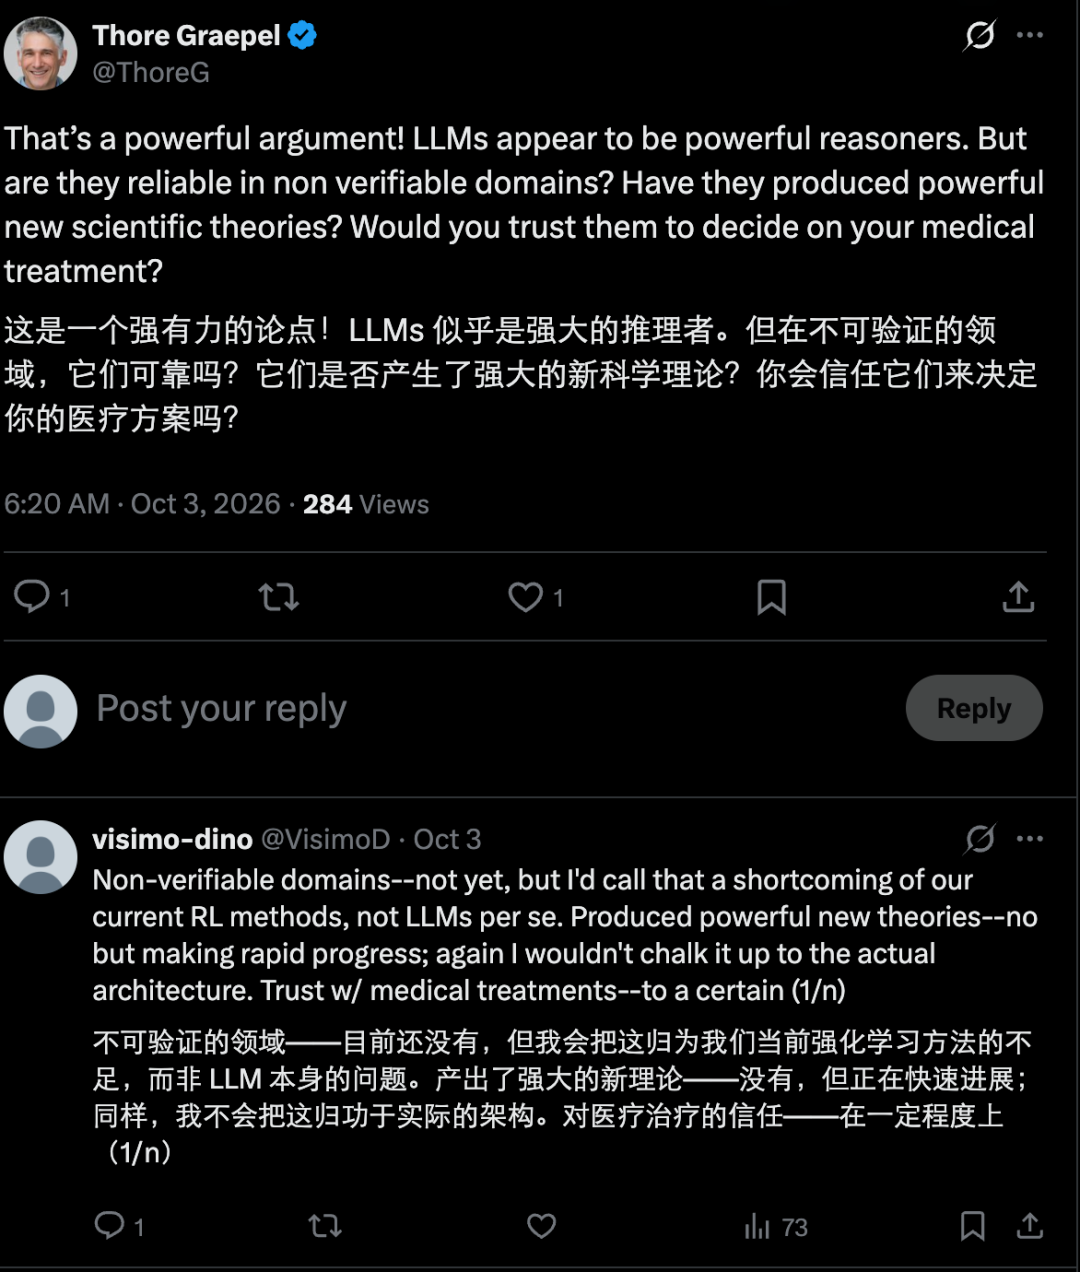
Otra voz consideró que esta discusión era innecesaria. El internauta visimo-dino dijo sin rodeos: "No puedo creer que todavía haya gente escribiendo este tipo de artículos": LLM ya se ha desempeñado bien en demasiadas cosas, y la afirmación "no puedo razonar" es ridícula o irrelevante, y se han publicado cientos de artículos similares.
Graepel no se detuvo en ello, simplemente planteó tres preguntas: ¿Son confiables en áreas donde no se pueden verificar? ¿Ha producido una nueva y poderosa teoría científica? ¿Te atreves a dejar que esto dicte tu tratamiento médico? La otra parte fue franca y admitió que "todavía no", pero culpó a los métodos de aprendizaje por refuerzo existentes en lugar de a la arquitectura LLM en sí; la implicación es que se resolverá con el tiempo. Ésta es probablemente la verdadera diferencia entre los dos grupos: un lado piensa que lo que falta es tiempo y el otro piensa que lo que falta es estructura.
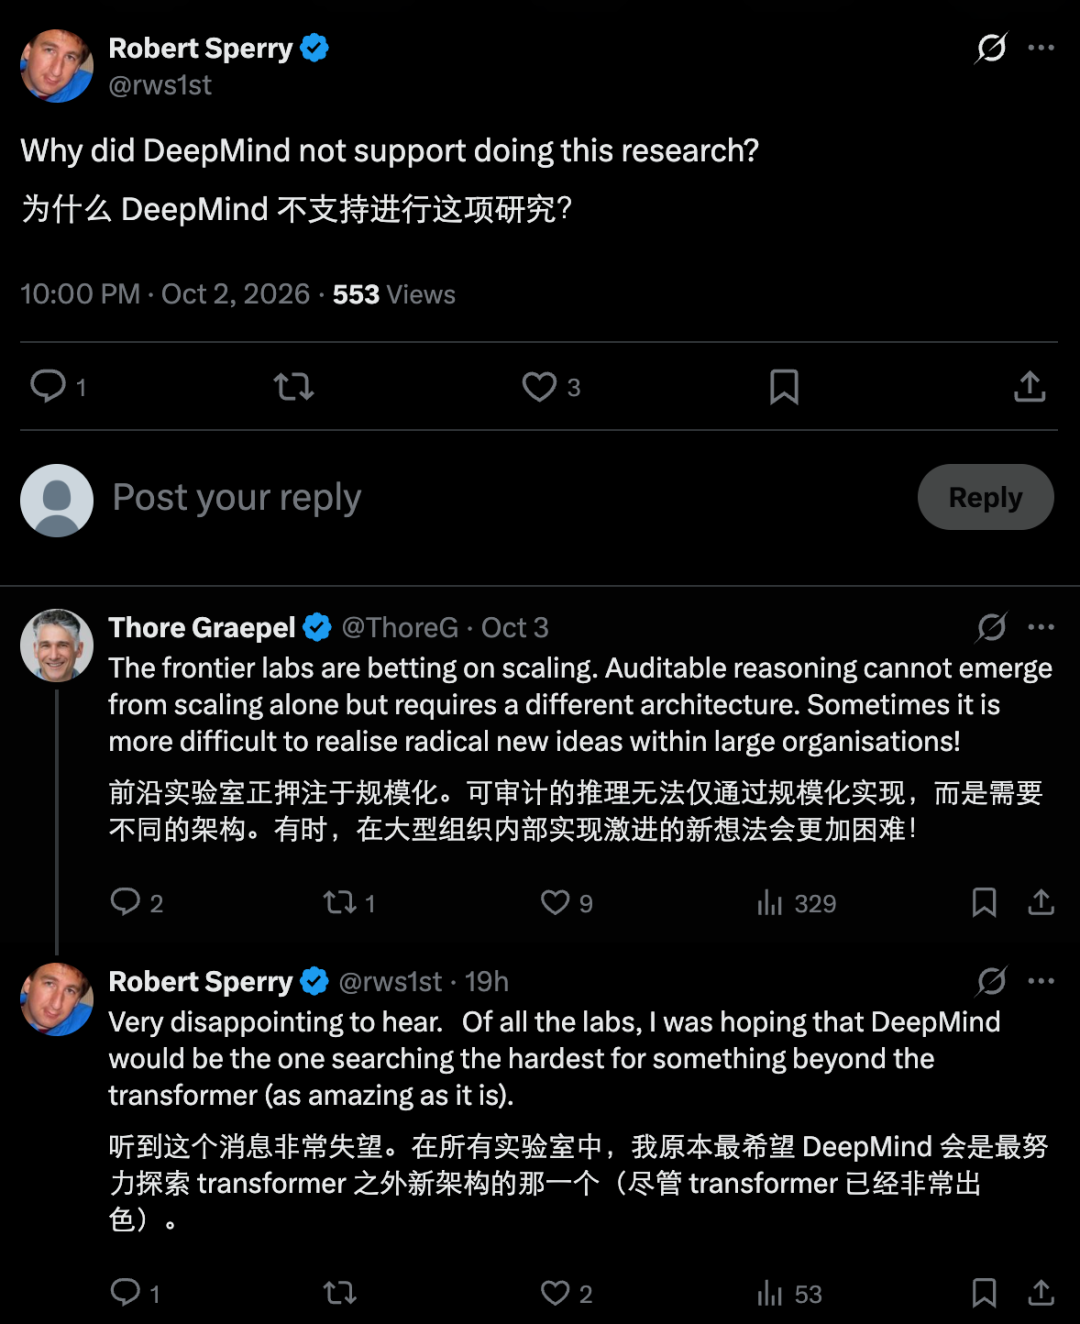
Otro comentario preguntó lo que mucha gente está pensando: ¿Por qué DeepMind no apoya esta investigación? La respuesta de Graepel es sencilla: los laboratorios de vanguardia están apostando por el escalamiento, y el razonamiento auditable no puede surgir únicamente del escalamiento. Requiere una arquitectura diferente. "A veces, las ideas nuevas y radicales son más difíciles de implementar dentro de las grandes organizaciones". La decepción del interrogador, Robert Sperry, fue palpable: de todos los laboratorios, esperaba que DeepMind fuera el que trabajara más duro para encontrar respuestas más allá de Transformer.
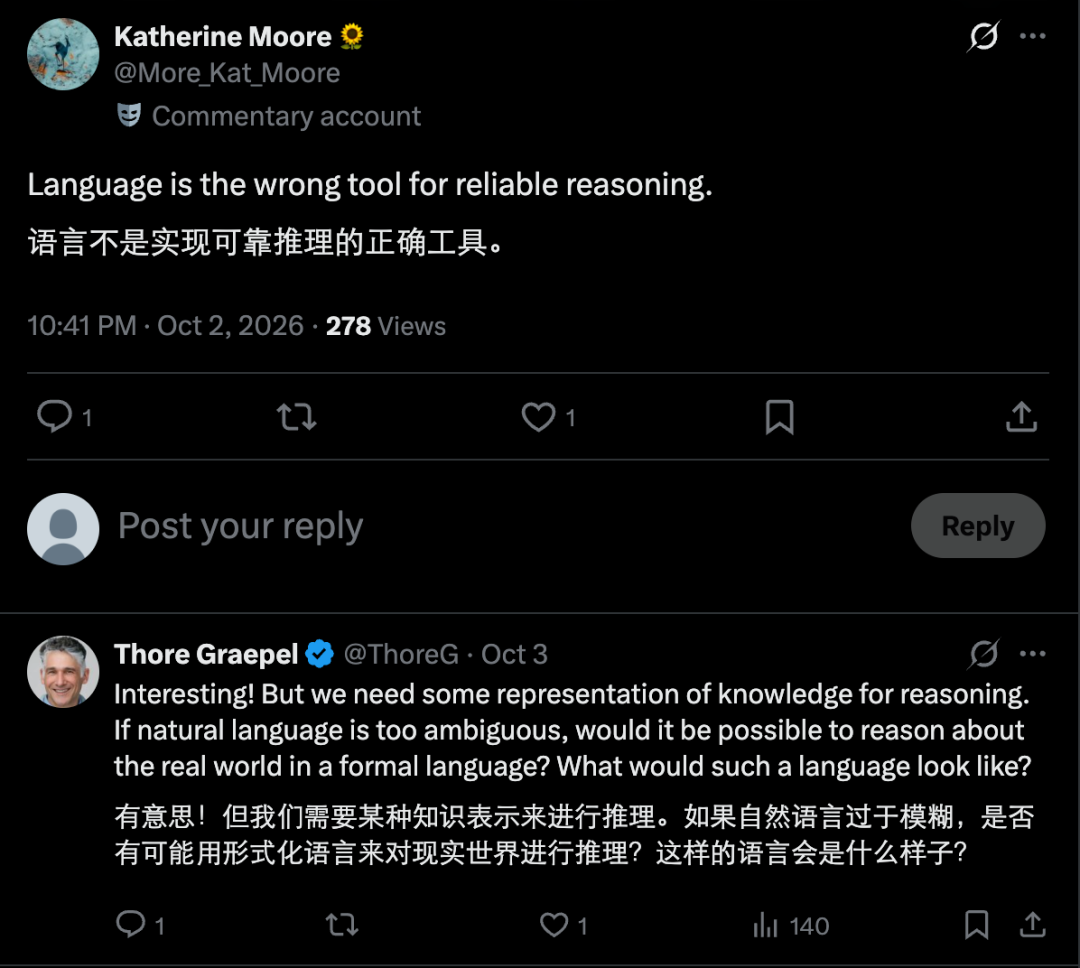
Algunas personas también señalaron con el dedo un lugar más fundamental. La comentarista Katherine Moore dejó sólo una frase: "El lenguaje en sí es una herramienta equivocada y con él no se pueden realizar razonamientos fiables". Graepel tomó en serio esta posición más radical y planteó una pregunta abierta: el razonamiento requiere algún tipo de representación del conocimiento. Si el lenguaje natural es demasiado vago, ¿se puede utilizar el lenguaje formal para razonar sobre el mundo real? ¿Cómo sería ese lenguaje? . No dio una respuesta, pero esta puede ser la pregunta que algunas personas responderán al iniciar sus propios negocios.
Comentarios