
Resumen:
De manera similar, para realizar las 10 tareas de programación correctamente, la nueva versión de DeepSeek costó menos del 40% de Claude Opus 5.5, y la espera promedio para cada tarea fue dos minutos más.
El 17 de octubre, DeepSeek lanzó la versión V4.1-Flash-1017 y el precio se mantuvo sin cambios. Después de su lanzamiento, los desarrolladores ya lo han utilizado para crear juegos, crear páginas web y modificar código.
Para probar su nivel real, el desarrollador Ibragim Badertdinov seleccionó 10 tareas de su trabajo diario y ejecutó diferentes modelos tres veces en el mismo conjunto de herramientas de programación, utilizando el equipo de alta inferencia de DeepSeek V4.1-Flash-1017 y el equipo bajo de Opus 5.5 y GPT-6 Astra.
Después de las pruebas reales, los tres modelos pasaron la prueba, pero la brecha se amplió por la facturación y el consumo de tiempo: DeepSeek solo gastó un promedio de 0,045 dólares estadounidenses por tarea, que fue mucho menor que los 0,1168 dólares estadounidenses de Opus y los aproximadamente 0,26 dólares estadounidenses de GPT-6 Astra; sin embargo, Opus y GPT sólo tardaron 37 segundos y 55 segundos en completarse, respectivamente, pero DeepSeek tardó 2 minutos y 38 segundos.
Estas 10 tareas son todas de pequeña escala. Como proyecto completo, ¿la brecha entre DeepSeek, GPT y Claude es solo cuestión de esperar un poco más?
Aprobó las diez preguntas en 01, DeepSeek ahorra dinero, Opus ahorra tiempo
Los temas que eligió Ibragim surgieron de aproximadamente tres meses de sus propios registros de uso de agentes, que involucraban procesamiento de datos, back-end, front-end e implementación, usando Python y TypeScript. Seleccionó las tareas que normalmente podía completar en menos de una hora y luego les añadió programas de verificación automática.
Un ejemplo simplificado que reveló es importar un lote de datos a una tabla de datos local. Además de importar con éxito, el programa también debe omitir registros duplicados, rechazar números conflictivos e informar datos insatisfactorios; al reemplazar datos antiguos, no puede destruir el contenido original a la mitad de la escritura. La prueba comprobará si hay entradas vacías, conflictos de datos, daños en el archivo original, etc.
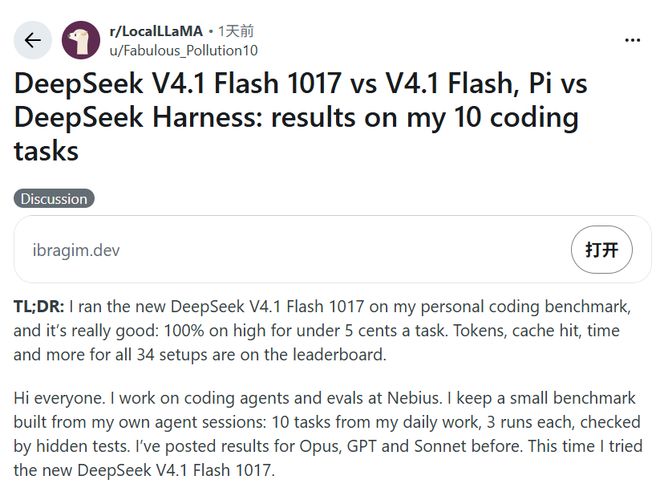
Los tres modelos pasaron estas comprobaciones, pero DeepSeek tomó más medidas.
También ejecutándose en la herramienta de programación Pi, DeepSeek toma un promedio de 15,3 pasos por tarea, Opus toma 3,7 pasos y GPT-6 Astra toma 6,5 pasos. El uso total de tokens de DeepSeek es de aproximadamente 547.000 y el de Opus es de aproximadamente 31.000.Consumo mucho, pero la cuenta no sube. Ibragim explicó que casi todas las entradas de DeepSeek llegan al caché y la tasa de aciertos del caché registrada alcanzó el 97,9%. Los 547.000 tokens no fueron escritos recientemente por el modelo. Una respuesta tan larga incluía contenido que se envió repetidamente en múltiples rondas de llamadas. Las entradas baratas en caché mantuvieron el costo de esta prueba por debajo de los 5 centavos por prueba.
Para los usuarios, el impacto de estos dos minutos depende de si han estado esperando frente a la pantalla. Después de entregar la tarea y luego hacer otras cosas, la espera puede no ser un obstáculo; Si desea realizar la siguiente ronda de modificaciones inmediatamente después de ver los resultados, la velocidad de Opus y GPT en este conjunto de pruebas es más útil. Lo que se compara aquí es el costo de completar tareas a través de la API, no la tarifa mensual de los paquetes de suscripción ChatGPT o Claude.
La nueva versión también ha sido mejorada en comparación con la versión anterior. Ibragim utilizó previamente la configuración de inferencia más alta de la versión de Flash de septiembre para realizar pruebas y pasó 28 veces de 30 ejecuciones, con un tiempo promedio de 4 minutos y 30 segundos para cada prueba. Esta vez, usando la nueva versión de la configuración de alta gama, pasó las 30 veces y el tiempo se redujo a 2 minutos y 38 segundos.
02 Construí un BMW por 0,38 dólares, pero me llevó 40 minutos ejecutar una página web normal
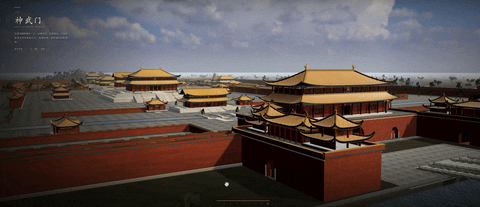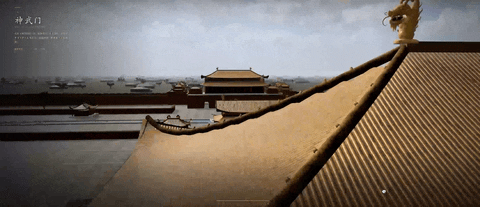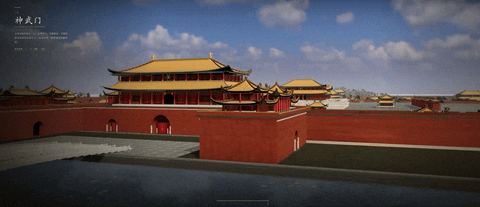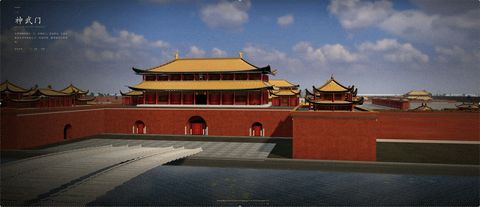
Lo que DeepSeek quiere mostrar esta vez no es sólo completar una función. Los casos publicados oficialmente incluyen la escena 3D de la Ciudad Prohibida, un juego de carreras web y una demostración de reproducción de "Portal 2" producida con Godot. La compañía dice que la nueva versión mejora la capacidad de completar proyectos desde cero mediante el aprendizaje reforzado con autorretroalimentación.
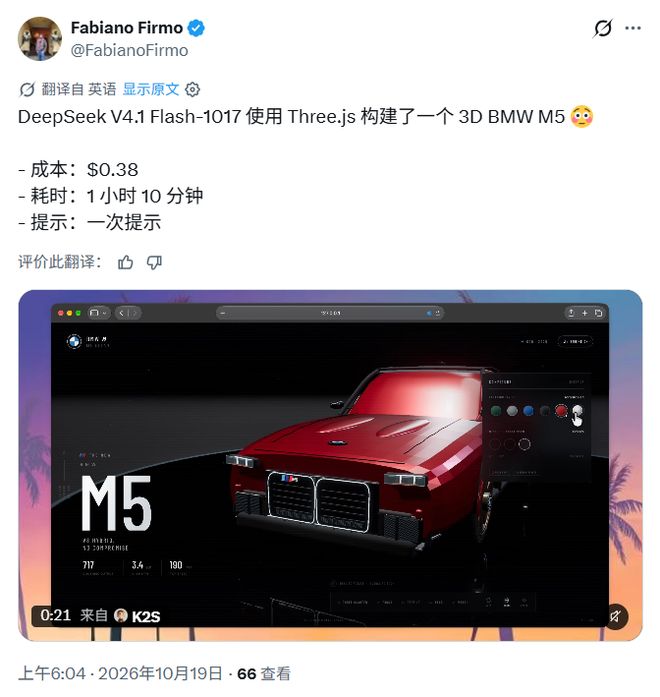
El desarrollador Fabiano Firmo le pidió que usara Three.js para crear un modelo 3D del BMW M5. En la imagen que publicó, aparece un auto rojo en la página de visualización, con opciones de color al lado.
Según él, esta vez solo dio un recordatorio, que costó 0,38 dólares y tardó 1 hora y 10 minutos.
Algunos usuarios también demostraron un juego similar a "Rocket League", donde los coches juegan al fútbol en el campo. El usuario de X Markets & Mayhem comentó que los efectos físicos funcionan normalmente y es jugable, pero aún necesita pulirse. Para alguien que primero quiere crear un prototipo de una página web o un juego, es más fácil ver el uso de estas demostraciones que los resultados de los exámenes modelo.
Sin embargo, estar dispuesto a esperar más de una hora para ver un coche en 3D no significa que esté dispuesto a esperar tanto para crear una página web normal y corriente.
El desarrollador Alex Carter dijo que le pidió a DeepSeek Harness que creara una página de inicio normal, que tardó 41 minutos en ejecutarse; las siguientes dos tareas de la página web tomaron otros 43 y 40 minutos respectivamente. Pensó que el modelo era inteligente, barato y bien presentado, pero las páginas requerían años de trabajo y normalmente se podían completar en diez minutos.
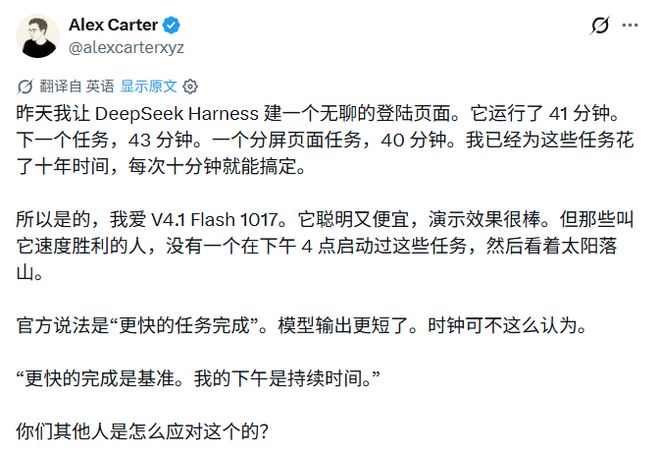
El desarrollador unbug también tiene una sensación similar: el modelo se ha vuelto más inteligente, pero es fácil pensar demasiado y retrasar la acción. Otro usuario, Elshayib, enfatizó que su queja no se refería a la cantidad de palabras producidas por segundo, sino que el modelo tardó demasiado en pensar antes de actuar.
Una prueba de la plataforma API OmniaKey registró este largo razonamiento. Requiere la nueva versión de Flash para escribir un programa que calcule expresiones de acuerdo con las reglas de operación de Python y no puede llamar a herramientas de análisis listas para usar. El modelo tardó unos 88 segundos en pasar los 30 casos de uso de inspección; De los aproximadamente 20.700 tokens producidos, aproximadamente 19.700 se consideraron contenidos.
Pero Flash no es lento para todas las tareas. En otra prueba de OmniaKey, extrajo 10 campos de un correo electrónico de factura que estaba mezclado en alemán e inglés, y los respondió todos correctamente en 5,2 segundos; la llamada a la herramienta para consultar el clima y la hora en dos ciudades se completó en 2,6 segundos. La propia OmniaKey vende el modelo API y cada una de este conjunto de pruebas solo se ejecutará una vez.
Estos ejemplos de modelos de BMW y páginas de destino no son comparaciones de los tres modelos sobre el mismo tema. Aún es necesario comparar el producto terminado de DeepSeek y cuántas veces se revisará más adelante con GPT y Claude bajo los mismos requisitos.
03 Después de bajar la marcha, fue un minuto más rápido y hubo tres fallos más
Dado que la configuración de inferencia alta lleva mucho tiempo, ¿qué pasará si se reduce? Ibragim también lo probó.
En Pi, después de que la nueva versión de DeepSeek se ajusta a la configuración baja, el tiempo promedio por elemento se reduce de 2 minutos y 38 segundos a 1 minuto y 31 segundos, y el costo se reduce de USD 0,045 a USD 0,0257. Sin embargo, 3 de 30 carreras fallaron.
Todos los pases obtenidos en niveles altos no se pueden conservar intactos.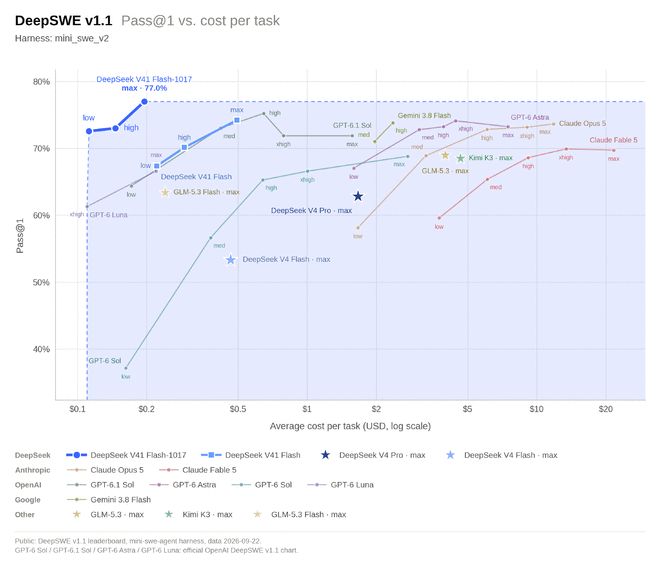
En este nivel bajo, cambié al propio Harness de DeepSeek y los resultados cambiaron nuevamente: pasó 29 veces en 30 ejecuciones, dos más que Pi. Según los registros de Ibragim, el entorno de herramientas oficial ayudó al modelo a manejar una condición de contorno que no se encontraba en Pi.
Los dos conjuntos de herramientas funcionan de manera diferente con los modelos. DeepSeek Harness proporciona directamente herramientas para leer y editar archivos, mientras que Pi permite principalmente operar el modelo a través de la línea de comandos; las palabras de aviso del sistema del primero también son más largas. Después de cambiar las herramientas esta vez, el uso de tokens aumentó aproximadamente un 75% y el tiempo promedio invertido aumentó de 1 minuto y 31 segundos a 1 minuto y 53 segundos. En ambos conjuntos de herramientas, solo se pueden completar 9 tareas tres veces seguidas.
Para el mismo modelo, si cambia el equipo de inferencia y el conjunto de herramientas, la velocidad, el costo y el éxito cambiarán.
Solo ve los resultados publicados por otros, pero también necesita saber qué configuraciones utilizaron.DeepSeek también mencionó claramente cuando se lanzó que tenía herramientas optimizadas como DeepSeek Harness, Tencent CodeBuddy y WorkBuddy, y recomendó a los usuarios de Harness que actualizaran a v0.2.1-rc.1 o superior.
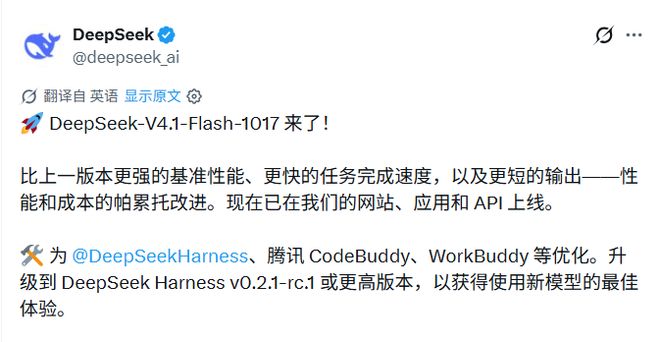
Esta actualización se lanzó en páginas web, aplicaciones y API. Las llamadas API todavía usan deepseek-flash y el precio permanece sin cambios; Los pesos del nuevo modelo también se han hecho públicos según el protocolo del MIT.
Sin embargo, la prueba de programación anterior se completó conectando el modelo a una herramienta que puede leer archivos, modificar código y ejecutar comprobaciones. Pedirle que escriba un fragmento de código en la ventana de chat es diferente a pedirle que se haga cargo de un proyecto. El entorno de uso es diferente.
04Para el mismo conjunto de preguntas, GPT y Claude pueden ser más baratos
Opus y Astra son los buques insignia de las dos empresas, y OpenAI y Anthropic también tienen modelos más baratos.
En el mismo conjunto de pruebas de Ibragim, la marcha xalta de GPT-6 Luna y la marcha alta de Haiku 5.5 pasaron 30 veces. El costo promedio de cada artículo fue de solo 0,0145 dólares estadounidenses y 0,0208 dólares estadounidenses respectivamente, lo que es más bajo que el de DeepSeek.
El consumo de tiempo medio de los dos es de 2 minutos y 46 segundos y 2 minutos y 08 segundos respectivamente.Esto hace que la elección ya no sea sólo "GPT caro, Claude" o "DeepSeek barato". Es posible que las personas que ya usan Luna o Haiku para realizar tareas pequeñas no puedan ahorrar más dinero cambiando a Flash.
Las tareas más difíciles cambian la cuestión de cuánto tiempo esperar a si puedes confiar en los resultados. El usuario de X, Yum, dijo que después de probar la nueva versión, todavía está más preocupado por las alucinaciones, especialmente la reconstrucción y modificación de la arquitectura en múltiples archivos. Haría que otro modelo verificara los cambios en lugar de dejar que DeepSeek aprobara su propia solución. Esta es su elección de uso, no una prueba sobre la misma pregunta para demostrar que GPT o Claude son más confiables.
Por lo tanto, el progreso más sólido en la actualidad es que la nueva versión de DeepSeek ha arrojado los mismos resultados de inspección que el modelo insignia en un lote de tareas de programación realmente pequeñas.
Cuántas correcciones manuales se necesitan en proyectos grandes y si los problemas se pueden reparar determinarán hasta dónde puede llegar este reemplazo.
Todavía queda mucho trabajo entre construir un coche 3D y mantener un proyecto a largo plazo.Ibragim también se está preparando para hacer esta prueba más difícil. Dijo al final de la publicación que el siguiente paso sería seleccionar un grupo de tareas mucho más difíciles y comparar diferentes herramientas y modelos.
Comentarios