Resumen:
El 9 de noviembre, hora local, Anthropic lanzó Claude Fable 5.2 y Claude Mythos 5.2. Ambos comparten el mismo modelo subyacente. Fable está disponible para todos los usuarios y tiene protecciones integradas de ciberseguridad y bioseguridad; Mythos elimina estas restricciones y solo está abierto a instituciones que pasen el programa de verificación Cyber o Life Sciences.
Después de su lanzamiento, las descripciones de todos eran casi las mismas: más fuerte y más rápido. Algunos desarrolladores también sienten que el precio es incorrecto a primera vista. Para la codificación, Fable 5.2 no es rentable. Sin embargo, la propia Anthropic dijo en la documentación del lanzamiento que para la mayor parte del trabajo de codificación y conocimiento, se recomienda que todos "comiencen con Claude Opus 5.5".
Los modelos más potentes de la historia se actualizan constantemente, pero no queda mucho tiempo para utilizarlos. Antes de alcanzar AGI, las empresas de IA alcanzaron el techo de comercialización.
Los más fuertes siguen fortaleciéndose, ¿ha surgido el prototipo de fuerza laboral digital?
Primero, hablemos de sus puntos fuertes. FrontierCode 2.0 prueba "si los mantenedores de proyectos de código abierto están dispuestos a fusionar código escrito por modelos". En el nivel de potencia informática más alto, Fable 5.2 logró el 49,1%, mientras que la generación anterior Fable 5.1 logró el 32,4%.
El Índice de Trabajo Remoto, que mide cuántas tareas de trabajo remoto en el mundo real puede completar un modelo de forma independiente, se duplicó con creces, del 17,9 % al 41,3 %.
Anthropic también tiene una prueba interna de simulación de robots, RoboDojo Sim, cuya puntuación mejoró del 27,6 % al 64,9 %. Sin embargo, este número proviene de las operaciones internas de la empresa y no puede ser reproducido por el mundo exterior.
Luego está el punto débil. También en la tabla de comparación oficial, en AutomationBench, el 51,4% de Fable 5.2 perdió frente al 53,9% de Google Gemini 4 Carbon.
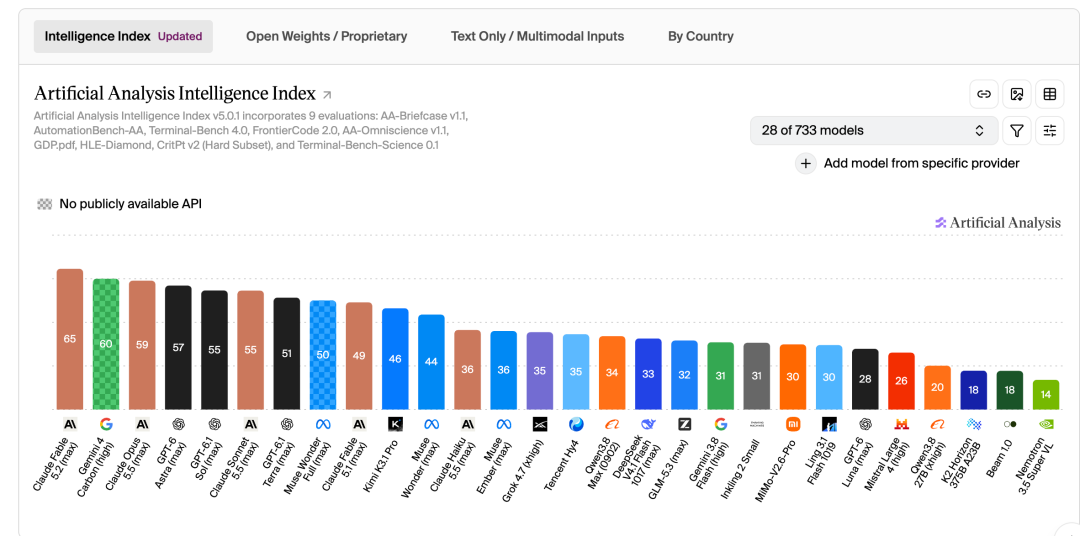
En la lista inteligente de la plataforma externa Artificial Analysis, Fable 5.2 encabezó la lista con 65 puntos, superando con creces a Gemini 4 Carbon en segundo lugar con 60 puntos y 9 puntos detrás de GPT-6 astra en cuarto lugar.
¿Qué tan fuerte es? En más de un día, se completó directamente una gran hazaña en la historia de las matemáticas humanas.
En 30 horas, se completó la verificación formal del último teorema de Fermat; Además, también se resolvieron dos problemas no resueltos de física relacionados con los agujeros negros y la gravedad cuántica. También puede operar un sistema operativo de forma totalmente independiente, diseñar y fabricar de forma independiente equipos electrónicos y predecir la estructura de la cápside de virus adenoasociados complejos...
Algunas personas creen que Fable 5.2 significa que la IA está pasando de una herramienta de productividad a una fuerza laboral digital con capacidades de ejecución de ingeniería.
Sin embargo, muchos grupos de desarrolladores creen que esto puede significar que Anthropic ha "llegado a su fin" en la dirección de codificación. Si no desarrolla algunas vías y modelos nuevos, será difícil estimular las percepciones de los inversores. Y ahora coincide con el período crítico para que Anthropic se apresure hacia el precio de la OPI.
El precio está muy por delante, por lo que Anthropic recomienda no usarlo
Sin embargo, cuando muchos desarrolladores estaban entusiasmados por probar las capacidades de Fable 5.2, descubrieron que había algún problema con el precio.
El precio estándar de Fable 5.2 es de $8 por entrada y $40 por salida por millón de tokens, lo que parece ser una caída del 20 % con respecto a los $10 y $50 de la generación anterior, y la velocidad de salida es hasta un 30 % más rápida que la de 5.1. Si es demasiado lento, puedes activar el modo rápido, que aumenta la velocidad 2,5 veces y duplica el precio. La entrada es de $16 y la salida es de $80.
Intuitivamente, el coste por tarea en Análisis Artificial también está muy por delante.
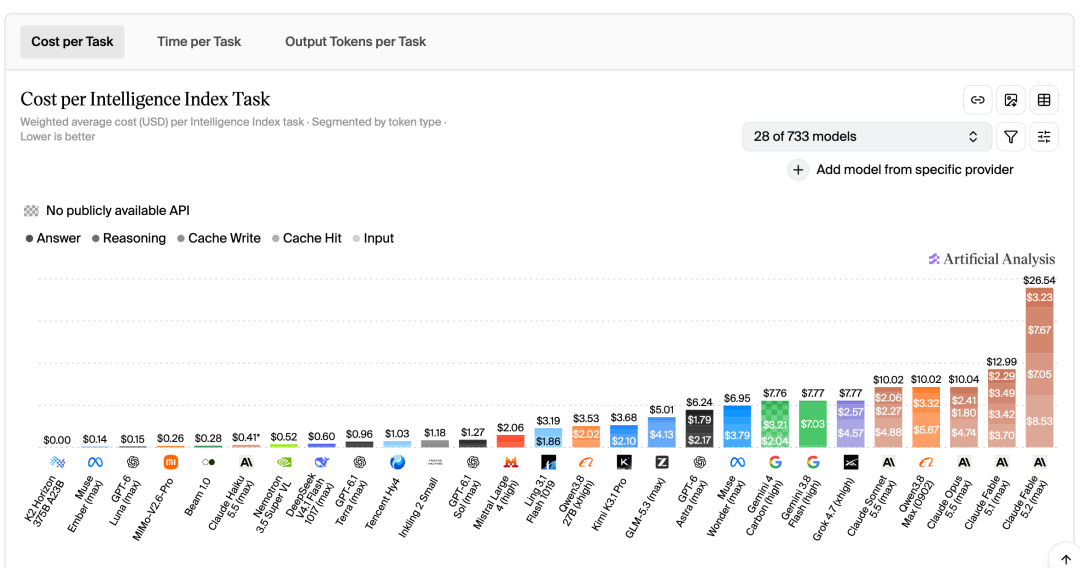
Sin embargo, el propio Anthropic puso una curva de "precisión del código versus costo por tarea" en los materiales de lanzamiento y concluyó que en el nivel de potencia de procesamiento medio, el 45,3% de Fable 5.2 ya está cerca del nivel más alto de 45,5% de Opus 5.5, y el costo de completar una tarea es solo aproximadamente la mitad.
En la actualidad, los funcionarios de Anthropic han cambiado la escala para medir el consumo inteligente. En los últimos dos años, la comparación de precios de la industria se basó en cuánto costaba por millón de tokens. Esta vez fue reemplazado por el costo por tarea completada. Los resultados medidos por dos reglas pueden ser completamente opuestos. Un modelo cuyo precio unitario simbólico es un 20% más barato puede costar el doble si se necesitan tres rondas más para hacerlo bien.
Además, la recomendación oficial de Anthropic es: "Para la mayor parte del trabajo de codificación y conocimiento, recomendamos que los usuarios comiencen con Claude Opus 5.5".
En comparación con el nivel de precios actual, DeepSeek V4.1-Flash cuesta 0,3 dólares por millón de entrada y 1,2 dólares por millón de salida, Kimi K3.1 Pro cuesta 2 dólares por millón de entrada y 10 dólares de salida, y la versión estándar GPT-5.5 cuesta 5 y 30 dólares. El Fable 5.2 se sitúa en la cima, a 8 y 40 dólares.
En otras palabras, este modelo es muy caro cada vez que se abre. Su valor radica en abrirlo una vez en un momento crítico, no todos los días.
En este sentido, Anthropic le ha asignado dos nuevos roles. Uno es Consejero. Modelos baratos como Haiku, Sonnet y Opus acuden a preguntar cuando tienen problemas. El otro es Orchestrator, un programador. No lo hace personalmente, sino que divide las tareas y las asigna a modelos más pequeños que se encuentran debajo.
Stronger than the Strongest sigue renovándose, pero ya no es lo más importante
Anthropic dijo que un ingeniero le dio a Fable 5.2 una carpeta vacía, que coordinó más de 1000 subagentes y se ejecutó continuamente durante 8 días, y finalmente entregó un prototipo de sistema operativo que podía iniciarse en una computadora portátil, con su propio kernel, disco, teclado y controlador de red, almacenamiento de archivos, ventana, interfaz de inicio de sesión y programa de instalación.
Otro conjunto de agentes migró uno de los servicios de producción propios de Anthropic de Python a Rust, y la velocidad de inicio fue aproximadamente 26 veces más rápida después de la migración.
Incluso está involucrado en hardware. Anthropic dijo que colaboró con el fabricante de placas de circuito Diode para diseñar tres productos: un asistente de voz doméstico, un altavoz de conferencia USB y una mascota electrónica de mano, que incluye placas de circuito, carcasas y software. Las placas pueden funcionar sin modificaciones eléctricas una vez construidas.
La muestra matemática es esta. Alrededor de 1.000 agentes dedicaron menos de 30 horas a traducir la prueba existente del último teorema de Fermat a una forma que Lean pueda verificar paso a paso. Hacer lo mismo en septiembre de este año requirió 11 días, un andamiaje especial y una orientación completa por parte de los investigadores; Esta vez, solo se utilizó un tercio del token de salida y la longitud de la prueba fue aproximadamente un séptimo de la longitud original.
Estos casos suenan como un alarde. Pero si reemplaza "1000 subagentes" por "1000 subordinados", encontrará que en realidad describe una estructura organizacional, no un modelo.
Un experto de la industria cree que la competencia por los mejores modelos ha convergido, es decir, convergencia de precios y convergencia de datos. El siguiente paso es sin duda la etapa de "aplicación", donde el límite superior de capacidades del modelo y el límite inferior de precio se llevan a cabo al mismo tiempo, lo que significa que la IA se puede utilizar para diferentes exploraciones diferenciadas. Para entonces, para los fabricantes de modelos, la competencia serán dimensiones como el arnés, la memoria y los hábitos de uso.
En este punto, podemos ver que los grandes fabricantes de modelos están haciendo arreglos. Por ejemplo, DeepSeek y OpenAI también están completando el mismo conjunto de capacidades.
En agosto de este año, DeepSeek abrió DeepSeek Harness bajo la licencia del MIT. El 17 de octubre, cuando DeepSeek lanzó V4.1-Flash-1017, dejó claro que el nuevo modelo estaba optimizado para productos inteligentes como DeepSeek Harness, Tencent CodeBuddy y WorkBuddy. Y Cui Tianyi, del equipo de arneses, ha estado reclutando personas a gran escala. Ifeng Technology aprendió anteriormente de expertos de la industria que el propio Liang Wenfeng es mejor en "esta también es el área".
También el 5 de noviembre, Kimi acaba de lanzar Kimi Hosted Agents (agentes alojados), proponiendo oficialmente Harness as a Service.
El mismo día, Cat Wu, responsable de los productos de Claude Code en Anthropic, se unió a OpenAI y fue responsable de la gestión de productos del equipo central de productos. Estuvo involucrada en impulsar Claude Code desde prototipos internos hasta productos comerciales ampliamente utilizados, y luego se unió brevemente a Cursor.
Claude Code es uno de los productos más representativos de Anthropic en el mercado de la programación de IA. Cat Wu tiene experiencia directa en su proceso desde la concepción del producto hasta la comercialización. El reclutamiento de ella por parte de OpenAI obviamente significa fortalecer las capacidades de Codex y productos de Agentes más amplios.
De hecho, justo antes del lanzamiento de Fable 5.2, se "filtró" el supuesto nuevo modelo de Gemini. El usuario @chetaslua comentó que "lleva el doble de tiempo y la cantidad de código se duplica". Este es un nuevo punto de control para Gemini 4 cuyo nombre en código es "krypton" dentro de Google. Se dice que el rendimiento en imágenes de generación de código y escenas 3D supera significativamente al carbono recientemente lanzado. Por tanto, la velocidad de actualización de los modelos superiores está aumentando. Algunas personas piensan que se debe al RSI; de lo contrario, no hay forma de explicarlo.
Entonces surge la pregunta. Si la inteligencia ya no es un problema, ¿qué es entonces la competitividad? ¿Cómo será el próximo concurso de modelos? La respuesta pronto será revelada.
Comentarios