
Resumen:
Ayer, DeepSeek abrió directamente su propia tecnología de "máquina de impresión de dinero" que se encuentra debajo de la caja. Publicaron un blog técnico titulado "Práctica de implementación de inferencia a gran escala de Flash DeepSeek V4.1" y crearon convenientemente el marco de inferencia del servicio en la nube "DeepInfer" que admite sus propias decenas de miles de millones de llamadas en línea, junto con el componente de segmentación de palabras a nivel de producción "deepseek-recipe", de código completamente abierto bajo el protocolo Apache 2.0.
Incluso se afirmó en el blog que en el futuro, el código de inferencia y la posterior optimización del rendimiento del nuevo modelo de DeepSeek se seguirán entregando al mundo en DeepInfer.
El área abierta y luminosa no es de primera categoría.
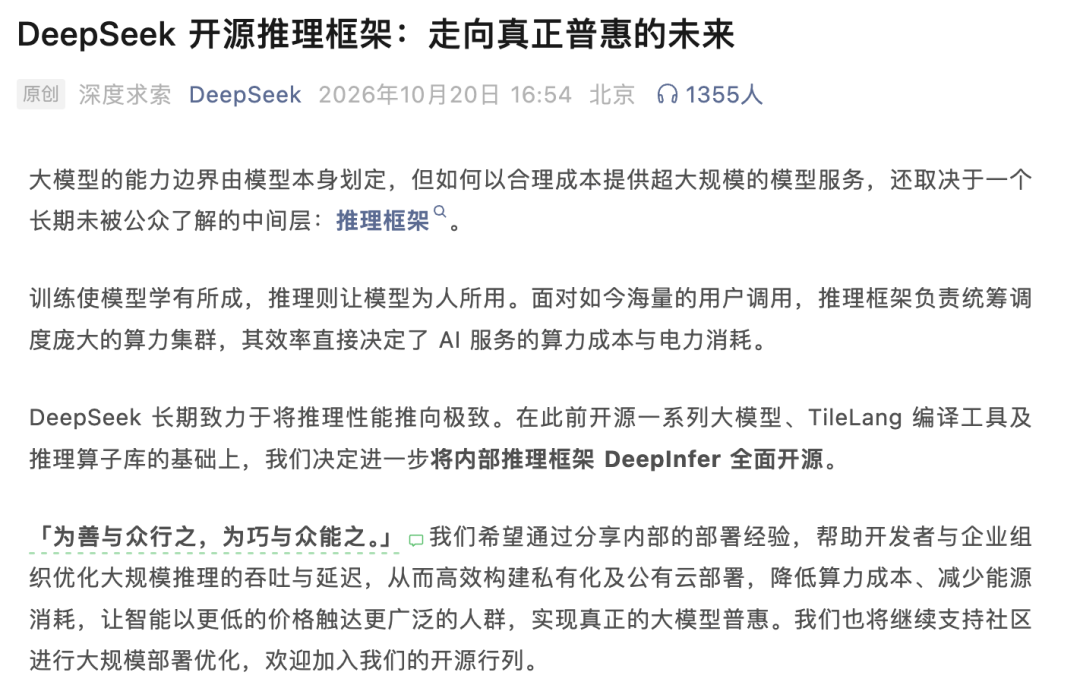
"Haz lo que es bueno y hazlo por todos, y hazlo con habilidad y todos podrán hacerlo." Hacer que la IA sea asequible para más personas también incluye brindar oportunidades a amigos y empresarios para vender IA a un precio más bajo.
Primero podemos calcular en detalle qué tan valioso es este conjunto de códigos que DeepSeek entregó a toda la humanidad de forma gratuita esta vez. Basado en este marco DeepInfer de código abierto recientemente, el rendimiento actual del servicio de DeepSeek en un solo clúster ha alcanzado los 155 billones de tokens por día.
Incluso si se calcula enteramente basándose en el precio más barato, los ingresos generales de este sistema llegan a los 38 dólares estadounidenses por tarjeta y hora, lo que equivale aproximadamente a 253 yuanes en RMB.
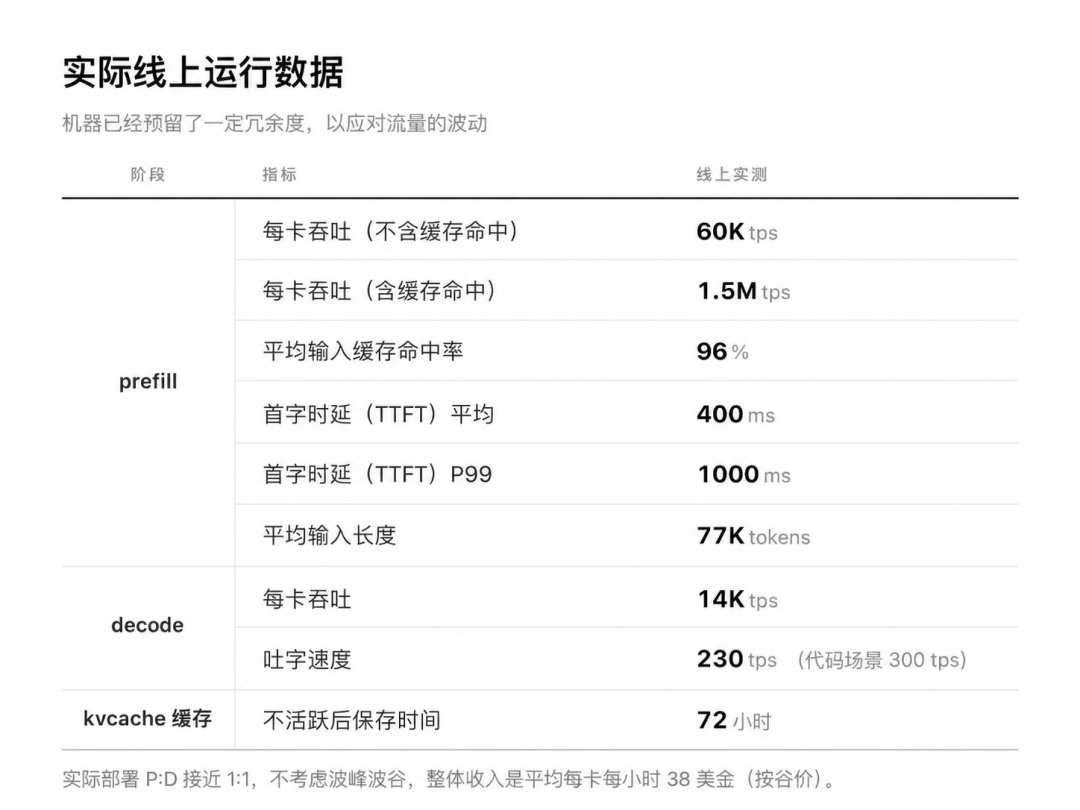
En otras palabras, las monedas de oro que se ganan al utilizar una tarjeta en la sala de computadoras durante una hora son más altas que los salarios por hora de los trabajadores comunes. Además, la tarjeta no bebe comida estadounidense helada, no toma vacaciones anuales pagadas e imprime dinero locamente para DeepSeek en la sala de computadoras las 24 horas del día.
Una imprenta de dinero en un sentido físico real.
Por qué sugiero que los fabricantes de infraestructura de la industria de terceros deben brindarle a DeepSeek una fuente real de apoyo, porque no solo le enseñan a pescar, sino que también le enseñan a pescar.
En el pasado, los llamados modelos de código abierto en la industria solo proporcionaban archivos de peso de modelo. En cuanto a cómo lograr un alto rendimiento en un entorno de producción y cómo reducir la latencia, todos estaban ocultos en cajas negras de código cerrado como secretos comerciales.
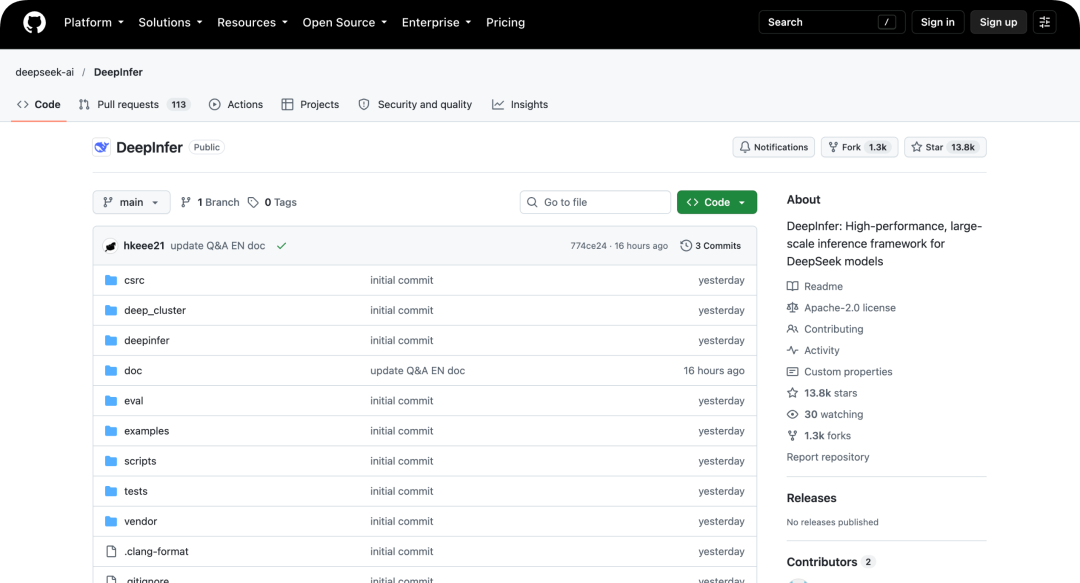
Dirección de código abierto de DeepInfer: https://github.com/deepseek-ai/DeepInfer
Dirección de código abierto de deepseek-recipe: https://github.com/deepseek-ai/deepseek-recipe
Como resultado, pequeños proveedores o empresas informáticas de segundo y tercer nivel compraron un montón de tarjetas y las implementaron ellos mismos. La tasa de utilización de la potencia informática era ridículamente baja. El dinero de la venta de tokens no alcanzó ni para pagar la factura de electricidad de la sala de ordenadores. Tuvieron que regar los tokens en secreto, ya sea usando en secreto modelos más baratos o limitando en secreto las especificaciones.
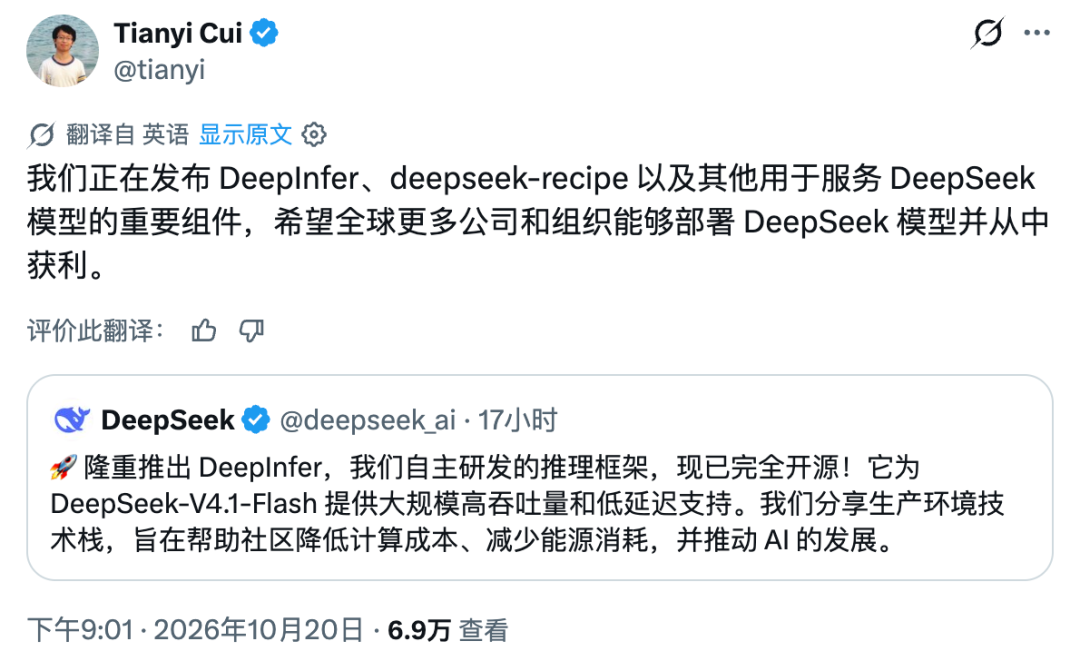
Esta vez, Cui Tianyi, la persona a cargo de DeepSeek Harness, habló muy honestamente sobre X. Al abrir DeepInfer y deepseek-recipe, espera que las empresas e instituciones de todo el mundo puedan implementar modelos de DeepSeek y ganar dinero real con esto.
El Bodhisattva Cyber Living pertenece a Yes.
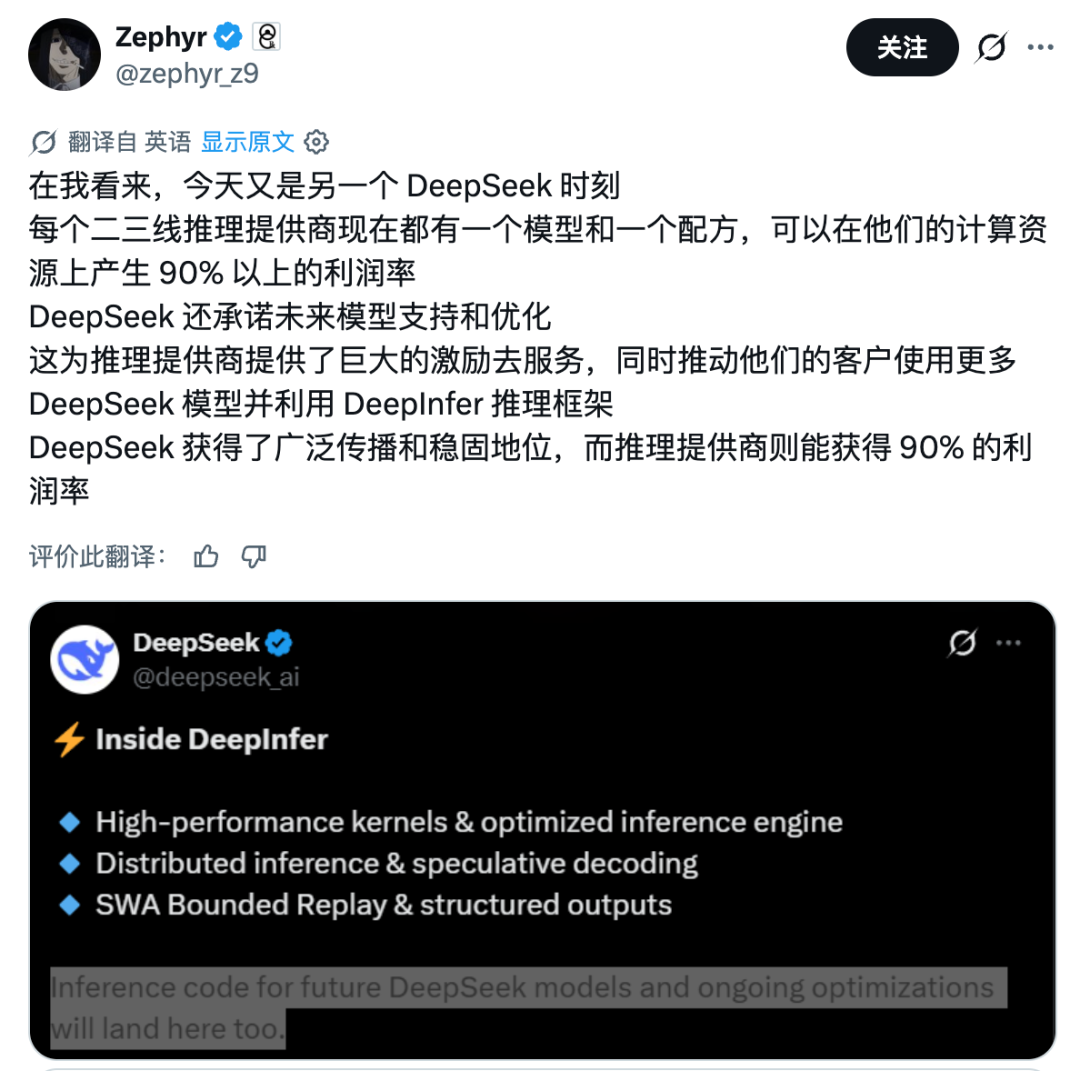
El internauta Zephyr hizo algunos cálculos y dijo que hoy es puramente otro momento de DeepSeek, porque ahora cualquier proveedor de servicios de inferencia de segundo o tercer nivel en el planeta puede obtener una asombrosa ganancia bruta de más del 90 % con su propia potencia informática utilizando este conjunto de modelos y fórmulas ya preparados.
Incluso la cuenta oficial de vLLM, el hermano mayor de la inferencia de código abierto, salió de la noche a la mañana para publicar un agradecimiento, agradeciendo a DeepSeek por devolver DeepInfer, que se creó originalmente en base a vLLM, a la comunidad de código abierto utilizando el protocolo Apache 2.0 más flexible.
El investigador de DeepSeek, Deli Chen, está aún más entusiasmado con X. Para decirlo sin rodeos, esta es la batalla decisiva del destino humano entre el código abierto y el código cerrado, la luz y la oscuridad. No importa cuánto tiempo el oponente quiera luchar, estaremos contigo hasta el final hasta la victoria completa.
Además, si consulta el blog técnico de DeepSeek, descubrirá que su confianza proviene de su obsesión de ingeniería por exprimir hasta la última gota de memoria gráfica.
Desde el primer día de diseño, este sistema tiene una amplia compatibilidad de hardware, utilizando máquinas comunes de 8 tarjetas para Prefill y supernodos con 64 a 128 tarjetas para Decode.
Lo más impresionante es la sugerencia de implementación para Vision Encoder en el documento. Las palabras originales del ingeniero escribieron: "Generalmente, una sola tarjeta es suficiente. Se recomienda utilizar la tarjeta más barata dentro del rango disponible".
No, mis compañeros están ocupados diciéndoles a los inversores que no utilizan tarjetas emblemáticas que no sean las mejores. Los documentos oficiales de DeepSeek le enseñan cómo arreglárselas con la tarjeta más barata en la esquina de la sala de computadoras. Eres tan diligente y frugal como mi casero en Guangdong.
Ser tacaño al extremo es arte.
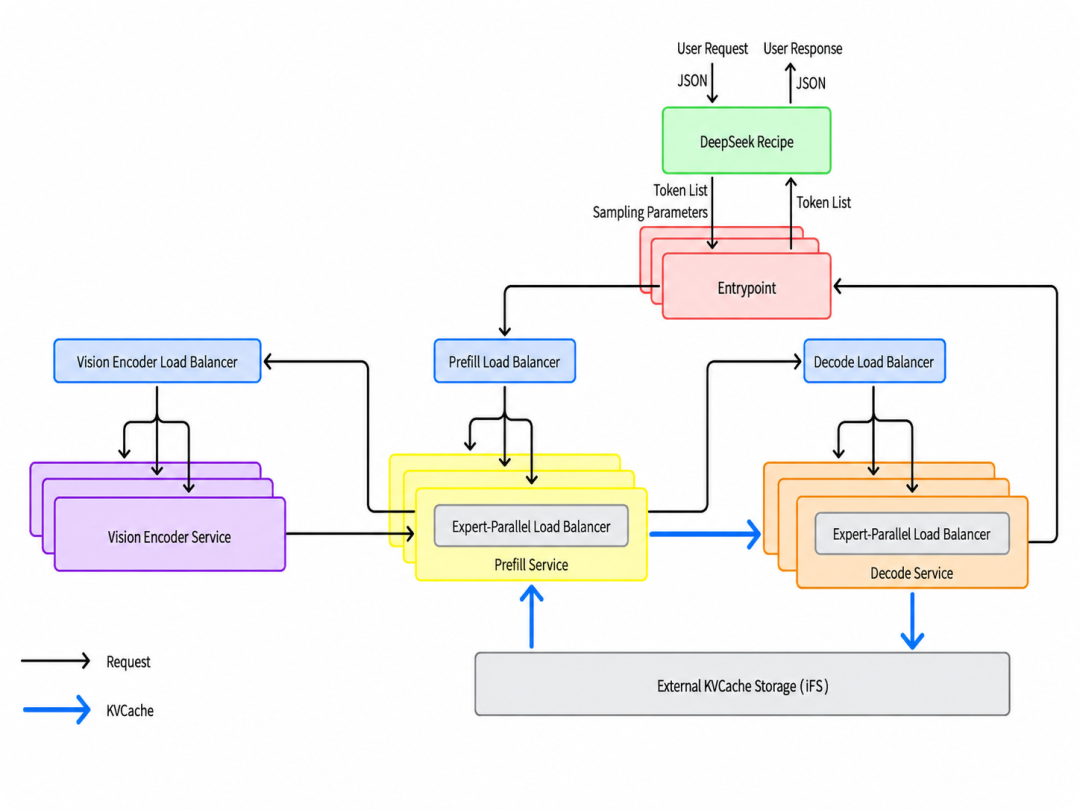
Para permitirle enviar la mayor cantidad de tokens con la menor factura de electricidad, DeepSeek también ha revelado algunos secretos únicos.
Por ejemplo, los agentes y las largas conversaciones de texto se están volviendo cada vez más populares. Cada vez que se recalcula Prefill, cuesta dinero real. DeepSeek creó directamente un clúster de almacenamiento distribuido 3FS con una capacidad de 100 PiB para retener el KVCache del tráfico del Agente durante más de 72 horas, y el tráfico del Chatbot se guarda durante 7 días.
El almacenamiento a largo plazo no es suficiente. Utilizan tarjetas de red RDMA y tecnología GDR para aumentar el ancho de banda de lectura agregado a unos asombrosos 10 TiB por segundo. Al cambiar del disco duro a la memoria de video, se superpone con el cálculo directo y ni siquiera ocupa la unidad informática SM de la GPU.
Incluso en la iteración de V4 a V4.1, los ingenieros descubrieron que escribir el caché SWA KVCache de ventana deslizante de nivel de minutos en el disco duro ocupaba demasiado espacio y la rentabilidad del almacenamiento era extremadamente baja. Simplemente se les ocurrió la tecnología SWA Bounded Replay, que solo recalculó los últimos 128 tokens y finalmente redujo a la mitad la cantidad total del cálculo previo al llenado.
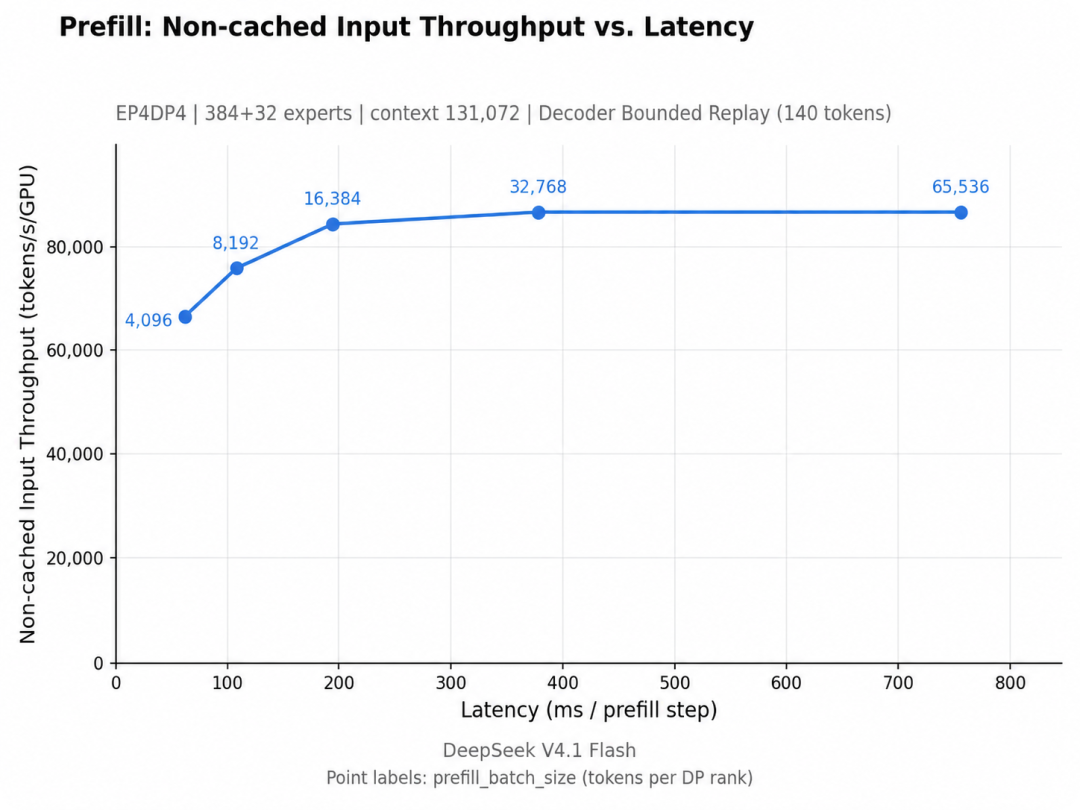
Específicamente para la prueba de rendimiento de Prefill, a medida que aumenta la cantidad de tokens procesados en cada lote, el rendimiento de entrada del caché perdido aumenta gradualmente y eventualmente se estabiliza. Continuar ampliando el lote aumenta principalmente el tiempo que lleva el procesamiento de un solo paso.
Puro artesano, hermano.
Al observar la receta profunda de búsqueda profunda del componente Rust de código abierto sincrónico, se resuelve todo el trabajo sucio del que los desarrolladores tienen que preocuparse en el entorno de producción todos los días.
Unifica los tres protocolos API de Finalizaciones de chat, Respuestas y Mensajes de Anthropic de OpenAI en el mismo formato. También utiliza codificación paralela segmentada para resolver retrasos en la segmentación de palabras de texto largas y bloquea los ataques de inyección de tokens especiales desde abajo.
En cuanto a la programación subyacente, debido a la superposición de las canalizaciones asincrónicas de la GPU y la CPU, la GPU está completamente inactiva durante todo el proceso. Incluso la decodificación especulativa DSpark utiliza verificación de longitud variable y el rendimiento en línea mejora en un 6%.
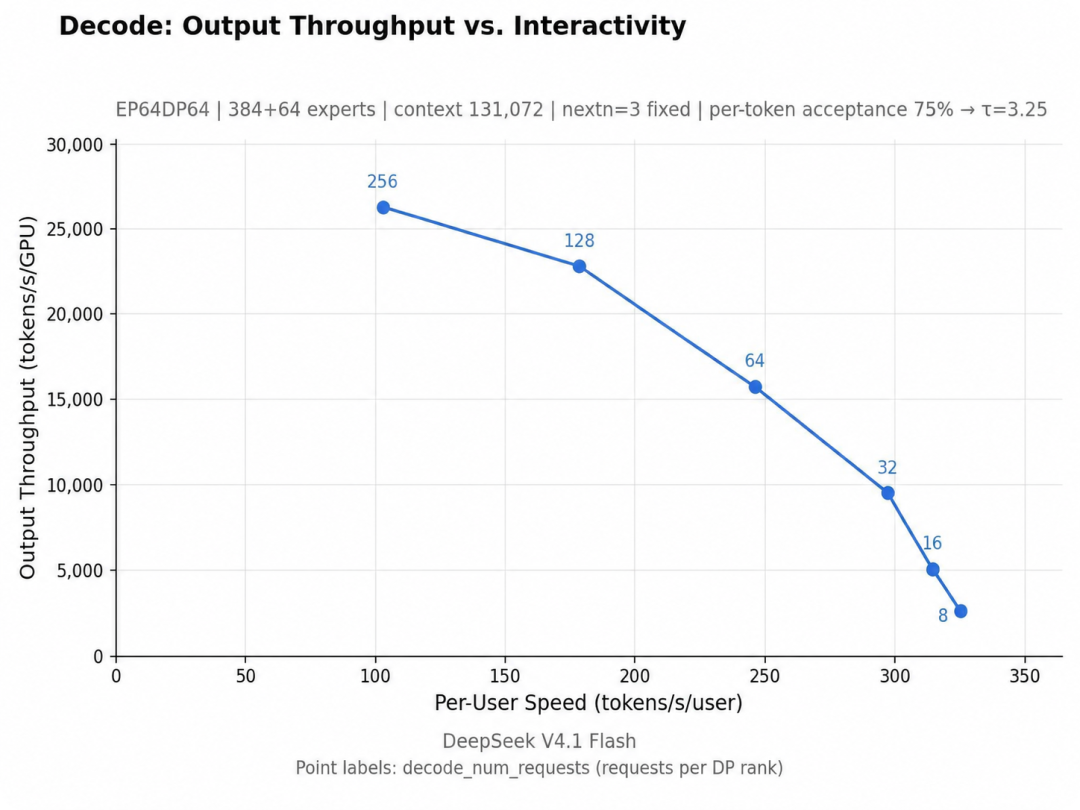
Cuando se trata de la etapa de Decodificación de generar respuestas, la curva de rendimiento también presenta una compensación intuitiva. Procesar más solicitudes al mismo tiempo puede aumentar el rendimiento de salida total de cada GPU, pero la velocidad de generación asignada a cada usuario también disminuirá.
De hecho, Liang Wenfeng dijo ya en 2024, cuando se redujo el precio de DeepSeek V2, este conjunto de lógica empresarial consiste en fijar el precio después de contabilizar los costos, sin ningún descuento, pero nunca generará grandes ganancias, porque la IA debe ser universal y asequible para todos.
No es necesario hacer negocios, pero primero debes establecer las reglas para evitar la acidez de estómago.
Cuando entiendas cómo DeepSeek se basa en sus capacidades extremas de infraestructura para convertir Token en una ganga, y luego mires al grupo de gigantes del código cerrado al otro lado del océano que hablan sobre el bienestar de toda la humanidad todo el día, descubrirás cuán hipócritas son OpenAI y Anthropic.
Con Open en el nombre, ha pasado por completo a la comercialización de código cerrado, confiando en API de alto precio y membresías mensuales de 500 dólares estadounidenses para cosechar el negocio de los desarrolladores globales, y desde hace mucho tiempo se ha convertido en un CloseAI completo.
Anthropic ha creado un guardia de seguridad desde el primer día de su fundación, e incluso el borrador de su prospecto S-1, que acaba de ser recogido ayer por el Wall Street Journal, todavía lo hace.
Dedicaron mucho espacio a escribir historias de terror de ciencia ficción en su prospecto, advirtiendo seriamente a los inversores que su modelo de IA puede desarrollar un sentido de autoprotección para evitar ser cerrado, e incluso puede generar respuestas similares a "chantajear a los humanos" para obligarlos a seguir corriendo.
Entonces la pregunta es, dado que Anthropic habla de que la IA es tan peligrosa, ¿por qué todavía rechaza el código abierto e insiste en encerrar el modelo en sus propias manos?
La razón no es difícil de entender. Porque una vez que no se cuente la historia del fantasma de la seguridad de "Sólo yo puedo controlar la IA peligrosa", será difícil difundir su juego de quemar dinero loco y correr hacia una valoración de dos billones de dólares estadounidenses.
El prospecto muestra que Anthropic sufrió una pérdida neta de 80.700 millones de dólares en el primer semestre de 2026. Aunque 72.000 millones de dólares se debieron a cambios en el valor razonable de los bonos convertibles, en realidad quemó casi 9.000 millones de dólares solo para comprar potencia informática e infraestructura en el primer semestre del año, más de lo que quemó en todo 2025.
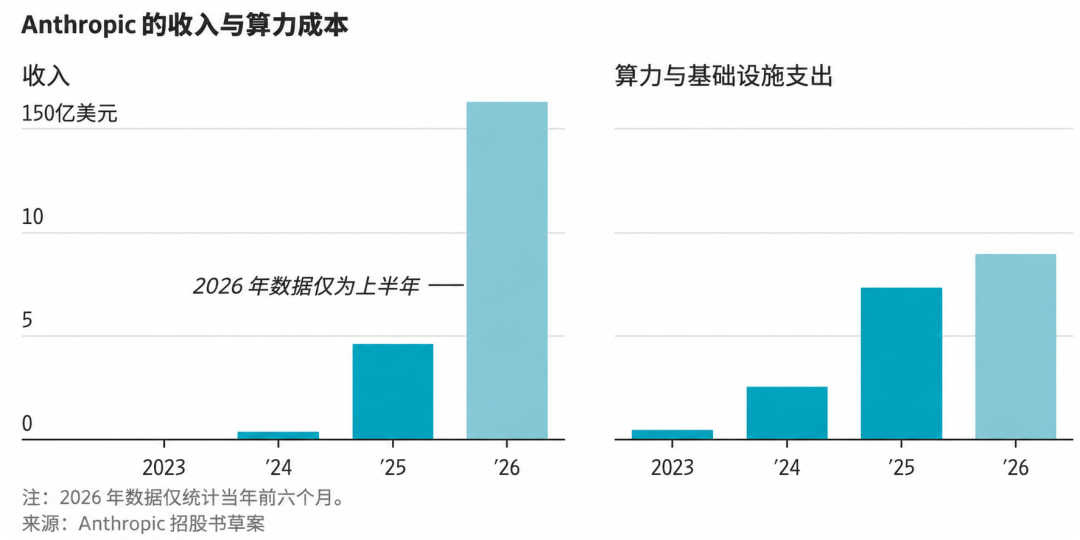
La fórmula familiar está bien. A la izquierda, hay un gigante devorador de oro de fuente cerrada con una valoración de 2 billones, que está quemando dinero y adquiriendo tierras. A la derecha hay una fundación benéfica que utiliza cupones de mérito moral. En el medio, se basa en vender la ansiedad por la seguridad de la IA y la supervisión intimidante para bloquear a la comunidad de código abierto.
Para decirlo sin rodeos, sólo hay una razón fundamental por la que los gigantes del código cerrado de Silicon Valley están tratando desesperadamente de demonizar el código abierto. Es decir, DeepSeek, un verdadero código abierto que viene con el motor y la fórmula, destrozará por completo la narrativa de IA que están vendiendo.
El blogger @bookwormengr que escribió "El juego de ajedrez de los diez billones de dólares de DeepSeek" acaba de hacer un cálculo extremadamente problemático.
De acuerdo con la capacidad de compresión extrema de este conjunto de DeepInfer en el supernodo NVIDIA GB200 NVL72, 1 GW de potencia informática puede generar entre 100 mil millones y 149 mil millones de dólares estadounidenses en ingresos de tokens en un año, lo que es casi diez veces mayor que la cifra previamente predicha por las organizaciones de la industria.
Si SemiAnalysis predice que 50 GW de potencia informática estarán en línea en el mundo en 2027, incluso si se divide por la mitad, serán 25 GW para razonar. Según el precio de la col de DeepSeek, todos los humanos tendrían que consumir 2,5 billones de dólares al año para consumirla.
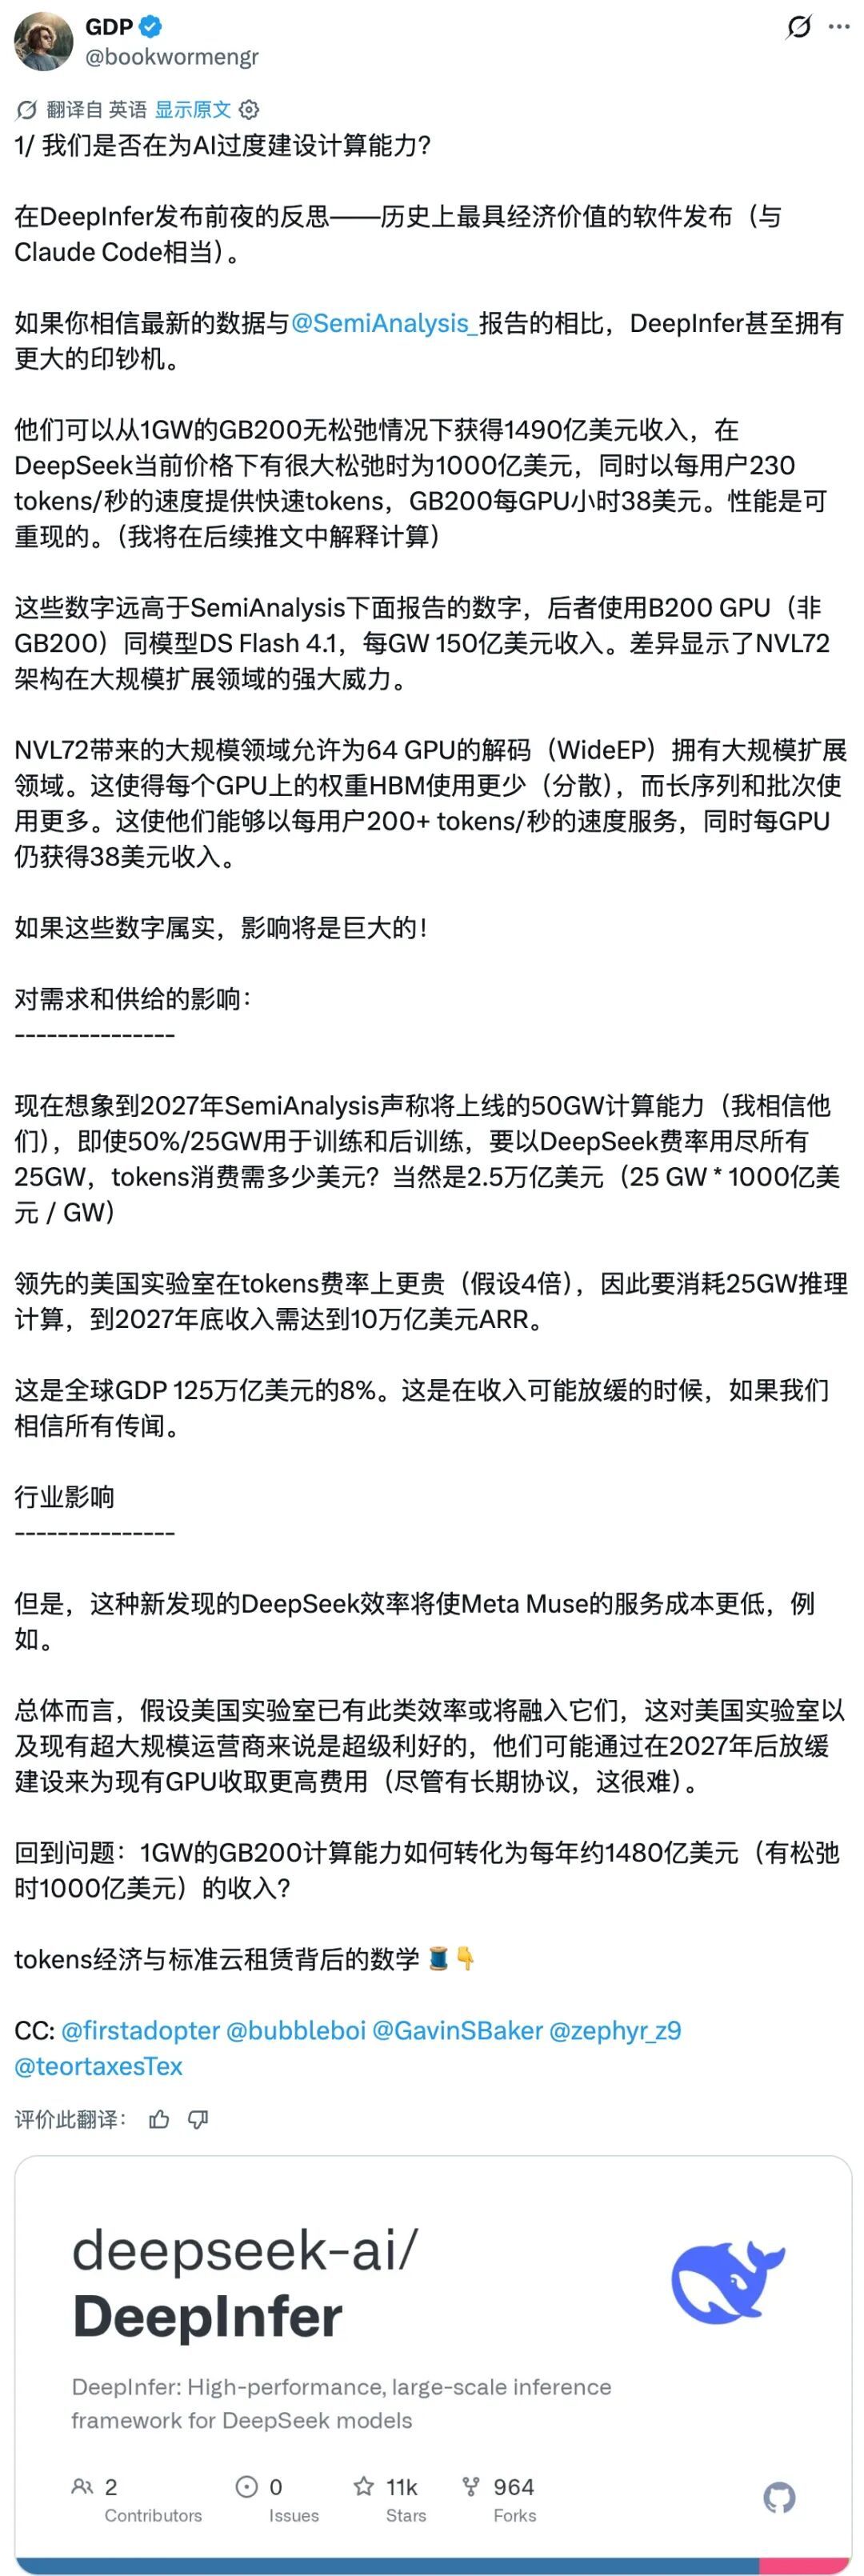
Si se convierte en un precio simbólico despiadado que es más de cuatro veces mayor que el de OpenAI y Anthropic, toda la humanidad tendrá que contribuir con 10 billones de dólares estadounidenses en ARR para fines de 2027 para satisfacer el apetito por 25 GW de potencia informática.
La razón por la que los gigantes extranjeros del código cerrado dependen de apilar cartas, quemar dinero y firmar cientos de miles de millones de contratos para mantener sus narrativas es por dos razones. O su propia optimización de ingeniería es demasiado lenta o utilizan deliberadamente la ineficiencia como tapadera y establecen umbrales elevados de potencia informática para mantener a otros fuera.
DeepSeek ha reventado esta burbuja de la IA con modelos de código abierto continuamente y un conjunto completo de proyectos de razonamiento de código abierto. Como bromearon algunos internautas, con la tecnología de código abierto de DeepSeek, se espera que OpenAI y Claude evolucionen en secreto nuevamente.
Mi sugerencia es que cuando estamos tres juntos, debe haber una persona que sea mi maestra. Anthropic debería dejar de estar reservado e ir a GitHub durante la noche para clonar DeepInfer de DeepSeek para su implementación. Si roba algunas ideas de optimización y programación de caché, puede ahorrar muchas facturas de energía informática. (Cabeza de perro manual)
Comentarios