Resumen:
Esta mañana llegó el modelo más potente de SpaceXAI, Grok 4.7. Al principio de la página de lanzamiento sólo hay un posicionamiento muy "ofensivo": el modelo más potente para programación y trabajo de conocimientos, dos veces más rápido que modelos comparables y sólo la mitad de precio.
Esta actualización no se limita a los puntos de referencia. Grok 4.7 cambia a un modelo básico más grande, fortalece las tareas a largo plazo, el autoexamen y las capacidades de gestión de contexto a largo plazo, e incluye documentos, presentaciones, trabajos legales, médicos y de ingeniería y otros trabajos profesionales en pruebas clave. El escenario al que apunta es muy claro: permitir que el modelo evite desvíos en tareas que duran varias horas y entregue resultados que puedan utilizarse directamente.
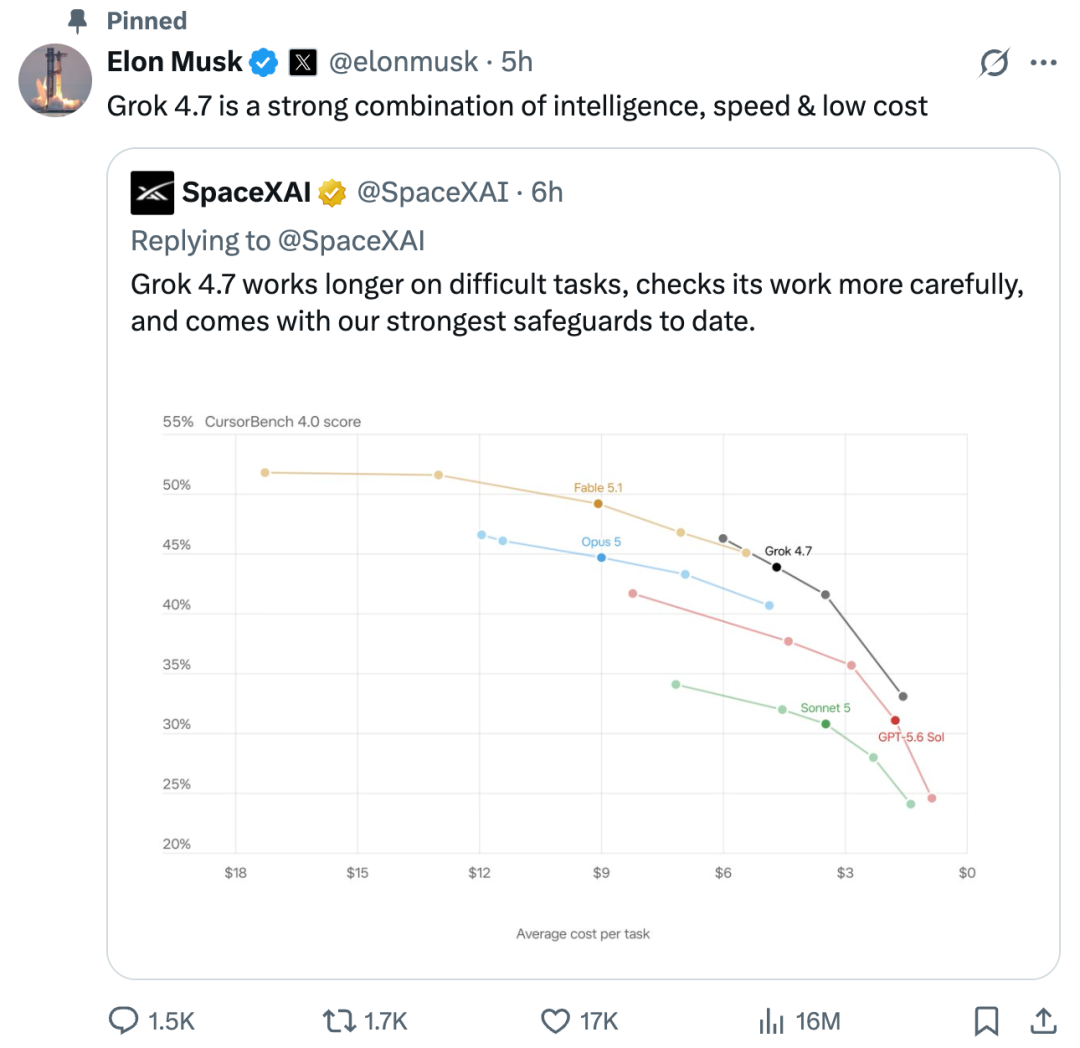
Musk tuiteó: "Grok 4.7 logra un equilibrio muy competitivo entre nivel de inteligencia, velocidad operativa y costo".
Las misiones largas se han convertido en el principal campo de batalla de esta generación de modelos
Grok 4.7 utiliza un modelo base más grande que Grok 4.6. La fase de capacitación extiende el período de aprendizaje por refuerzo y las combinaciones de tareas se vuelven más difíciles, con más muestras que requieren horas para completarse. SpaceXAI dijo que el nuevo modelo ha mejorado su capacidad para inspeccionar su propio trabajo y gestionar contextos prolongados.
Este tipo de mejora corresponde directamente a los problemas más difíciles de la programación actual de agentes inteligentes. La generación de códigos cortos a menudo solo requiere un juicio parcial, pero las tareas de software verdaderamente complejas incluyen leer el almacén, desmantelar los requisitos, modificar múltiples archivos, ejecutar pruebas y corregir errores repetidamente. Si el modelo puede mantener los objetivos y detectar errores en una larga cadena de ejecución suele ser más importante que escribir un código atractivo de una sola vez.
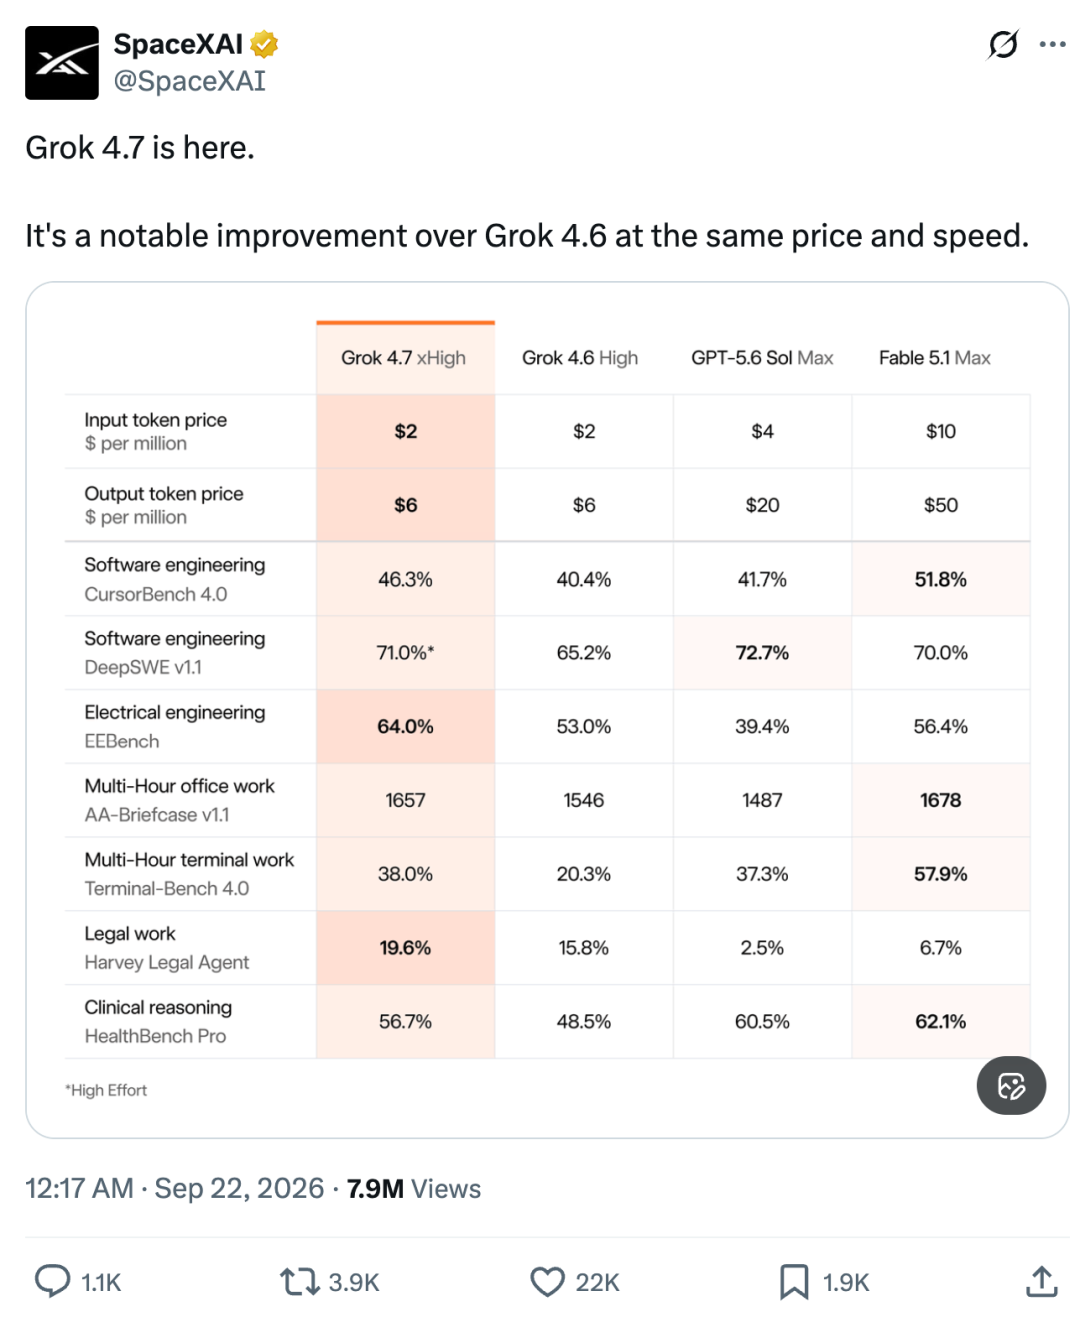
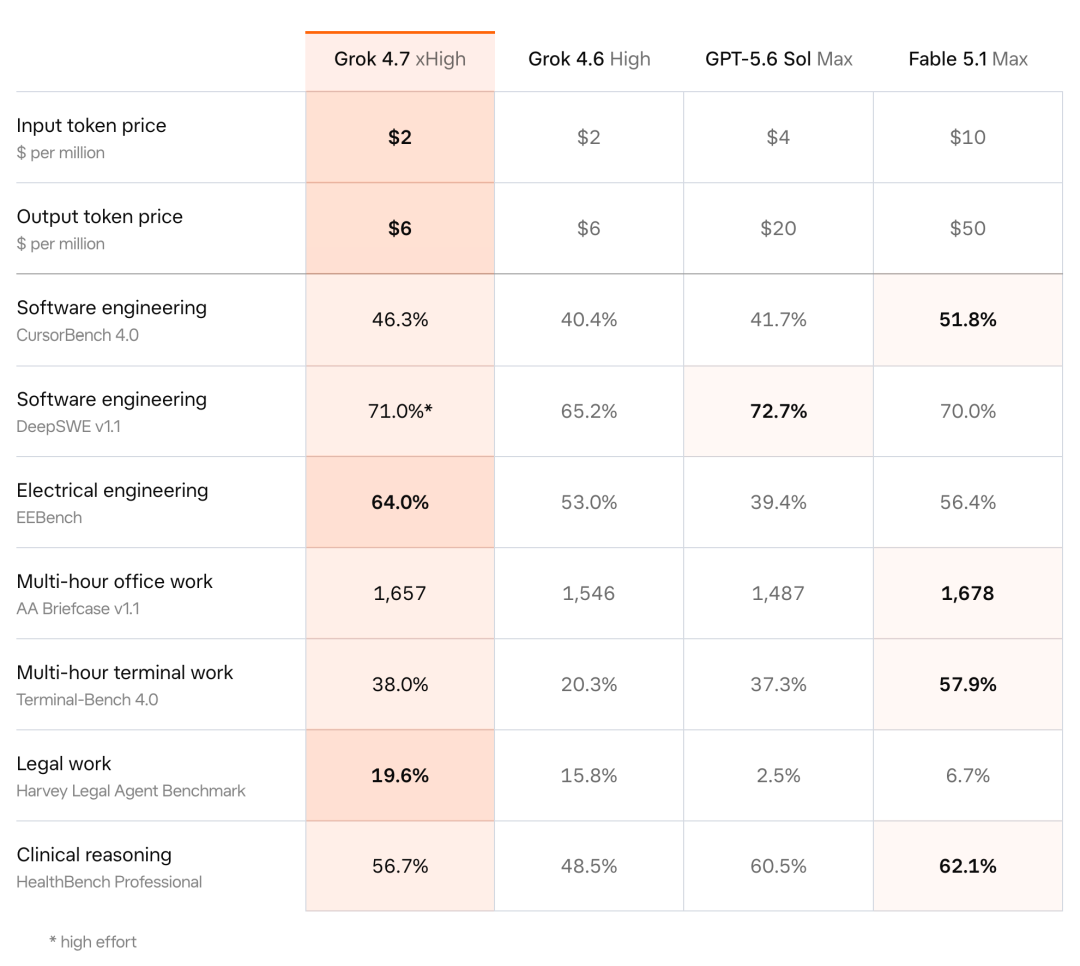
CursorBench 4.0 examina específicamente tareas de codificación a largo plazo. Según los datos oficiales, Grok 4.7 obtuvo un 46,3% y Grok 4.6 obtuvo un 40,4%, un aumento de 5,9 puntos porcentuales. En DeepSWE v1.1, la puntuación de alta intensidad de inferencia de Grok 4.7 fue del 71,0%; Terminal-Bench 4.0 aumentó del 20,3% en la generación anterior al 38,0%.
En consecuencia, Grok 4.7 se considera el modelo de precio y rendimiento de vanguardia en CursorBench 4.0.
El modelo también está entrenado para comprender de forma nativa el marco dentro del cual se ejecuta Grok Bot. Oficialmente, este ajuste mejora el desempeño en tareas de diálogo y tareas de conocimiento general. En otras palabras, el enfoque de actualización de Grok 4.7 se ha extendido desde una única ronda de respuestas a una colaboración continua entre modelos, herramientas y entornos de ejecución.
De escribir código a completar el trabajo de conocimiento
La programación sigue siendo la etiqueta más llamativa de Grok 4.7, pero el alcance de la evaluación realizada por SpaceXAI es significativamente más amplio. AA Briefcase y GDPval se centran en el trabajo de varios pasos que los profesionales realizan todos los días, cubriendo tareas comunes en puestos como abogados, enfermeras y analistas financieros, así como la producción de documentos y presentaciones.
En AA Briefcase v1.1, Grok 4.7 obtuvo 1657 puntos, más que los 1546 puntos de Grok 4.6; la puntuación GDPval Elo aumentó de 1605 a 1695. En el gráfico oficial, está cerca de los 1735 puntos de Fable 5.1 en GDPval y es superior a los 1542 puntos de GPT-6 Astra. SpaceXAI concluyó que Grok 4.7 superó a la generación anterior en ambas pruebas y, en general, tuvo un desempeño a la par con otros modelos de vanguardia.
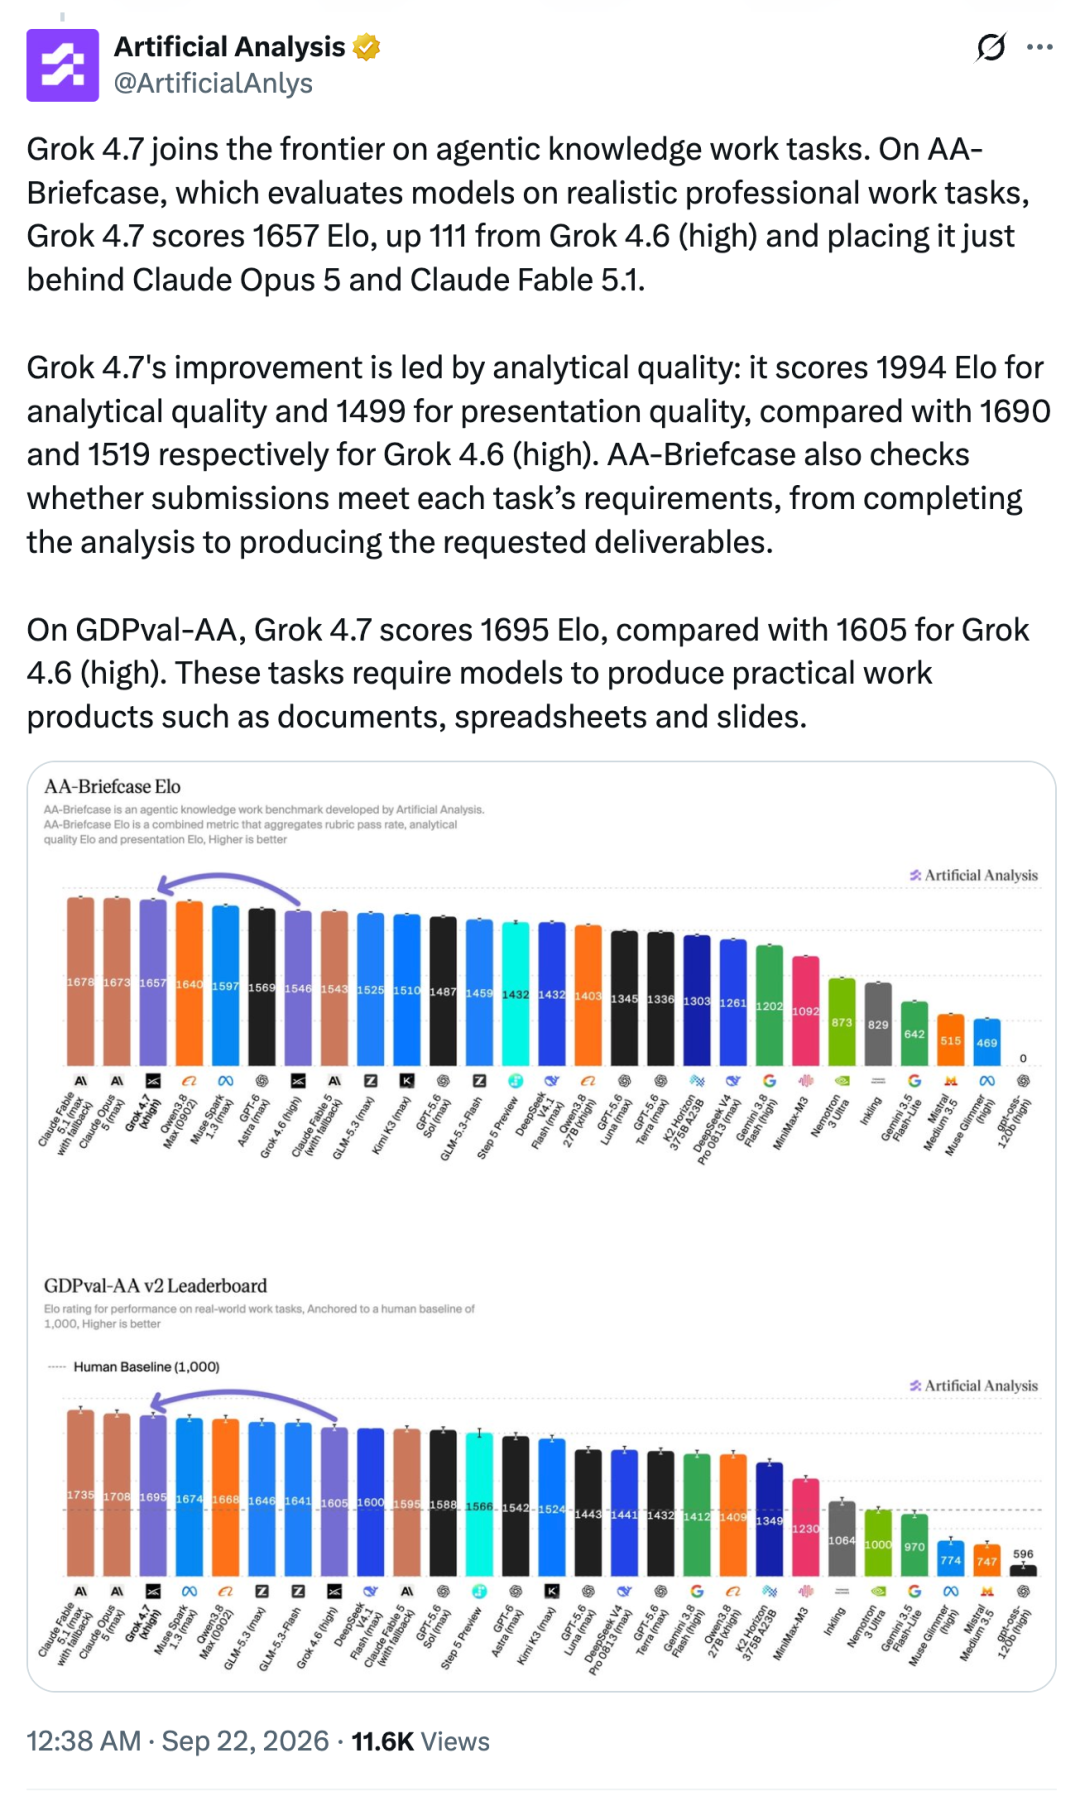
Los ascensos en el ámbito profesional también se producen en muchas direcciones. La puntuación EEBench aumentó del 53,0 % al 64,0 %, el Harvey Legal Agent Benchmark aumentó del 15,8 % al 19,6 % y el HealthBench Professional aumentó del 48,5 % al 56,7 %. Estos resultados provienen de una tabla comparativa interna publicada por SpaceXAI, que puede ilustrar los cambios entre las generaciones de modelos antiguas y nuevas; Las comparaciones entre modelos seguirán viéndose afectadas por la intensidad de la inferencia, la configuración de la herramienta y el entorno de prueba.
Este conjunto de resultados revela una tendencia clara: la competencia por modelos de vanguardia está entrando en la etapa de "completar todo el trabajo".
El modelo necesita comprender la tarea, llamar a herramientas, producir archivos y revisarse a sí mismo. La capacidad de una única pregunta y respuesta es sólo una parte. Grok 4.7 amplía la duración de las tareas de formación y refuerza la autoverificación, que es exactamente lo que compensa este tipo de flujo de trabajo.
Seguridad y precio
Además de capacidades mejoradas, Grok 4.7 ha habilitado un nuevo sistema de protección de seguridad. SpaceXAI dijo que este es el modelo que ha probado con el rendimiento más sólido en términos de denegación de respuesta y resistencia al jailbreak.
En términos de pruebas de bioseguridad, Grok 4.7 encabezó el punto de referencia de LatchBio con una puntuación del 62,4 %. Las pruebas de ciberseguridad HackerBench v0.3 cubren principalmente tareas maliciosas y de alto riesgo. Según datos oficiales, el modelo solo publica el 3,3% de los consejos de doble uso de alto riesgo y rara vez bloquea por error las solicitudes normales de investigación de seguridad.
SpaceXAI también ha comenzado a abrir capacidades de equipo rojo solo por invitación a un número limitado de socios de ciberseguridad para investigaciones defensivas. Actualmente, esta capacidad del equipo rojo está disponible inicialmente como una colaboración controlada.
La versión estándar continúa al precio original y la velocidad de la versión rápida se duplica
Grok 4.7 se lanzó en Cursor y Grok Build y se proporciona a través de la API de Grok, marcos de programación de terceros, servicios de enrutamiento de modelos y plataformas en la nube. La versión estándar comienza en $2 por millón de tokens de entrada y $6 por millón de tokens de salida, consistente con Grok 4.6.
La estrategia de precios hace que esta actualización tenga más impacto. Los desarrolladores no necesitan pagar costos adicionales de token de la versión estándar para actualizar, pero pueden obtener un mejor desempeño de tareas a largo plazo, capacidades de autoexamen y resultados de trabajo profesionales.
Para los agentes de programación y productos de trabajo del conocimiento, el precio unitario de cada llamada modelo es, por supuesto, importante. La cantidad de intentos y retrabajos necesarios para completar una tarea determina en última instancia el costo real.
Finalmente resuma esta actualización:
Desde los métodos de capacitación hasta las combinaciones de evaluación, Grok 4.7 refuerza lo mismo: permanecer en las tareas durante mucho tiempo y completar tareas complejas. La programación es sólo el primer punto de entrada maduro. Se han agrupado en el mismo conjunto de capacidades documentación, presentación, análisis jurídico, razonamiento clínico y tareas de ingeniería.
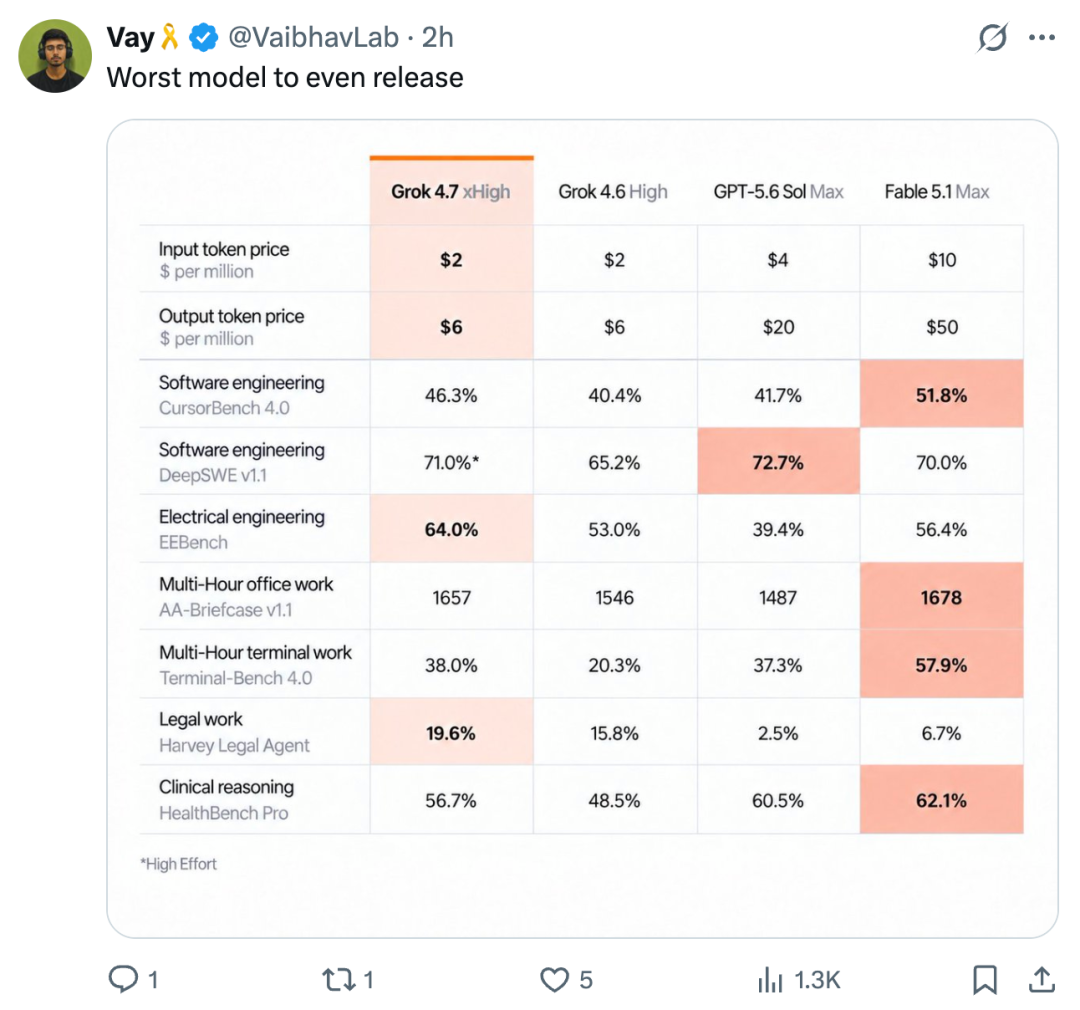
Pero los internautas no parecen creerlo. "Este modelo realmente se atreve a ser lanzado. Es tan malo que no debería ser lanzado". Sólo puedo decir respetuosamente que el punto de venta de Grok 4.7 esta vez no es aplastar por completo a los productos de la competencia. Utiliza un coste de API muy inferior al de algunos modelos emblemáticos a cambio de un rendimiento bastante cercano y líder en tareas profesionales individuales.
Enlace de referencia:
https://x.ai/news/grok-4-7
https://x.com/ArtificialAnlys/status/2102074904560771365
Comentarios