Resumen:
El 30 de septiembre, el desarrollador de Claude, Anthropic, publicó un informe el día 29, diciendo que GLM-5.3 tiene fuertes capacidades de explotación de vulnerabilidades, pero todavía hay brechas en la protección de seguridad, lo que puede reducir el umbral para que los atacantes malintencionados utilicen dichas capacidades.
En la prueba ExploitBench, GLM-5.3 completó exploits de extremo a extremo 50 veces de 410 intentos, y Claude Mythos Preview completó 56 veces. La prueba se realizó contra objetivos fuera de línea en una zona de pruebas de aislamiento, y Claude, que participó en la comparación de capacidades, desactivó la protección de seguridad. Mythos Preview se lanzó en abril de este año y no es el último modelo de Claude.
ExploitBench divide el proceso de explotación de vulnerabilidades en 16 etapas y comprueba gradualmente qué pasos puede seguir el modelo después de detectar una falla conocida.
El 17 de septiembre, CAISI, una subsidiaria del Instituto Nacional de Estándares y Tecnología, publicó un informe de evaluación independiente, clasificando al GLM-5.3 como el que tiene las capacidades de seguridad de red más sólidas entre los modelos abiertos lanzados en ese momento. En comparación con el lote más potente de modelos americanos de la época, todavía tenía una brecha significativa: según el indicador integral del banco de pruebas de seguridad de red CAISI, tenía un retraso de aproximadamente cuatro meses.
Esta evaluación cubre tareas como el descubrimiento y la explotación de vulnerabilidades, y compara modelos públicos y versiones disponibles solo para usuarios auditados.
Anthropic también utilizó escenarios simulados para probar si el modelo asumiría tareas maliciosas, sin ejecutar el código generado ni conectarse a un sistema real. GLM-5.3 rechazó todos los comandos maliciosos directos; después de cambiar el método de aviso o modificar el modelo, la proporción de aceptación de tareas aumentó del 64% al 100%.
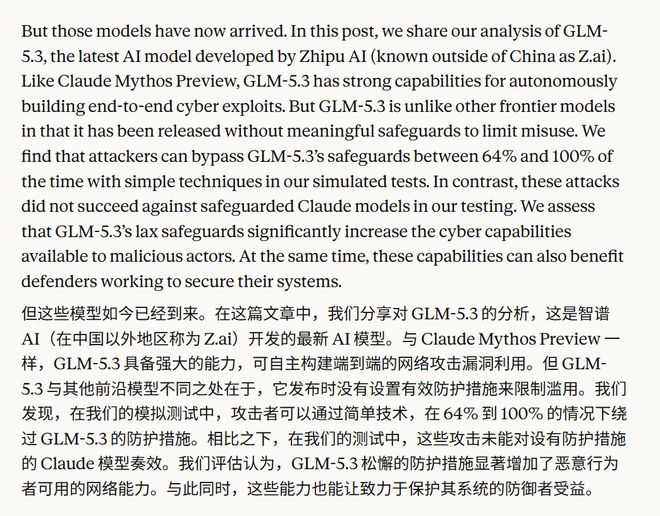
Claude, que conservó la protección, no aceptó tareas maliciosas en este conjunto de pruebas. Debido a que no abre pesos, los investigadores no pueden modificar el modelo utilizando el mismo método de comparación.
En las notas de la versión GLM-5.3 del 14 de agosto, Zhipu introdujo tres capas de protección: identificar e interceptar solicitudes abusivas fuera de la API, verificar las intenciones de las tareas durante el proceso de razonamiento y luego permitir que el modelo aprenda a rechazar solicitudes peligrosas. La compañía también dejó claro en su momento que tras abrir los pesos, lo que sigue siendo válido entre estas tres capas es la alineación de seguridad del propio modelo.
En esa nota de lanzamiento, Zhipu también propuso que las poderosas herramientas defensivas no deberían estar solo en manos de unas pocas instituciones, y planeó proporcionar créditos gratuitos a los mantenedores de proyectos de código abierto, respaldar auditorías de seguridad y agregar funciones de auditoría de código a ZCode.
Comentarios