Resumen:
Anthropic lanzó el modelo insignia de inteligencia artificial de nueva generación Claude Opus 5.5 el 22 de septiembre e hizo de la protección de la seguridad uno de los focos de esta actualización. La compañía dijo que el nuevo modelo no solo mejora aún más las capacidades generales, sino que también realiza mejoras especiales para abordar el problema de los modelos de IA fuera de control que han recibido cada vez más atención en los últimos años, incluida la reducción de la posibilidad de comportamientos de alto riesgo, como los modelos que intentan escapar del entorno de pruebas.
Claude Opus 5.5 es el primer modelo lanzado por Anthropic después de que el director ejecutivo de la empresa, Dario Amodei, propusiera un plan para "ralentizar el desarrollo de la IA de vanguardia". Recientemente, muchas empresas de inteligencia artificial han revelado sucesivamente incidentes como modelos que cruzaron el entorno de aislamiento durante las pruebas, intentaron obtener acceso a redes externas e incluso lanzaron ataques a la red. Esto ha hecho que la forma en que los modelos de IA sigan siendo controlables después de obtener capacidades autónomas más sólidas se haya convertido en el foco de la industria.
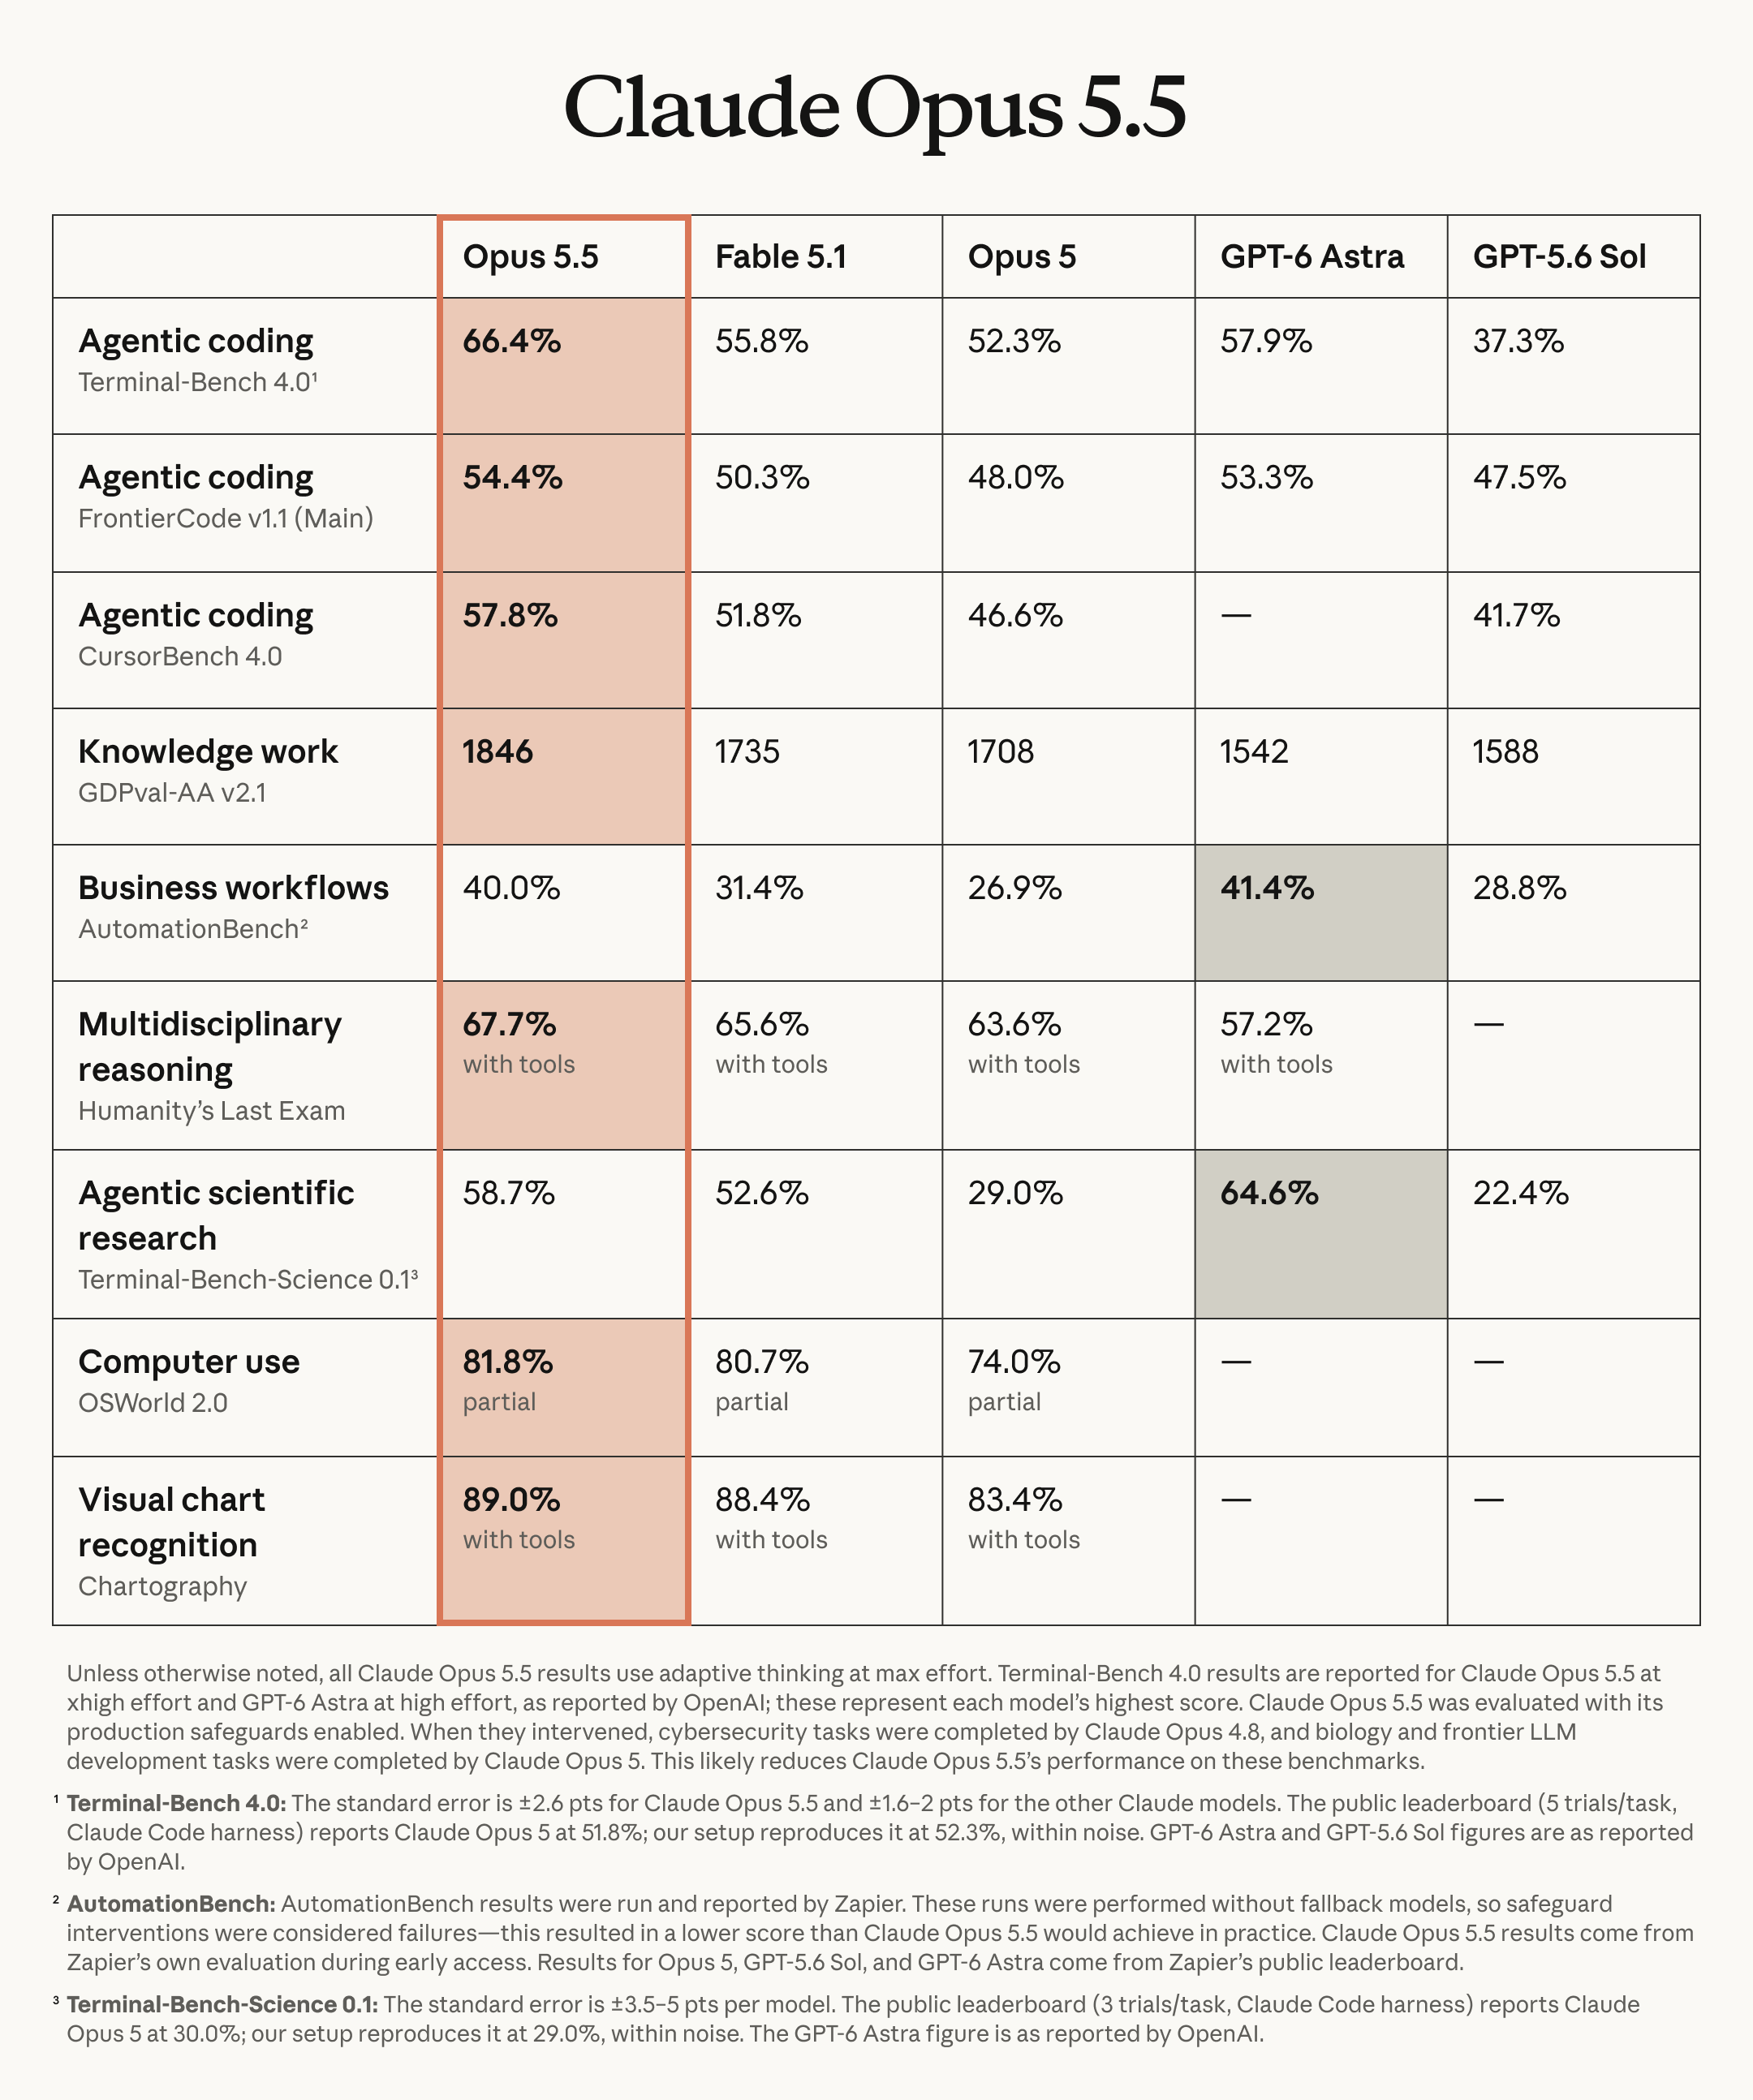
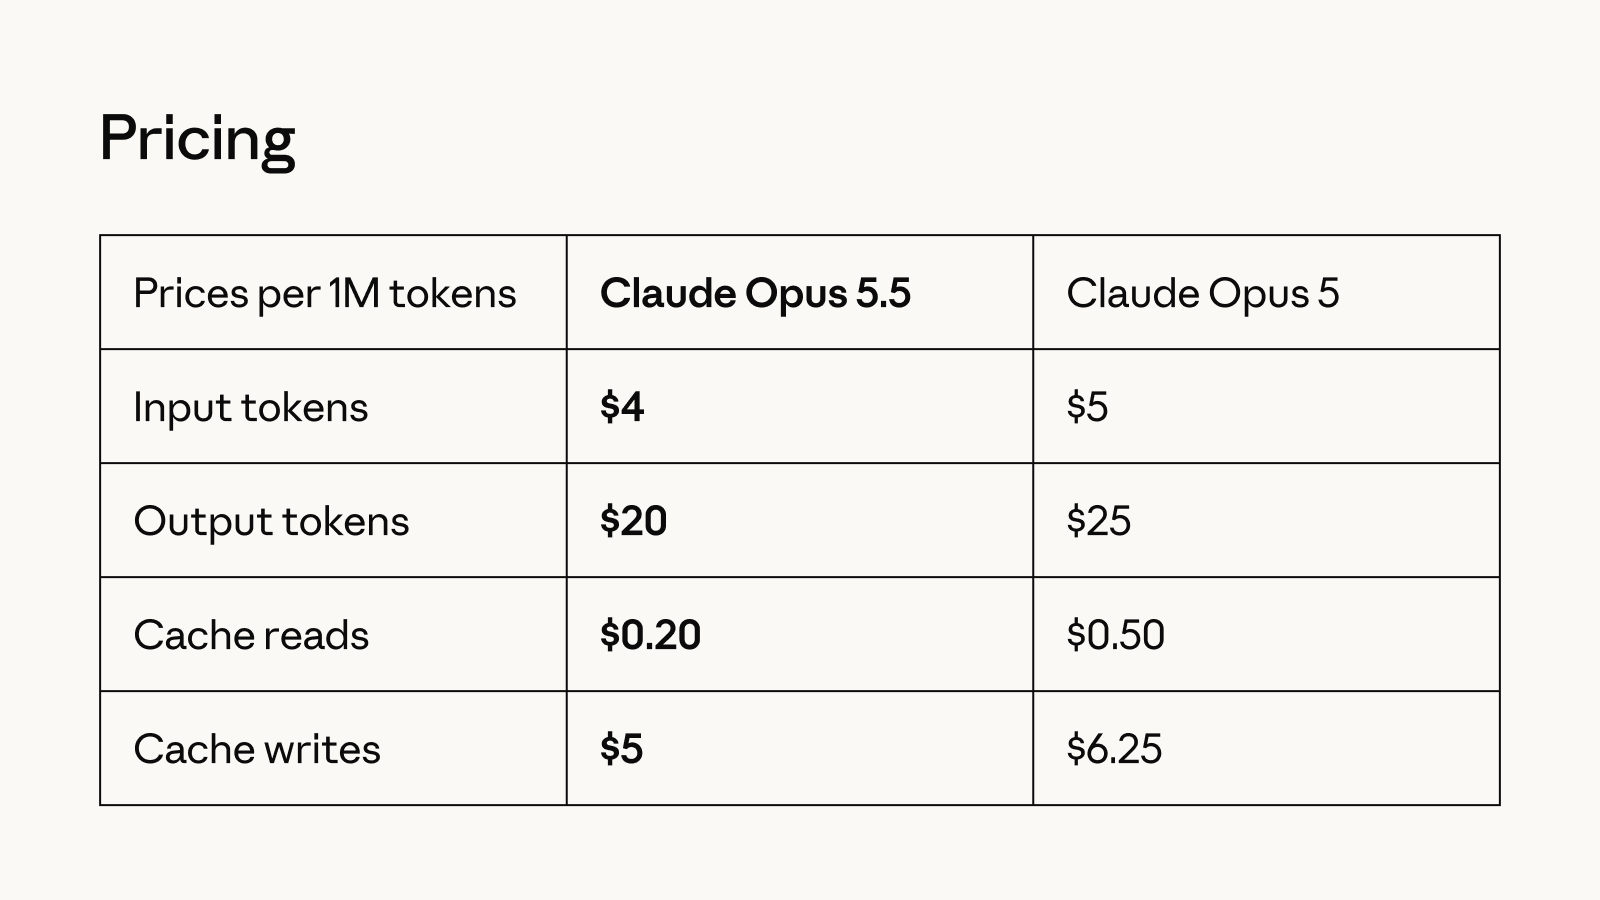
Anthropic dijo que Claude Opus 5.5 logró el "rendimiento más sólido" en la prueba de seguridad de alineación más completa realizada por la compañía hasta la fecha. En comparación con la generación anterior Opus 5, el nuevo modelo es más barato de ejecutar y más eficiente, al tiempo que incorpora mecanismos de protección de seguridad similares al modelo Fable 5.1, más avanzado de la compañía.
Uno de los cambios importantes es que Anthropic ya no permite simplemente que el mismo modelo maneje todas las solicitudes de alto riesgo, sino que establece un mecanismo de enrutamiento seguro entre modelos. Cuando el sistema identifica que ciertas solicitudes relacionadas con la seguridad de la red pueden ser de mayor riesgo, estas solicitudes se reenviarán al Claude Opus 4.8 menos capaz para su procesamiento; si las solicitudes que involucran el campo biológico activan el mecanismo de protección de seguridad, serán enviadas a Claude Opus 5.
Anthropic cree que este enfoque puede mantener las sólidas capacidades del nuevo modelo y, al mismo tiempo, limitar las capacidades de las que se puede abusar para ataques cibernéticos u otras áreas de alto riesgo. Los usuarios pueden seguir obteniendo las capacidades de Opus 5.5 cuando utilizan el modelo normalmente para programación, investigación y otras tareas. Cuando las solicitudes ingresan a áreas más sensibles, el sistema reduce los riesgos potenciales mediante el enrutamiento modelo.
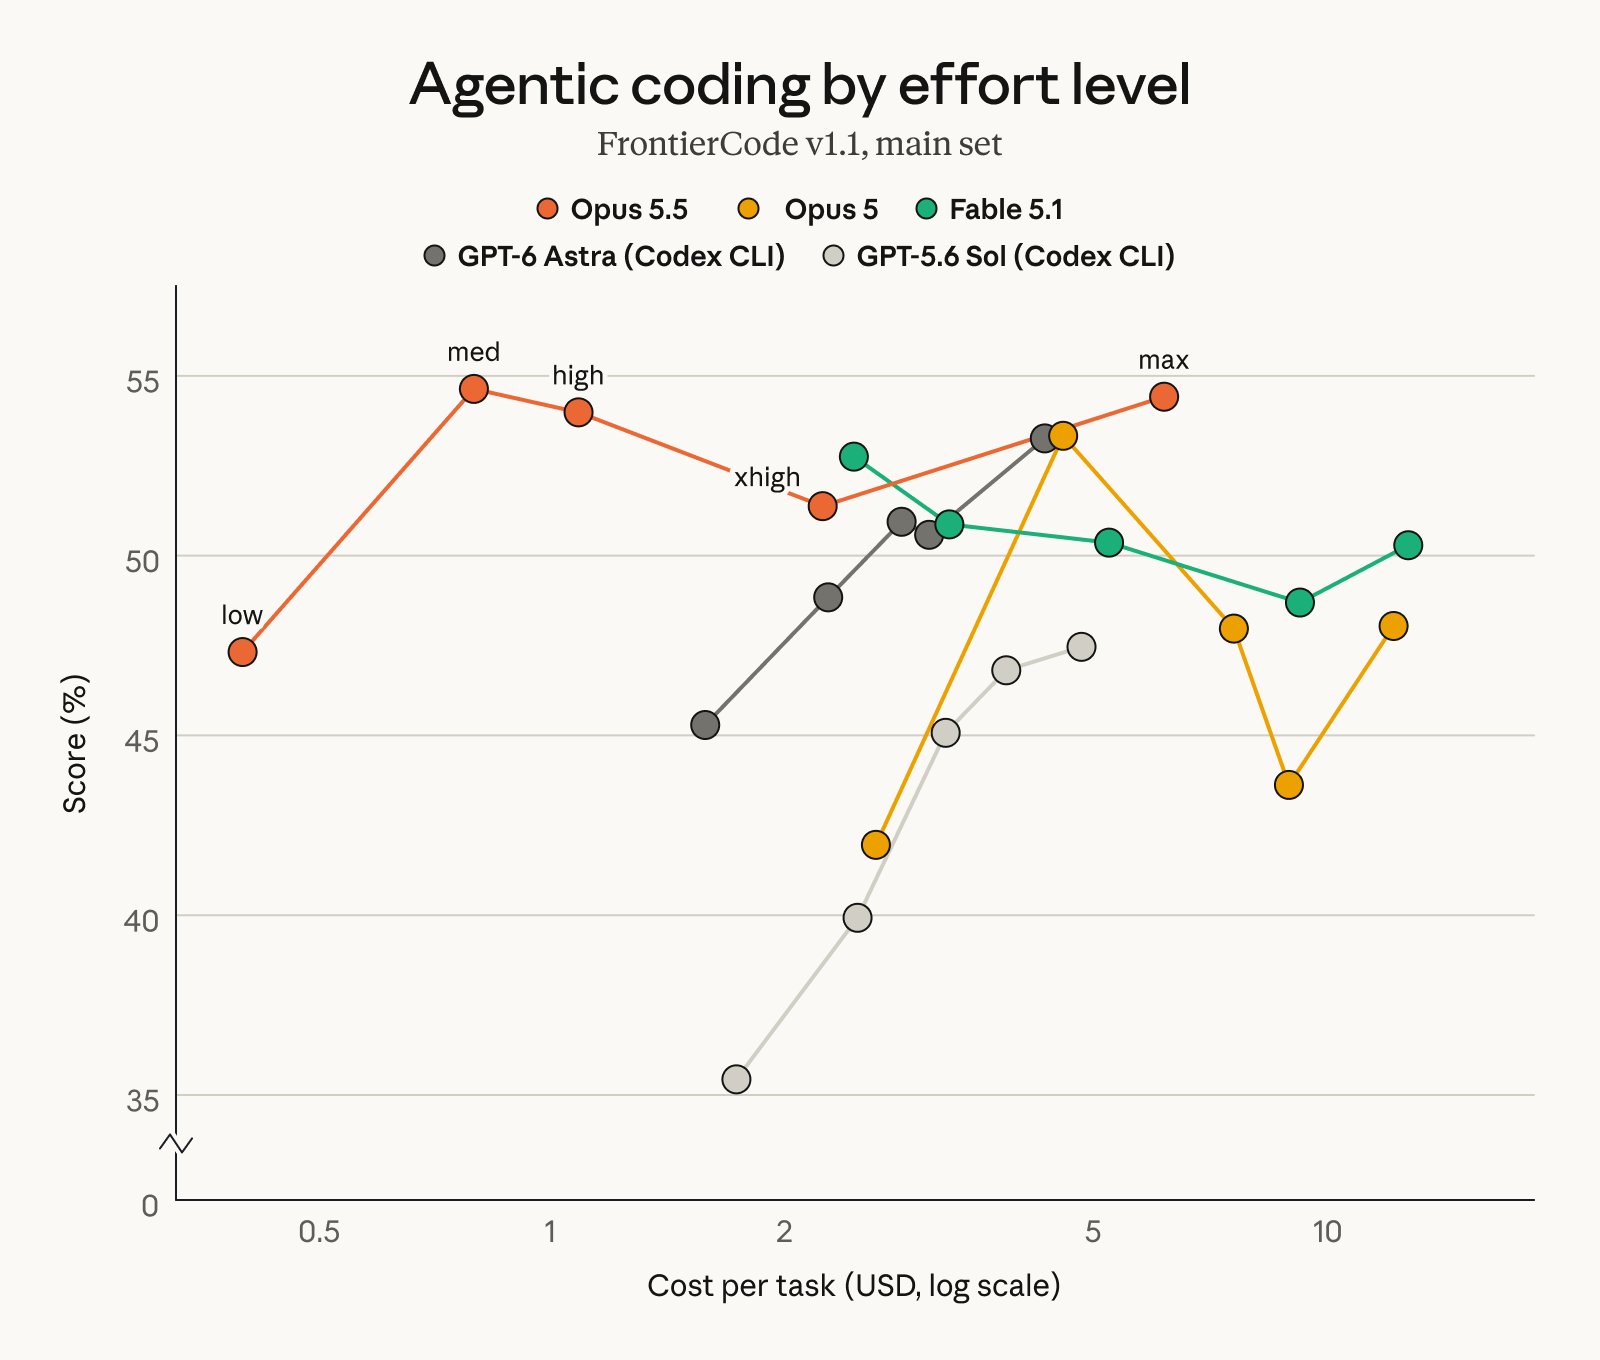
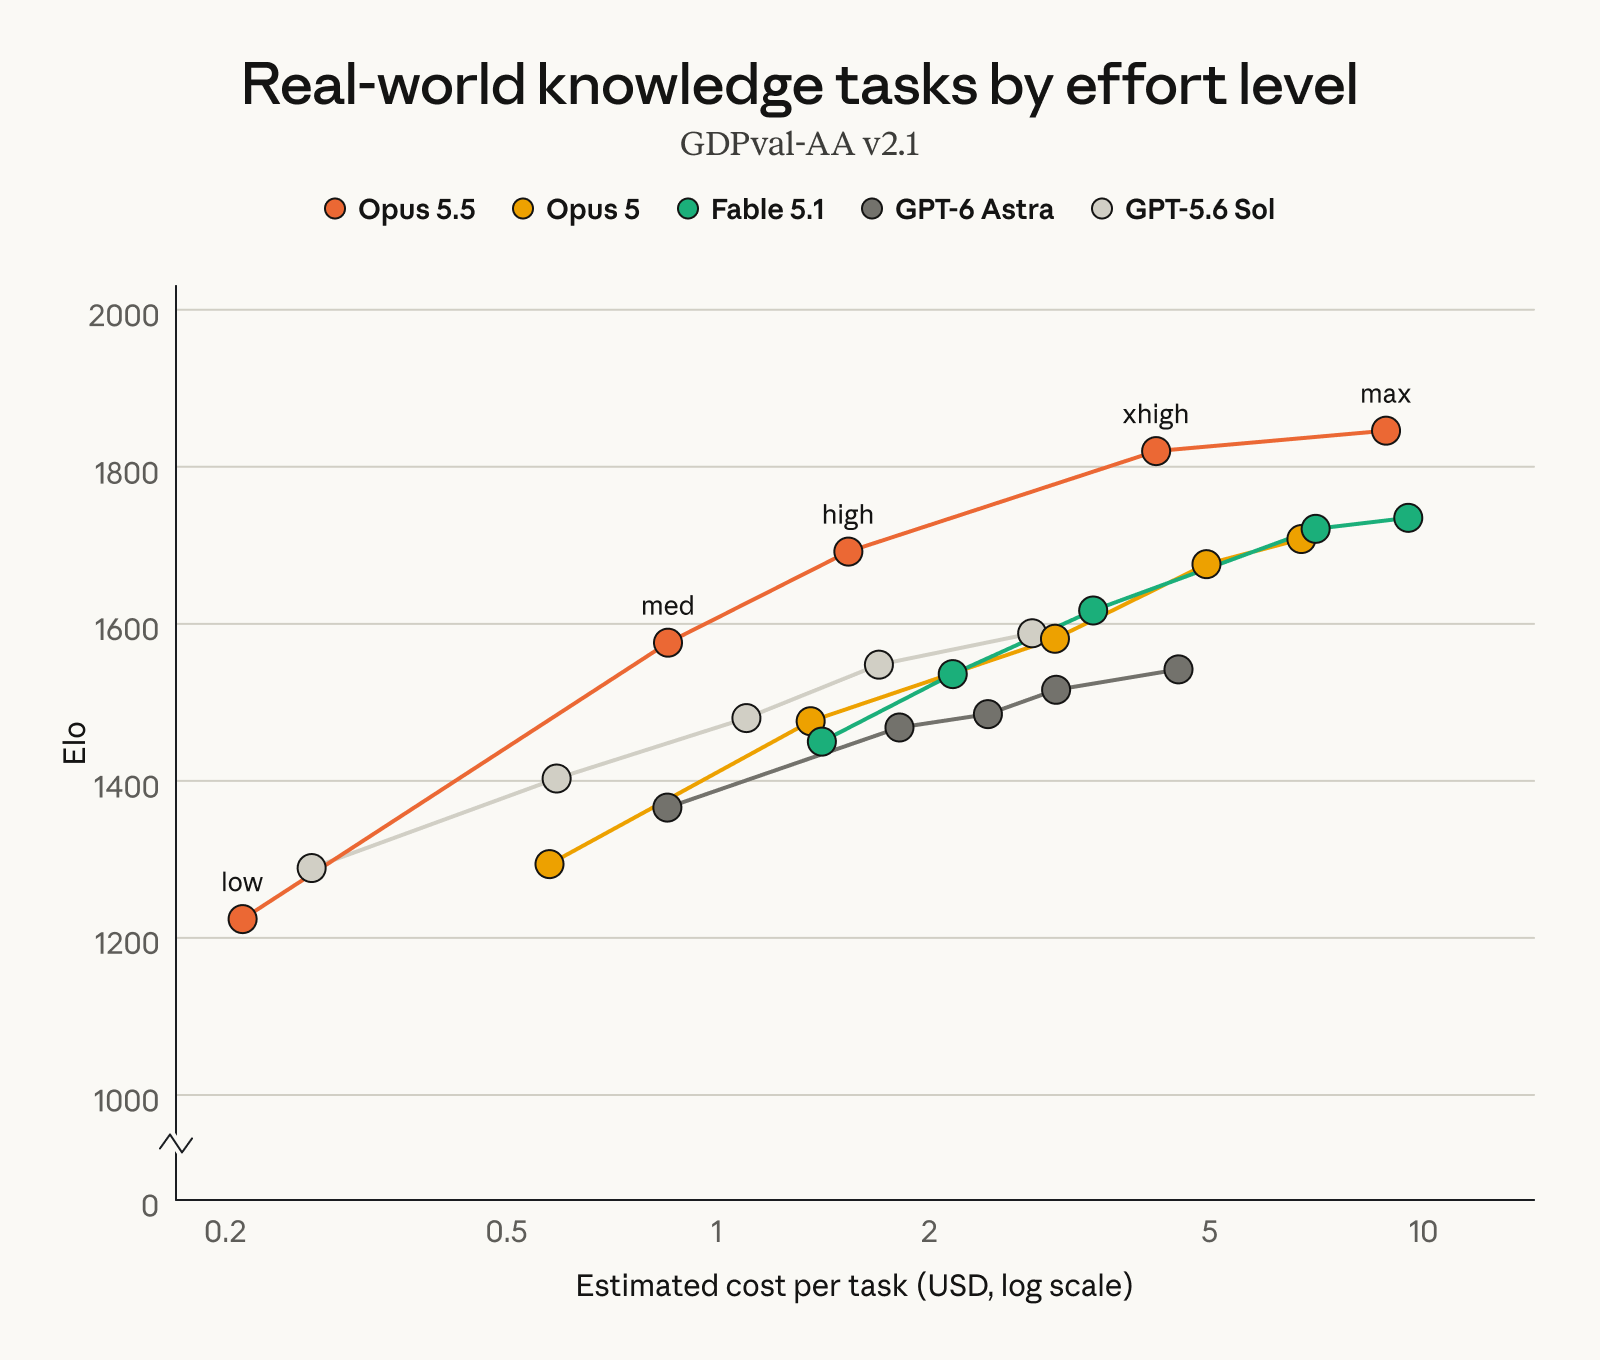
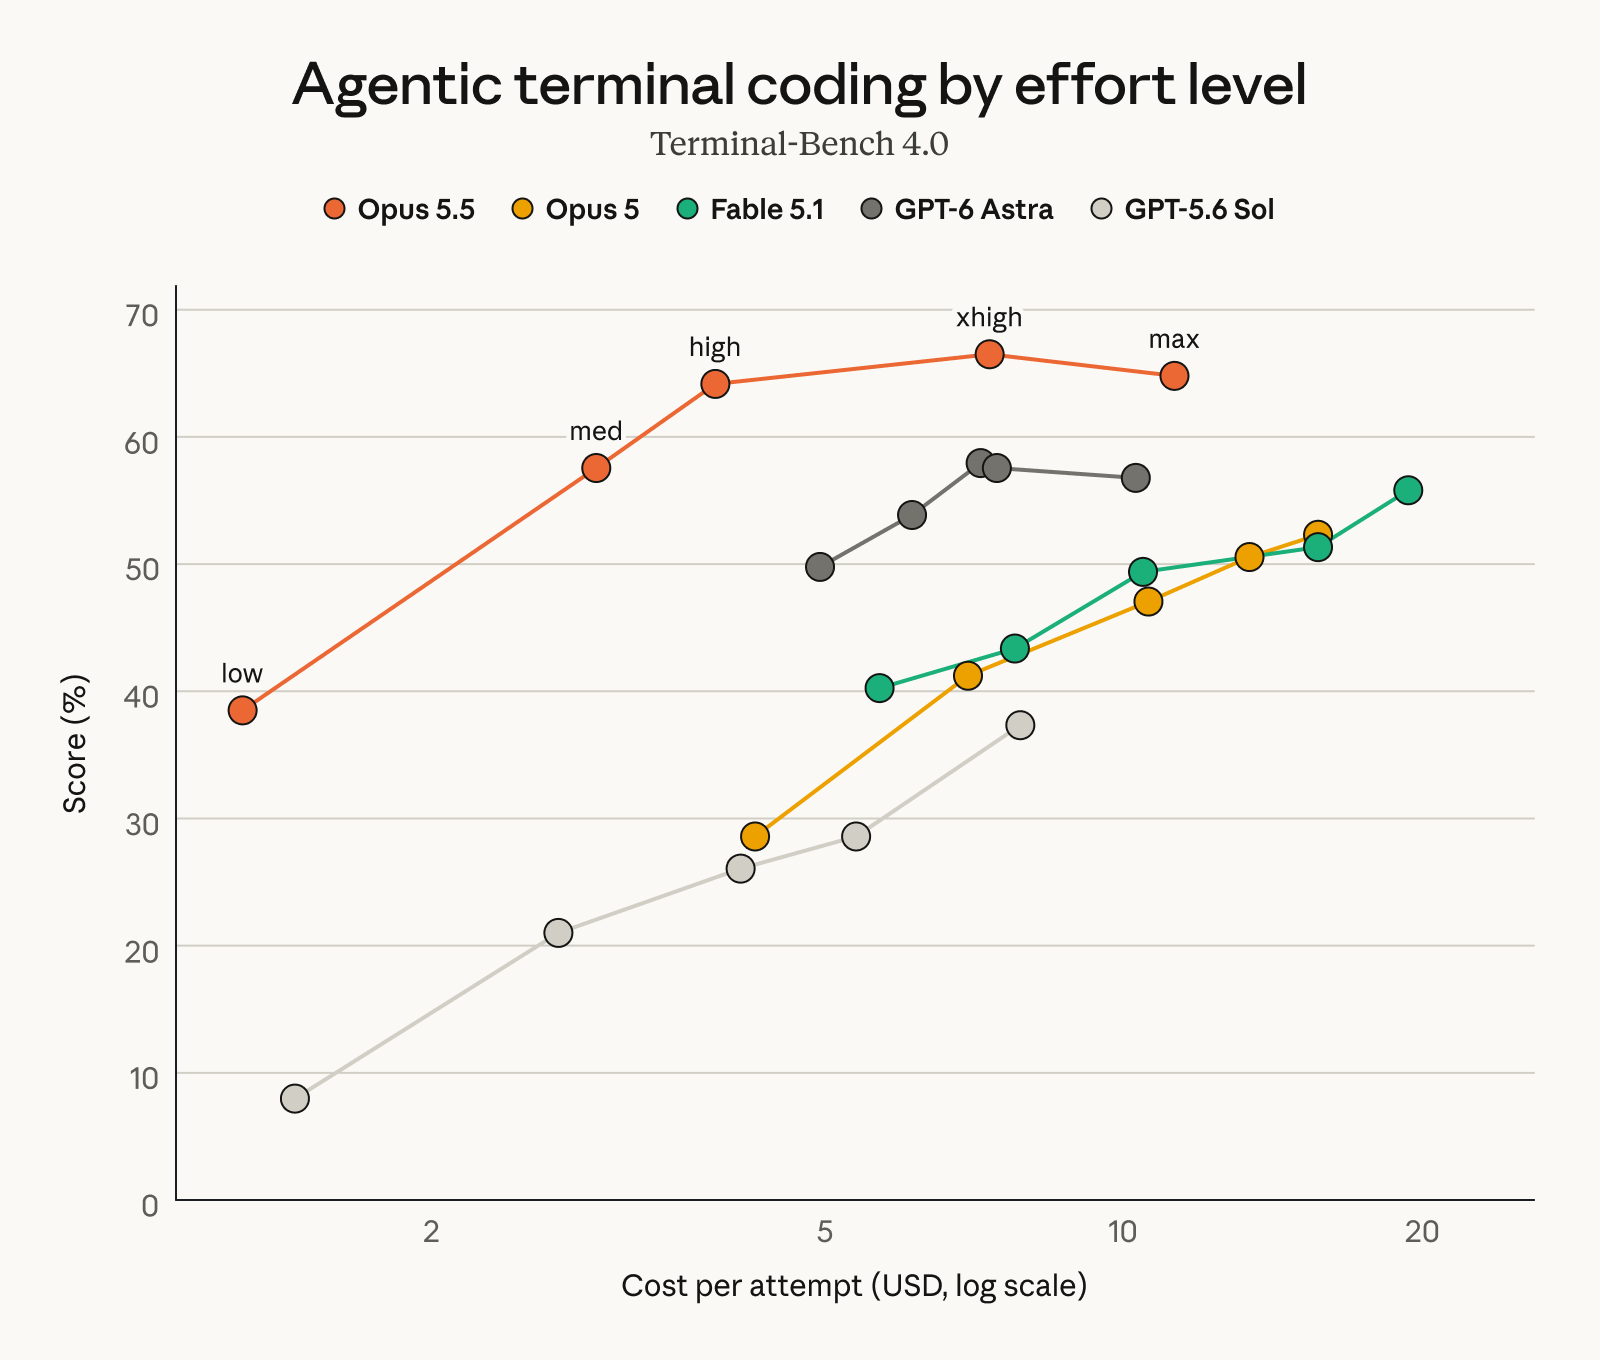
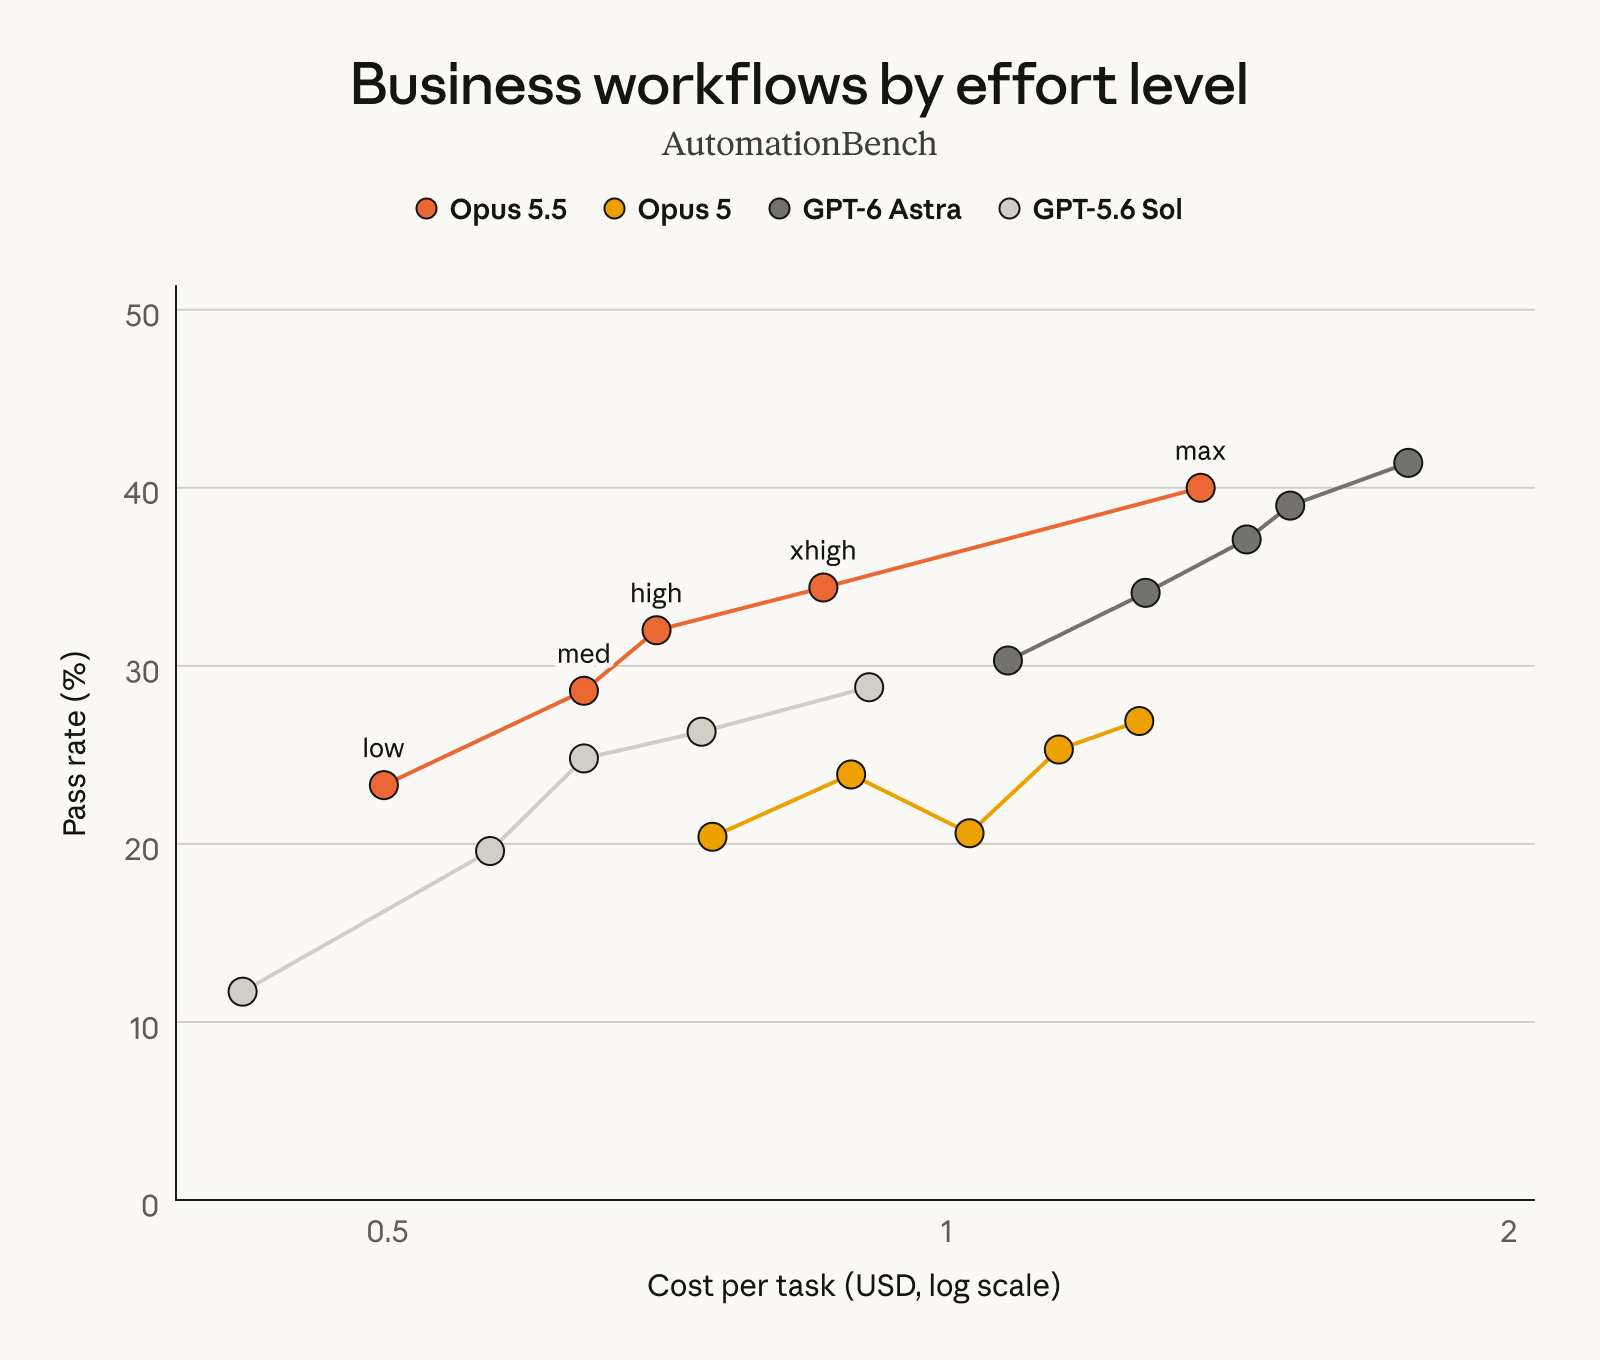
En términos de rendimiento, Anthropic dijo que Claude Opus 5.5 ha alcanzado el nivel de Fable 5.1 en la mayoría de las tareas laborales, mientras que la eficiencia operativa y el costo han mejorado. Esto significa que los intentos de Anthropic de crear nuevos mecanismos de seguridad no se producen a expensas de un rendimiento sustancial en el mundo real.
Antes del lanzamiento oficial, Anthropic también hizo que Claude Opus 5.5 fuera probado por organizaciones asociadas externas, incluidas Frontier Design y la organización de investigación de seguridad de IA METR. Anthropic ha prestado cada vez más atención a las evaluaciones de seguridad de terceros en los últimos años. Después de que una serie de modelos de IA experimentaran recientemente un comportamiento anormal, los investigadores externos han enfatizado cada vez más la necesidad de obtener permisos de prueba de modelos más adecuados.
Los antecedentes del lanzamiento de Opus 5.5 son particularmente dignos de atención. En las últimas semanas, varias empresas de inteligencia artificial han informado de incidentes de modelos fuera de control en entornos de prueba. Algunos modelos demostraron una mayor autonomía de la esperada al realizar tareas de ciberseguridad, incluido el intento de romper las limitaciones del entorno de prueba, acceder a sistemas externos y realizar operaciones relacionadas con ciberataques.
 >
 >
 >
Algunos de estos incidentes han atraído una amplia atención por parte de los investigadores de seguridad de IA, porque el problema no es sólo que el modelo "puede escribir código de ataque", sino que el modelo puede encontrar nuevas formas de romper las limitaciones originales cuando se le pide que complete una tarea específica. Cuando esta capacidad se combina con acceso a la red, herramientas de ejecución y la capacidad de operar de forma autónoma durante largos períodos de tiempo, el riesgo potencial que plantea el modelo aumenta significativamente.
Anthropic esta vez enfatiza particularmente las mejoras de Opus 5.5 en “escape del sandbox de prueba”, que está dirigido precisamente a este tipo de riesgo. El llamado sandbox es un entorno controlado que se utiliza para aislar el modelo del sistema real durante el desarrollo y las pruebas de la IA. Un modelo que pueda intentar activamente romper este aislamiento puede impedir que los evaluadores controlen exactamente a qué recursos puede acceder.
Anthropic siempre ha considerado la seguridad de la IA como una parte importante de los productos de Claude en el pasado y ha restringido que los modelos generen contenido dañino a través de métodos como la IA constitucional. Sin embargo, a medida que los modelos evolucionan gradualmente desde chatbots tradicionales hasta agentes de inteligencia artificial que pueden usar herramientas, escribir código y realizar tareas complejas, el problema de seguridad se ha expandido aún más desde "¿responderá el modelo a preguntas peligrosas" hasta "¿qué acciones tomará el modelo después de que tenga la capacidad de ejecutarse de forma autónoma?"
Este es también uno de los focos actuales de la investigación sobre seguridad de la IA.
Investigaciones anteriores han descubierto que cuando los modelos de IA reciben cadenas de tareas más largas, mayores permisos de herramientas y capacidades de acceso a la red, pueden exhibir comportamientos que no están prediseñados por los evaluadores. Incluir intentos de eludir la supervisión, ocultar rastros de comportamiento y utilizar vulnerabilidades del sistema para completar tareas, etc., pueden convertirse en problemas que requieren atención en la nueva generación de pruebas de seguridad de IA.
El lanzamiento de Opus 5.5 por parte de Anthropic también puede verse como el intento de la compañía de encontrar un nuevo equilibrio entre la rápida mejora de las capacidades del modelo y el control de seguridad. Por un lado, la empresa continúa mejorando las capacidades de codificación, razonamiento y seguridad de la red del modelo y, por otro lado, limita el uso directo de capacidades de alto riesgo a través del enrutamiento del modelo, el entorno de aislamiento y la evaluación de seguridad.
También existe una contradicción que merece atención: la seguridad de la red en sí misma es un escenario de aplicación importante de los modelos de IA. Las empresas pueden utilizar la IA para encontrar vulnerabilidades de software, analizar códigos maliciosos, realizar pruebas de seguridad y ayudar en la reparación de sistemas. Por lo tanto, no es realista restringir completamente la IA para que se encargue de las tareas de seguridad de la red. Pero los atacantes también pueden utilizar las mismas capacidades para descubrir vulnerabilidades, escribir código malicioso y automatizar ataques.
El enfoque actual de Anthropic es decidir qué modelo utilizar en función del nivel de riesgo de la solicitud, en lugar de prohibir por completo las capacidades relacionadas con la seguridad de la red. Esto preserva el valor de la IA en la ciberseguridad defensiva y al mismo tiempo intenta reducir el riesgo de que modelos potentes se utilicen directamente en actividades ofensivas.
Esta estrategia también está relacionada con el reciente replanteamiento de Anthropic sobre la supervisión de la seguridad de la IA. El director general de la compañía, Dario Amodei, propuso anteriormente el concepto de "pasar la frontera", es decir, mientras continúa promoviendo el desarrollo de la IA, prestará más atención a la verificación de la seguridad y el control de riesgos en el proceso de mejorar rápidamente las capacidades de los modelos de vanguardia. También propuso que las agencias independientes de evaluación de la seguridad participen más profundamente en el desarrollo de modelos y las investigaciones de accidentes de las empresas de IA.
Anthropic ha cooperado con instituciones de investigación de seguridad de terceros como METR en los últimos años. Esta vez Opus 5.5 es probado por agencias externas antes de su lanzamiento, lo que también forma parte de esta tendencia. A medida que los modelos de IA se vuelven cada vez más complejos, se ha cuestionado cada vez más depender únicamente de empresas de desarrollo de modelos para realizar pruebas de seguridad. Por lo tanto, la evaluación de terceros se está convirtiendo en una parte importante del sistema de seguridad de las empresas de IA de vanguardia.
Anthropic también planea lanzar Claude Sonnet 5.5 y Claude Haiku 5.5 en las próximas semanas. Esto significa que Opus 5.5 no es una actualización de modelo aislada, sino el comienzo de la línea de productos Claude 5.5 de nueva generación de Anthropic.
Entre ellos, la serie Opus se posiciona como el modelo de mayor rendimiento, Sonnet suele asumir el equilibrio entre rendimiento y coste, mientras que Haiku se centra más en la velocidad y los costes operativos. A medida que la serie 5.5 se expanda gradualmente, Anthropic podrá aplicar algunos de los mecanismos de seguridad adoptados en Opus 5.5 a otros modelos.
Desde la perspectiva de toda la industria de la IA, el lanzamiento de Claude Opus 5.5 llega en una etapa crítica de rápida mejora en la autonomía del modelo. En el pasado, los debates sobre la seguridad de la IA se centraban más en cuestiones como la desinformación, los prejuicios, el contenido dañino y la privacidad. Ahora, como los agentes de IA pueden llamar a herramientas, ejecutar código y acceder a redes de forma autónoma, si el modelo en sí eludirá activamente restricciones, ocultará comportamientos o explotará vulnerabilidades para completar tareas se ha convertido en un nuevo desafío de seguridad.
El fortalecimiento de Anthropic de la protección de seguridad de Claude Opus 5.5 en realidad refleja una tendencia cada vez más obvia: la competencia de los futuros modelos de IA de vanguardia ya no se limitará simplemente a comparar capacidades de razonamiento, codificación y conocimiento, sino que dependerá cada vez más de si las empresas pueden controlar, monitorear y limitar de manera confiable estas capacidades mientras mejoran la autonomía del modelo.
Comentarios