Resumen:
En el contexto de una competencia cada vez más feroz en la tecnología de inteligencia artificial, Apple, que siempre ha sido conocida por su estricta protección de la privacidad, está realizando ajustes estratégicos en sus políticas de datos principales. Las últimas noticias muestran que Apple ha cambiado su compromiso anterior de no utilizar nunca datos personales de los clientes para entrenar modelos generales de IA y ha comenzado a explorar el uso de datos de interacción de usuarios anónimos o autorizados bajo marcos específicos para acelerar el entrenamiento y la optimización de sus algoritmos de inteligencia artificial y sistemas de aprendizaje automático.
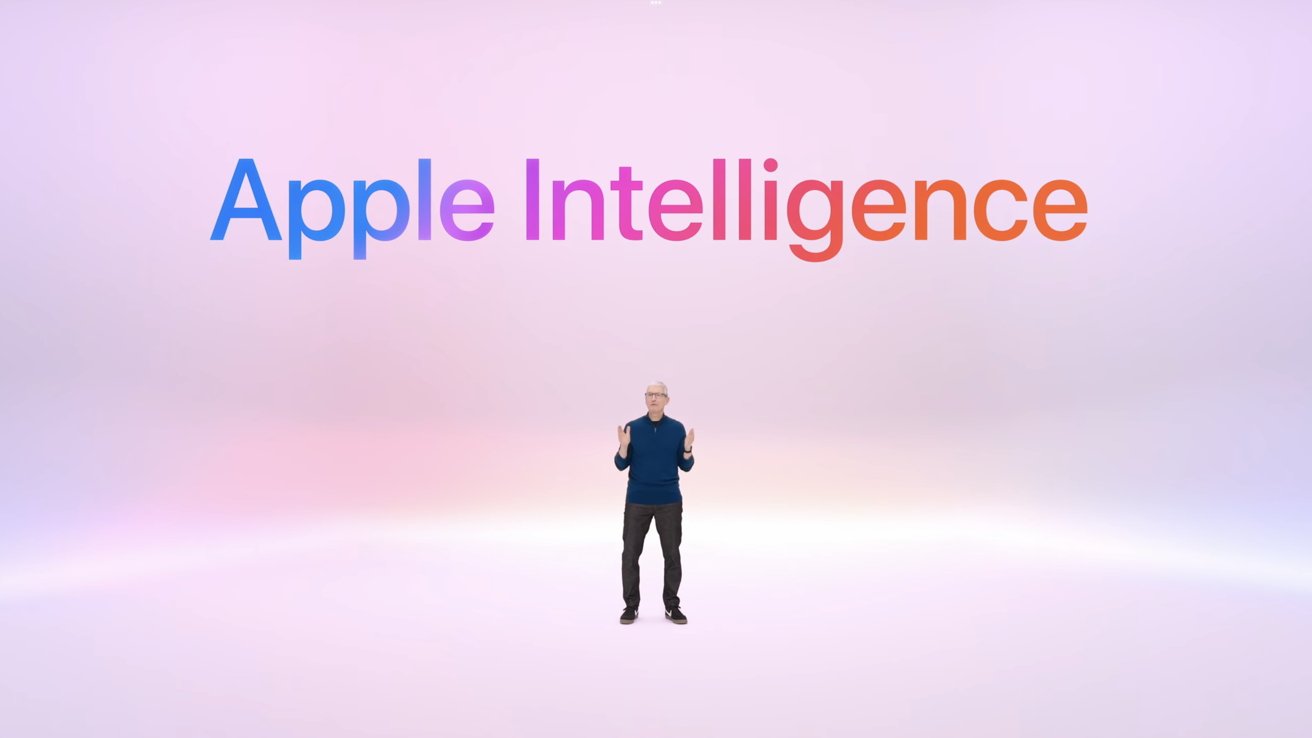
Durante mucho tiempo, Apple siempre ha considerado la "prioridad del lado del dispositivo" y la "capacitación en recopilación de datos cero" como sus principales puntos de venta entre los gigantes tecnológicos, enfatizando que las funciones de inteligencia artificial, incluida Apple Intelligence, dependen principalmente de la potencia informática del chip local para su funcionamiento, y la computación en la nube privada (Private Cloud Compute) que involucra cálculos complejos también promete que los datos se destruirán después de la lectura, no se retendrán ni se utilizarán para capacitación secundaria. Sin embargo, a medida que aumenta considerablemente la demanda de datos de escenas de interacción real de alta calidad para modelos lingüísticos a gran escala y modelos multimodales, depender únicamente del rastreo web público y de conjuntos de datos con derechos de autor adquiridos comercialmente está mostrando gradualmente sus limitaciones.
Según revelaciones de expertos en la cadena de suministro y el ecosistema de software, el ajuste de Apple esta vez no es un cambio hacia la captura integral de datos finales, sino un mecanismo por fases más controlado. Los usuarios tendrán derechos claros a saber y elegir, y el sistema puede introducir opciones de suscripción más sofisticadas en el futuro, lo que permitirá a los consumidores decidir si desean compartir de forma anónima entradas de texto no identificadas, registros de interacción de Siri o comentarios sobre el uso de aplicaciones para ayudar a mejorar la calidad del modelo. Al mismo tiempo, la privacidad diferencial y la tecnología de generación de datos sintéticos locales seguirán sirviendo como una barrera inicial para el preprocesamiento de datos para evitar que cualquier información confidencial de identificación personal se asocie físicamente con los pesos del modelo.
Los analistas señalaron que el ajuste de Apple de su política de capacitación en datos refleja la presión real que enfrenta en la competencia por las capacidades de los modelos grandes. En comparación con competidores como OpenAI, Google y Meta, la falta de información rica y en tiempo real sobre el corpus de usuarios ha constituido un cuello de botella que no se puede ignorar para la evolución de los siguientes modelos de terminales a gran escala de Apple, las capacidades de comprensión del contexto entre aplicaciones e incluso la nueva generación de Siri. Al liberalizar algunos canales regulados de capacitación de datos, Apple está tratando de proporcionar a su ecosistema de inteligencia artificial el combustible clave necesario para la iteración del algoritmo mientras se adhiere a su marca de "privacidad primero".
Comentarios