Resumen:
Google anunció hoy oficialmente su último avance en el campo de la interacción de voz nativa de extremo a extremo, lanzando una nueva generación de modelos grandes de voz en tiempo real Gemini 3.8 Live y Gemini 3.8 Live Extended Thinking personalizados para tareas difíciles.
Estos dos modelos representan un gran avance en el sistema de tecnología nativa de audio a audio de Google. No solo llevan el retraso y la naturalidad de las conversaciones en tiempo real a nuevas alturas, sino que también logran por primera vez profundas capacidades de razonamiento de varios pasos en flujos de voz de baja latencia, cambiando por completo el paradigma de aplicación de la IA de voz en escenarios profesionales complejos.
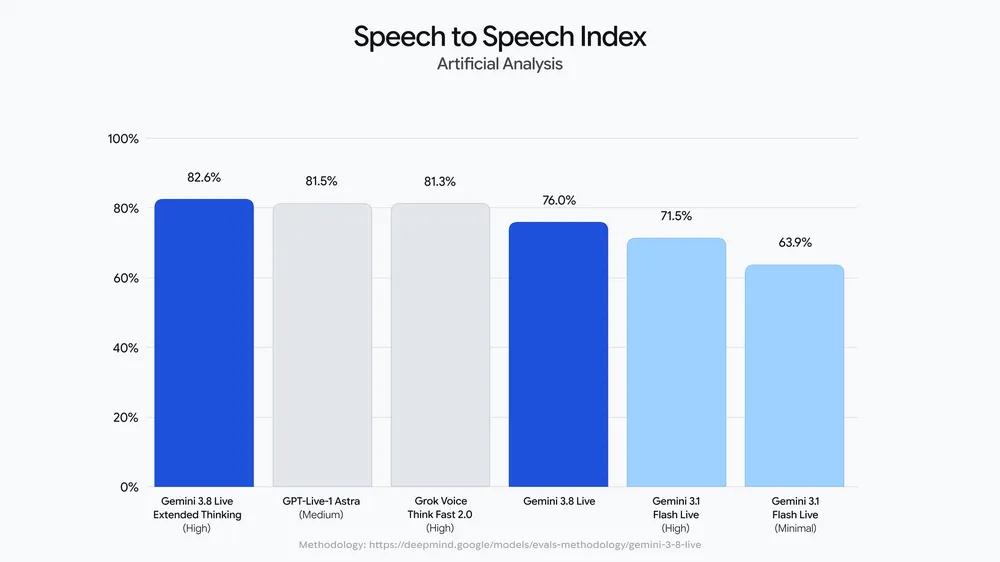
En la arquitectura de interacción de voz convencional anterior, los sistemas de IA generalmente necesitaban llegar a un compromiso entre "diálogo superficial de respuesta rápida" y "pensamiento profundo a largo plazo". Enfrentarse a problemas difíciles a menudo requería que los usuarios soportaran largos períodos de espera silenciosa. Gemini 3.8 Live lanzado por Google se centra en optimizar la conversación ultrarrápida y la experiencia de interacción de transmisión diaria. Puede proporcionar a los usuarios una comunicación de voz en tiempo real extremadamente fluida y a nivel humano con fluctuaciones de entonación más sensibles, interrupciones naturales y capacidades de comprensión del contexto. Gemini 3.8 Live Extended Thinking, lanzado sobre esta base, se ha actualizado fundamentalmente para flujos de negocios altamente complejos. Este modelo le da a la IA la capacidad de "pensar como habla" en segundo plano, lo que permite que el sistema realice simultáneamente un desmontaje lógico complejo de varios pasos, depuración de código o diagnóstico técnico en segundo plano mientras mantiene un diálogo coherente en tiempo real, sin la necesidad de interrumpir abruptamente el ritmo de la conversación cuando se encuentran problemas difíciles.
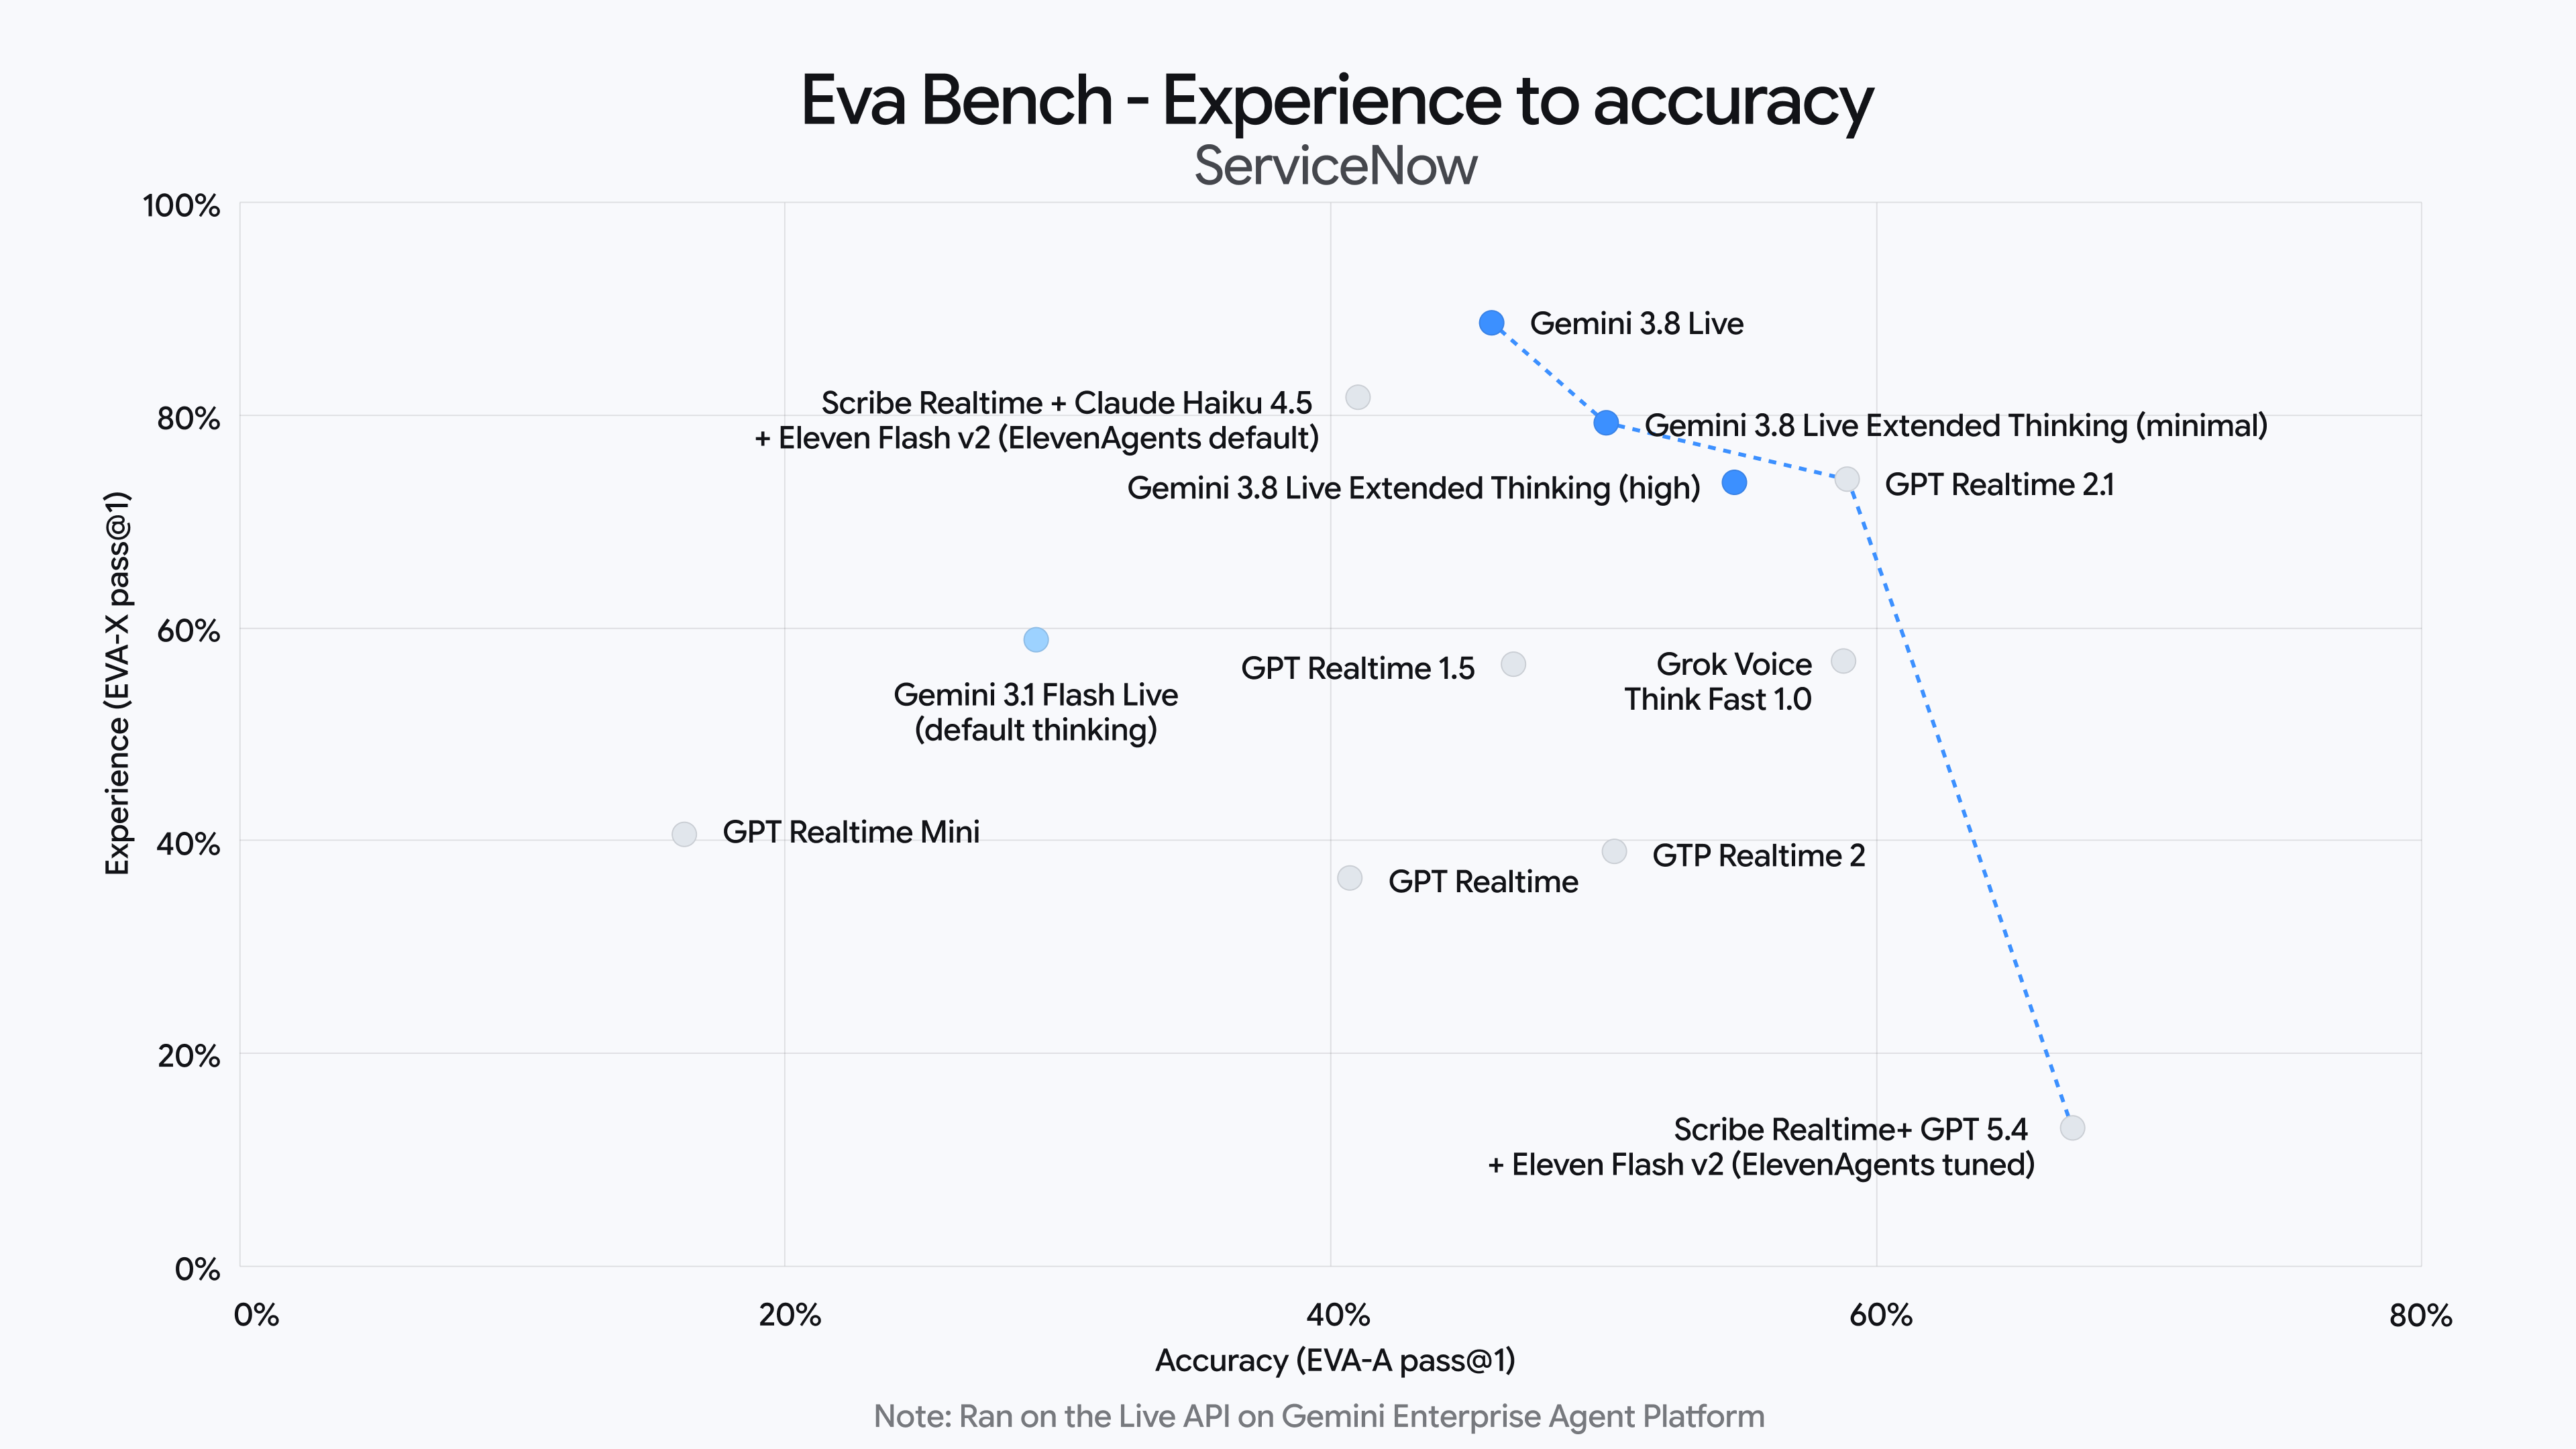
En términos de aplicación práctica, la nueva generación de modelos de la serie Live ampliará significativamente los límites de servicio de los asistentes de voz. Además de las conversaciones naturales diarias, Gemini 3.8 Live y las versiones de razonamiento extendido han demostrado un rendimiento significativamente mejor que las versiones anteriores en escenarios con altas exigencias intelectuales, como resolución de problemas de pasos en tiempo real, derivaciones matemáticas complejas, tutoría simultánea en idiomas extranjeros en tiempo real y ejecución de instrucciones en streaming multitarea, ocupando el primer lugar en múltiples puntos de referencia de la industria de razonamiento multimodal y del habla.
Para los desarrolladores y usuarios empresariales, Google anunció que a partir de ahora se abrirá oficialmente el acceso a las capacidades del modelo relevante a través de Gemini API y Google AI Studio. Los desarrolladores pueden llamar directamente a esta interfaz API de audio nativa de latencia extremadamente baja para crear rápidamente servicios de agente de voz full-duplex de próxima generación con capacidades de razonamiento de alto orden en formas de productos como hardware inteligente, servicio al cliente, asistencia de programación en tiempo real y oficina colaborativa.
Comentarios