
Resumen:
Microsoft anunció oficialmente el chip de inteligencia artificial Maia 300 de desarrollo propio de tercera generación y planea implementarlo en un entorno de producción a partir de 2027 para respaldar las tareas de razonamiento de IA detrás de productos y servicios como Copilot. Microsoft dijo que, en comparación con el sistema GPU líder actual, se espera que Maia 300 pueda procesar un 40% más de tokens por megavatio de potencia; en una configuración de rack completa que consta de 96 aceleradores, su rendimiento de token a nivel de rack puede ser hasta 7 veces mayor que el de la generación anterior Maia 200.
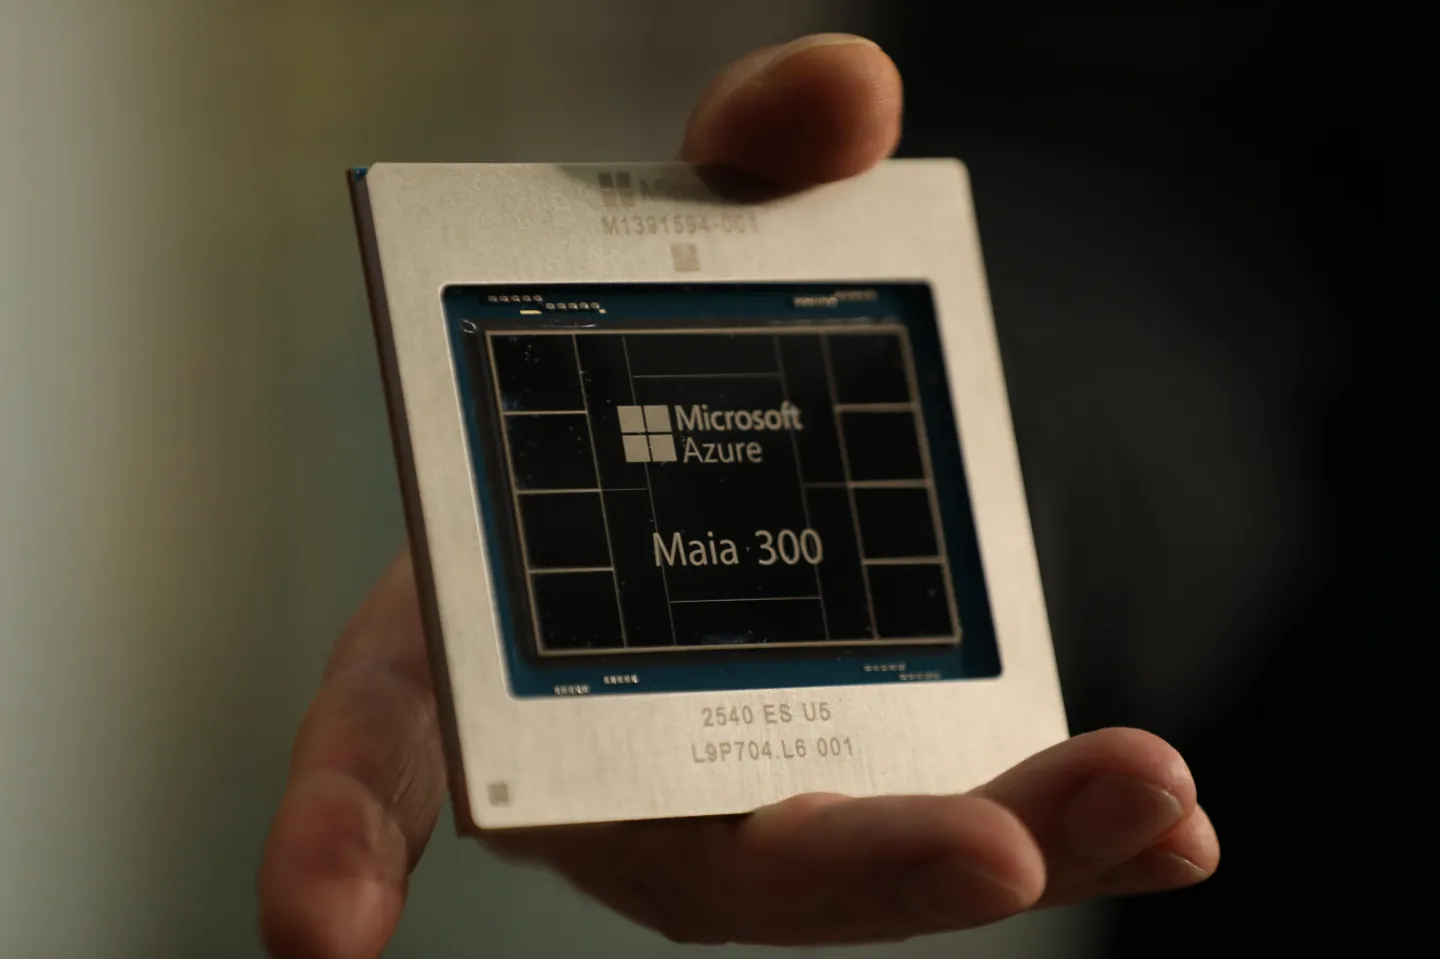
Este lanzamiento marca la mayor inversión de Microsoft en chips de IA de desarrollo propio. A medida que el uso de servicios de inteligencia artificial continúa creciendo, Microsoft espera reducir los costos operativos, mejorar la eficiencia energética y reducir la dependencia de las GPU de proveedores como Nvidia y AMD a través de aceleradores de diseño propio.
Scott Guthrie, vicepresidente ejecutivo del negocio de computación en la nube de Microsoft, dijo que la compañía planea expandir la escala de implementación de los chips de la serie Azure Maia al nivel de varios gigavatios a partir de 2027 y convertirlo en el principal sistema de inferencia de IA para los productos y servicios de Microsoft.
Este objetivo significa que Microsoft espera actualizar gradualmente los chips de desarrollo propio de parte de la infraestructura existente a una plataforma informática central que admita sus propios servicios de inteligencia artificial. Sin embargo, esto no significa que Microsoft dejará de comprar GPU de Nvidia o AMD por completo. Es probable que Microsoft continúe utilizando múltiples plataformas de hardware para tareas de capacitación e inferencia que requieren diferentes capacidades informáticas.
Maia 300 es el producto de tercera generación de la serie Maia de Microsoft y también es el chip de próxima generación lanzado después del anuncio de Maia 200 en enero de este año. Maia 200 se utiliza actualmente para cargas de trabajo de IA en múltiples entornos de producción de Microsoft, incluidos Microsoft Copilot, GitHub Copilot, Microsoft Foundry y los modelos de inteligencia artificial de desarrollo propio de Microsoft.
Guthrie dijo que, a juzgar por los indicadores operativos de los servicios de IA reales, Maia 200 ya es una de las infraestructuras de IA de mejor rendimiento dentro de Microsoft. La nueva generación Maia 300 está diseñada específicamente para cargas de trabajo de IA en constante cambio, especialmente aquellas que necesitan manejar razonamientos de contexto prolongado, conversaciones en tiempo real que son altamente sensibles a la latencia y tareas de agentes de IA que ejecutan continuamente múltiples pasos.
Estas aplicaciones imponen requisitos de hardware diferentes a los de la inferencia tradicional de IA.
A medida que los modelos de lenguaje a gran escala se utilizan gradualmente en asistentes de programación, automatización empresarial y ejecución de tareas complejas, el contexto que los sistemas de IA necesitan procesar es cada vez más largo, y una sola tarea implica cada vez más llamadas de modelos y operaciones de herramientas. Para los proveedores de servicios en la nube, además del rendimiento del modelo en sí, también se debe considerar la latencia de respuesta, la cantidad de solicitudes simultáneas, la capacidad de memoria y el costo real de cada inferencia.
Por lo tanto, el objetivo del diseño de Maia 300 no es sólo aumentar la potencia informática máxima, sino también mejorar la eficiencia general en un entorno empresarial de la vida real que funciona continuamente. Microsoft espera optimizar específicamente la arquitectura del chip para hacerla más adecuada para manejar la carga informática generada por los modelos de inferencia y agentes de IA de nueva generación.
En términos de fabricación de chips, Maia 300 adopta el proceso avanzado N2P de TSMC e introduce una arquitectura de diseño basada en núcleos. En comparación con los diseños tradicionales que integran diferentes funciones en un único chip grande, la arquitectura del chip central puede dividir funciones como computación, controlador de memoria y entrada y salida en diferentes módulos y luego diseñarlos de acuerdo con sus respectivas características.
El equipo de infraestructura y hardware de Microsoft Azure afirmó que este diseño permite utilizar más área de silicio en el chip para el rendimiento informático, al tiempo que permite que diferentes módulos funcionales adopten tecnologías que sean más adecuadas para sus propias necesidades.
Esta idea tiene un significado práctico. Para los aceleradores de IA, la unidad informática es importante, pero la forma en que se transmiten los datos entre la unidad informática, la memoria y los dispositivos externos también afectará el rendimiento general. Si la unidad informática necesita esperar a que lleguen los datos, incluso si tiene una alta potencia informática teórica, no podrá aprovechar al máximo su rendimiento.
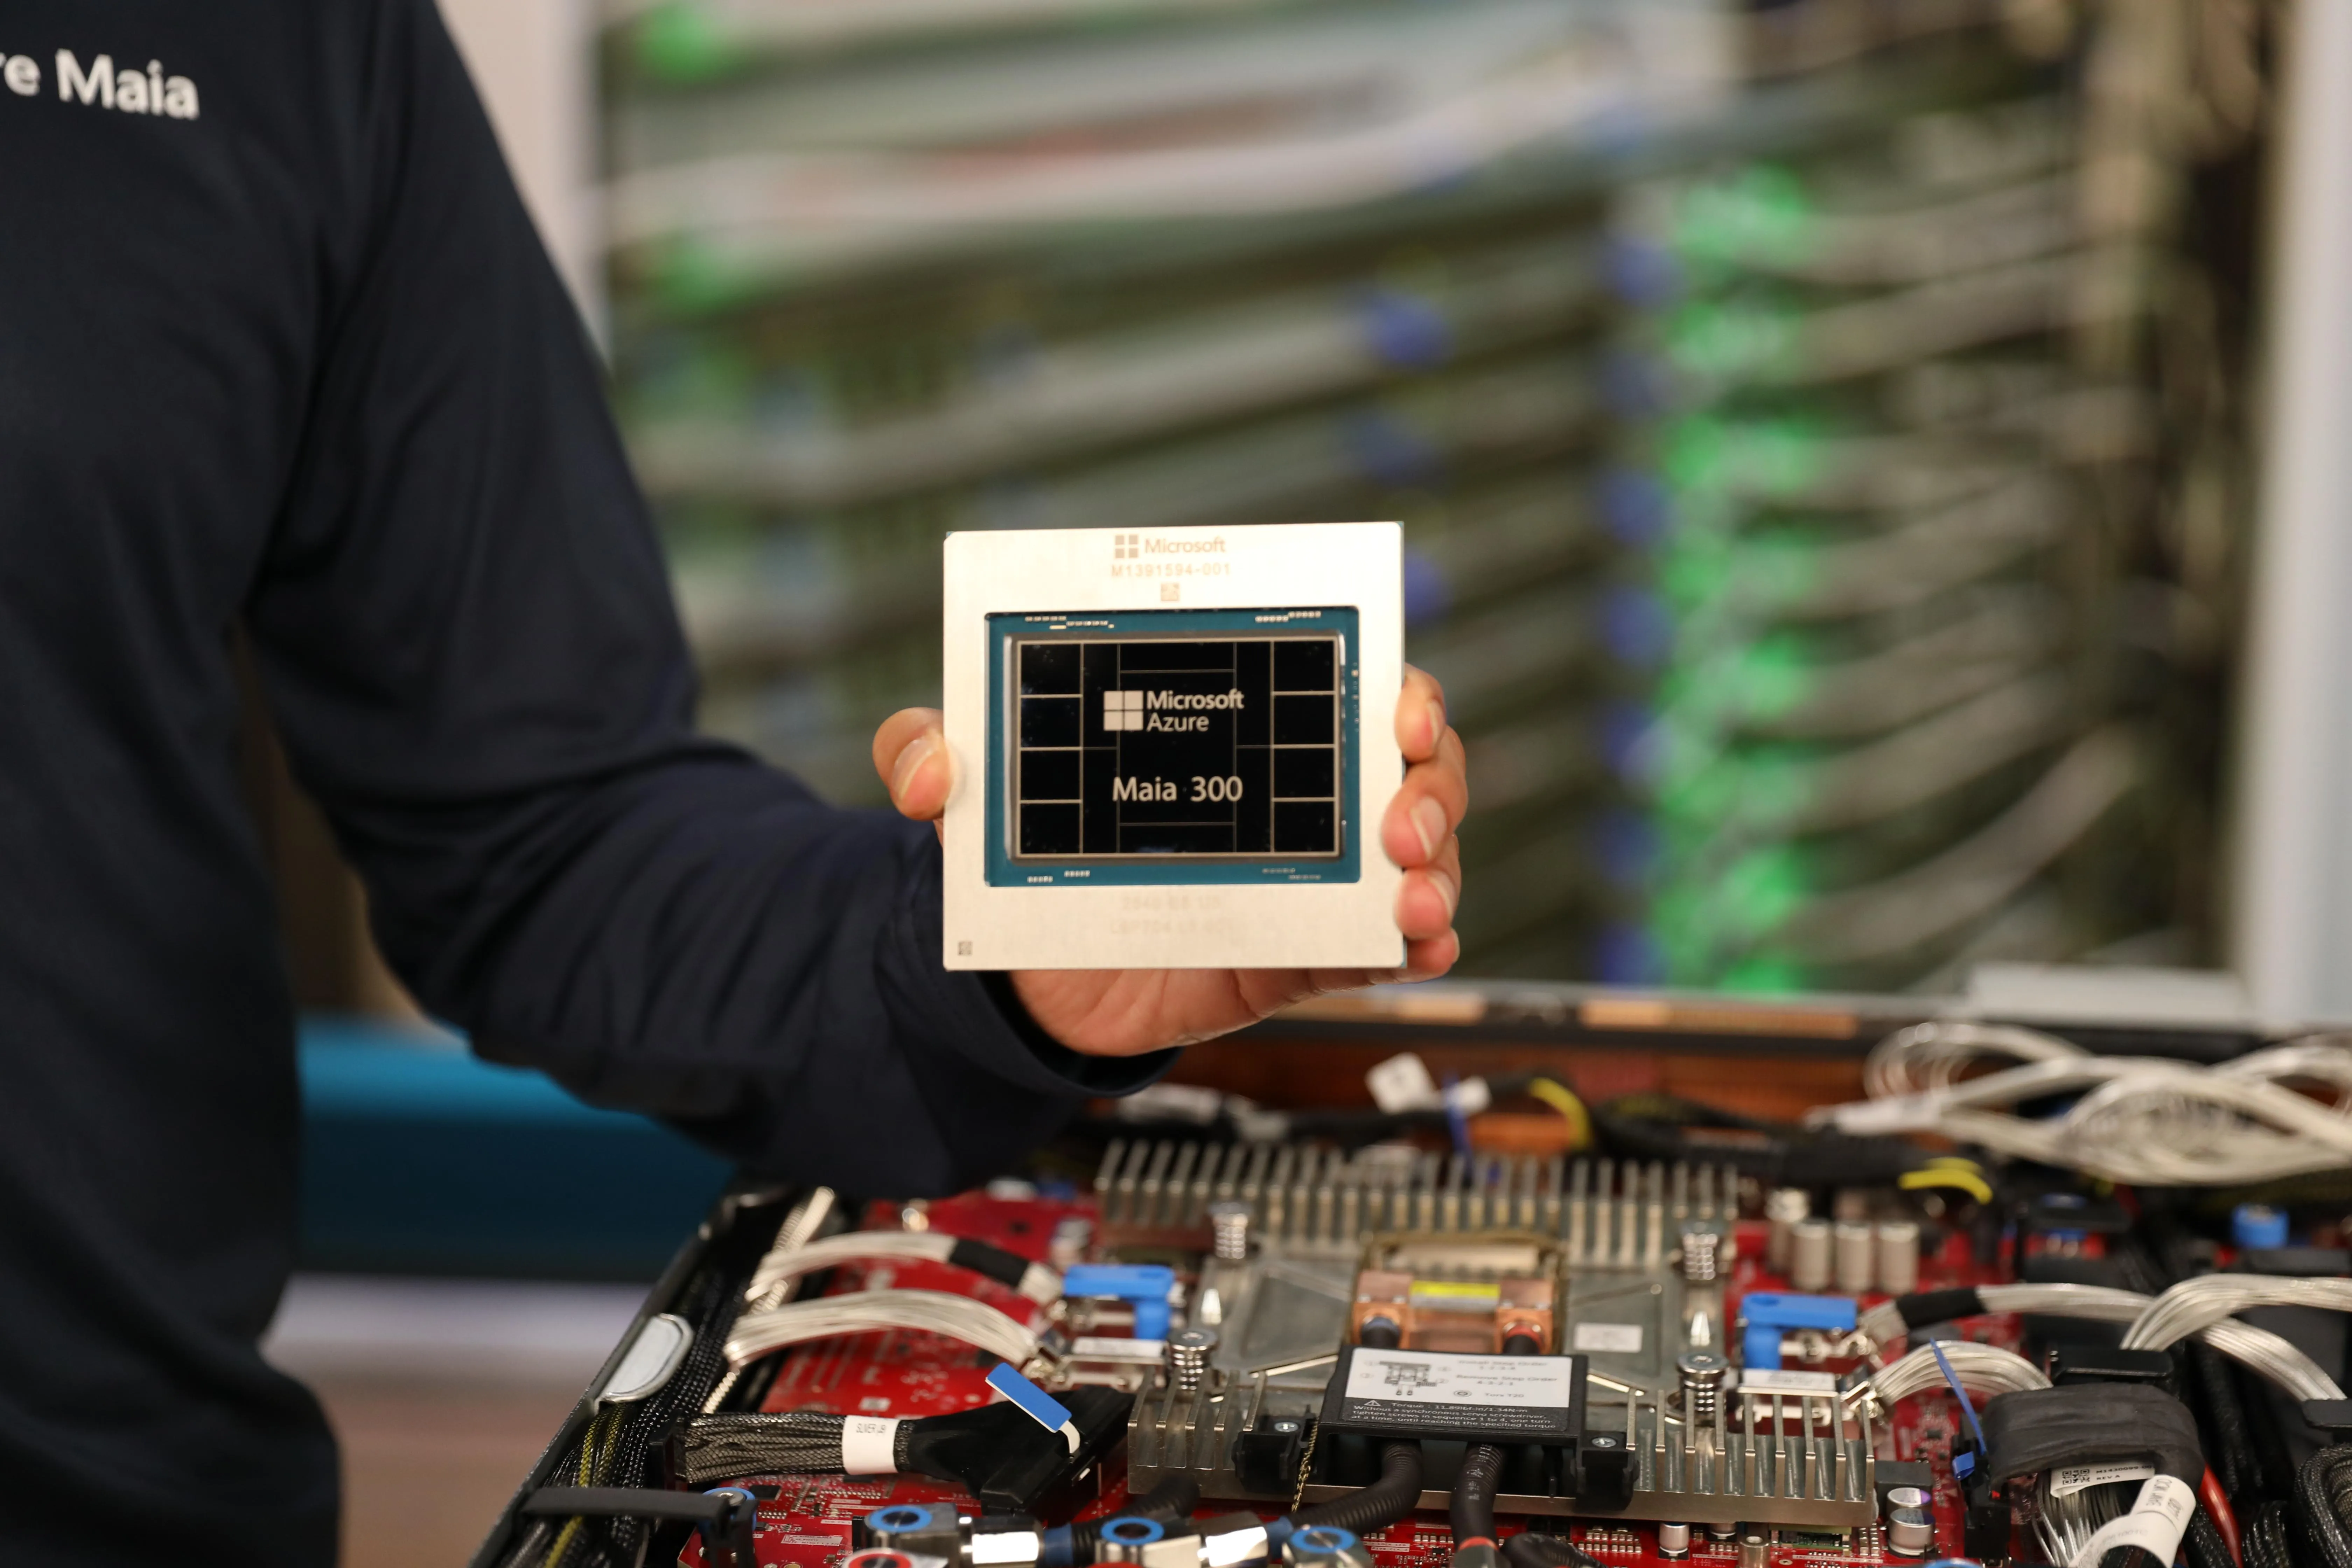
Al optimizar la informática, el control de la memoria y las funciones de entrada y salida por separado, Microsoft espera mejorar la eficiencia general de utilización de recursos del chip y lograr un mejor equilibrio entre el rendimiento, el consumo de energía y los costos de fabricación.
El uso de procesos avanzados también ayudará a mejorar la densidad del transistor y la eficiencia energética, pero el rendimiento final del chip aún depende de múltiples factores como la microarquitectura, el subsistema de memoria, el diseño de interconexión y la optimización del software. Los datos de rendimiento publicados por Maia 300 actualmente provienen principalmente de la propia introducción de Microsoft, y el efecto real aún debe evaluarse en función de diferentes modelos, cargas de trabajo y condiciones de implementación.
En el campo del razonamiento de la IA, el rendimiento del token es uno de los indicadores importantes para medir la eficiencia del sistema. El token es la unidad de datos básica utilizada por los modelos de lenguaje grandes al procesar texto y generalmente corresponde a una palabra, fragmento de palabra u otra unidad de texto. La cantidad de tokens que el sistema puede procesar por unidad de tiempo afecta directamente a la cantidad de usuarios a los que atiende al mismo tiempo y a los recursos informáticos necesarios para completar la tarea.
Microsoft espera que Maia 300 maneje un 40% más de tokens por megavatio que los principales sistemas GPU. Esto significa que con el mismo presupuesto de energía, se espera que Microsoft procese más solicitudes de IA o reduzca el consumo de energía mientras brinda las mismas capacidades de servicio.
Para los proveedores de servicios en la nube con centros de datos a gran escala, esta mejora de la eficiencia puede aportar un valor económico significativo. Los centros de datos de IA no sólo necesitan comprar costosos aceleradores, sino que también deben asumir los costos de suministro de energía, refrigeración, equipos de red y construcción de infraestructura. A medida que el uso de modelos continúa creciendo, el suministro de energía y la capacidad del centro de datos se están convirtiendo en factores importantes que restringen la expansión de los servicios de IA.
Sin embargo, la eficiencia del token por megavatio no es el único indicador para medir los chips de IA. La escala de parámetros, la longitud del contexto, la configuración de precisión y los métodos de inferencia de diferentes modelos afectarán los resultados de la prueba. Para comparar de manera integral productos como Maia 300 y las GPU NVIDIA, también es necesario considerar la latencia, la compatibilidad de modelos, el ecosistema de software, los costos de implementación y la estabilidad en el negocio real.
Microsoft también anunció un indicador más atractivo: en una configuración de rack completa que consta de 96 aceleradores, el rendimiento del token a nivel de rack de Maia 300 puede alcanzar hasta 7 veces el de Maia 200.
Esta figura muestra que Microsoft no solo espera mejorar la eficiencia de un solo chip, sino que también optimiza la potencia informática de todo el bastidor. Pero describe el rendimiento a nivel de rack bajo una configuración específica. No quiere decir que Maia 300 sea 7 veces más rápido que Maia 200 en todas las tareas, ni se puede deducir directamente que el rendimiento de cada chip haya mejorado en la misma proporción.
Para las plataformas de computación en la nube, el rendimiento a nivel de rack es especialmente importante. Las implementaciones en el mundo real suelen consistir en una gran cantidad de aceleradores, en los que los chips intercambian datos a través de interconexiones de alta velocidad y procesan conjuntamente solicitudes de modelos. Incluso si un solo chip es potente, todo el sistema aún puede verse limitado si el ancho de banda de interconexión, la capacidad de memoria o la eficiencia de la programación son insuficientes.
Por lo tanto, Microsoft está tratando de llevar a cabo una optimización general desde el diseño del chip, la configuración del bastidor hasta el software y el entorno operativo del modelo, en lugar de simplemente perseguir la potencia informática teórica del procesador.
El jefe de inteligencia artificial de Microsoft, Mustafa Suleyman, dijo que la empresa debe comenzar a invertir desde la parte inferior de toda la tecnología, incluido el diseño de chips. Él cree que cuando los servicios de inteligencia artificial alcanzan una escala tan grande, Microsoft necesita tener su propia plataforma y permitir que los chips y los modelos de desarrollo propio sean codiseñados y optimizados.
Enfatizó particularmente que permitir que los modelos de IA desarrollados por Microsoft se ejecuten en chips Maia es una tarea importante para el equipo de IA de Microsoft.
Esta declaración revela otro objetivo del desarrollo de chips de desarrollo propio de Microsoft: combinar hardware, modelos y servicios en la nube para formar una relación de colaboración más estrecha.
Los proveedores de servicios en la nube tradicionales pueden implementar modelos de IA comprando GPU de uso general, pero si pueden diseñar sus propios aceleradores, pueden optimizar las características informáticas, los requisitos de memoria y los procesos de inferencia de sus propios modelos. A su vez, el equipo del modelo puede ajustar la estructura del modelo y el método de operación de acuerdo con la arquitectura del chip, mejorando así la eficiencia general.
Google y Amazon llevan muchos años invirtiendo en chips de IA de desarrollo propio. Google tiene una serie de aceleradores de TPU y Amazon ha desarrollado chips como Trainium para respaldar sus propios servicios de inteligencia artificial y computación en la nube. Microsoft lanzó la serie Maia para fortalecer sus capacidades de infraestructura en este contexto competitivo.
Para Microsoft, el valor estratégico de los chips de desarrollo propio no es solo reducir los costos de adquisición, sino también mejorar la autonomía de la cadena de suministro, optimizar la utilización de la energía del centro de datos y tener un mayor control del diseño del hardware cuando los modelos y servicios de IA se iteran rápidamente.
En la actualidad, Microsoft aún mantiene una estrecha cooperación con NVIDIA, y las GPU de NVIDIA continúan desempeñando un papel importante en el campo del entrenamiento y la inferencia de IA. El desarrollo simultáneo de la serie Maia por parte de Microsoft no significa que la relación entre las dos partes inevitablemente cambiará fundamentalmente, pero refleja que los grandes proveedores de servicios en la nube están reduciendo su dependencia de una única plataforma de hardware a través de chips de desarrollo propio y estrategias de múltiples proveedores.
Microsoft también espera utilizar chips de desarrollo propio para mejorar la competitividad de sus modelos de IA. Suleiman dijo que la plataforma Maia es una parte importante del sistema de tecnología de inteligencia artificial de Microsoft y puede ayudar a la compañía a desarrollar aún más sus propios modelos y mejorar su competitividad frente a competidores como Google DeepMind, OpenAI y Anthropic.
A medida que los modelos de IA evolucionan gradualmente desde simples herramientas de generación de texto hasta sistemas de agentes que pueden llamar a herramientas y realizar operaciones complejas, la importancia de la infraestructura de hardware también está aumentando. El razonamiento de contexto prolongado y la ejecución de tareas de varios pasos a menudo implican procesos computacionales más largos y una gran cantidad de llamadas a modelos. Sólo logrando un mejor equilibrio entre rendimiento, latencia y costo podrán las empresas escalar sus servicios de manera sostenible.
Maia 300 está diseñado en respuesta a esta tendencia. Microsoft espera permitir que se ejecuten más tareas de IA a costos más bajos a través de un mayor rendimiento y eficiencia energética, al tiempo que brinda soporte informático para Copilot, GitHub Copilot y futuros servicios de agentes de IA.
Sin embargo, para que Maia 300 se convierta realmente en la fuerza principal de la infraestructura de inteligencia artificial de Microsoft, todavía necesita pasar por el proceso desde la fabricación de chips, la integración del sistema hasta la implementación a gran escala. Microsoft planea comenzar a ponerlo en producción en 2027 y expandir gradualmente la escala de implementación. Para entonces, la capacidad de producción real del chip, la estabilidad del sistema, la adaptación del software y la integración con los centros de datos existentes afectarán su alcance de aplicación final.
En general, el lanzamiento de Maia 300 muestra que Microsoft está elevando los chips de IA de proyectos de infraestructura auxiliar a un componente central de su propia estrategia de inteligencia artificial. Al utilizar los procesos avanzados, el diseño granular central y la optimización a nivel de sistema de TSMC para cargas de trabajo de inferencia, Microsoft espera mejorar las capacidades del servicio de IA que puede proporcionar por unidad de electricidad y reducir su dependencia de proveedores externos de GPU.
Si Microsoft puede ampliar la implementación de producción de Maia 300 según lo planeado en 2027 y lograr las mejoras de eficiencia esperadas en los negocios reales, se espera que esta serie de chips se convierta en una herramienta importante para controlar los costos de computación de IA y expandir la escala del servicio. Pero su competitividad a largo plazo depende en última instancia del rendimiento operativo real y de si Microsoft puede establecer un sistema de optimización colaborativo sostenido y eficaz entre hardware, modelos y software.
Comentarios