
Resumen:
El fundador de Linux, Linus Torvalds, está explorando más a fondo la aplicación de herramientas de programación de inteligencia artificial en el desarrollo del kernel. Después de desarrollar recientemente un parche de optimización del rendimiento del kernel de Linux con la ayuda de Claude Code de Anthropic, Torvalds utilizó un modelo de lenguaje grande (LLM) para analizar una parte del código del kernel que había sido difícil de entender durante mucho tiempo. No sólo confirmó una falla previamente reportada por el desarrollador, sino que también descubrió otras tres vulnerabilidades que habían estado inactivas durante más de diez años. Todos estos problemas están relacionados con la implementación de Associative Array en el kernel de Linux.
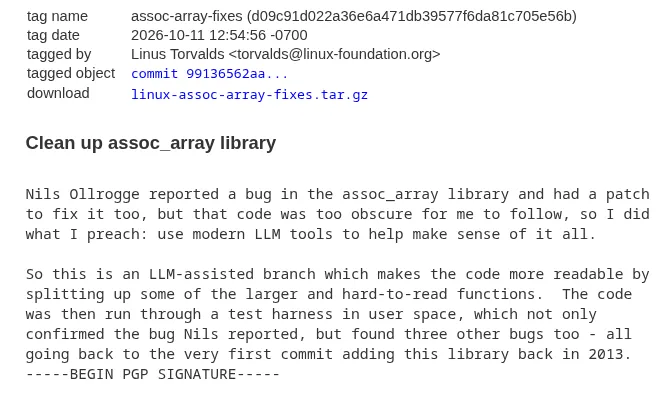
Según un informe publicado por Phoronix el 12 de octubre, Torvalds agregó recientemente una etiqueta Git llamada "assoc-array-fixes" a su repositorio de código del kernel de Linux para organizar y marcar una serie de reparaciones en el código de matriz asociativa. Este trabajo es independiente de su proyecto anterior de utilizar Claude Code para optimizar el rendimiento de lectura de archivos, pero ambos reflejan sus intentos de introducir herramientas de inteligencia artificial en el complejo proceso de desarrollo del kernel.
La causa de este trabajo fue que el desarrollador Nils Ollrogge informó de un error en la biblioteca de matrices asociativas y envió el parche de solución correspondiente. Sin embargo, cuando Torvalds revisó el parche, descubrió que la implementación del código relevante era demasiado oscura para comprender directamente su lógica específica, por lo que era imposible juzgar fácilmente si el parche resolvió correctamente el problema.
Ante esta situación, Torvalds optó por utilizar modelos de lenguaje modernos a gran escala para ayudar en el análisis. Escribió en la descripción de la etiqueta Git que esta vez adoptó el enfoque que había estado defendiendo antes, que consiste en utilizar herramientas LLM modernas para ayudar a comprender código complejo.
Luego, Torvalds organizó un conjunto de parches con modificaciones asistidas por IA para dividir algunas funciones grandes y difíciles de leer en una estructura más clara, haciendo que la lógica del código sea más fácil de entender y revisar. Vale la pena señalar que el objetivo de este trabajo no es simplemente permitir que la IA reescriba toda la implementación de la matriz asociativa, sino primero mejorar la legibilidad del código existente y luego verificar mediante pruebas si su comportamiento es el esperado.
Después de completar la modificación, el código relevante también se colocó en el marco de prueba del espacio de usuario para su ejecución. Las pruebas no sólo confirmaron que el error informado originalmente por Olrog estaba presente, sino que también descubrieron tres problemas adicionales.
Aún más preocupante es que estos fallos no son problemas nuevos introducidos recientemente. Según Torvalds, las tres vulnerabilidades adicionales descubiertas se remontan a 2013, cuando la biblioteca de matriz asociativa se introdujo por primera vez en el kernel de Linux. En otras palabras, han estado acechando en el código durante más de una década, sin haber sido completamente detectados por las pruebas pertinentes.
La matriz asociativa en el kernel de Linux es una estructura de datos utilizada para organizar y recuperar datos por valor clave. A diferencia de las matrices ordinarias que acceden a elementos a través de subíndices enteros, las matrices asociativas pueden encontrar datos correspondientes en función de claves específicas, por lo que son adecuadas para escenarios que requieren indexación y gestión flexible de objetos.
La implementación de matriz asociativa en el kernel de Linux satisface las necesidades de administración de datos dentro del kernel. Debido a que el código del kernel debe ejecutarse bajo estrictos requisitos de rendimiento, seguridad de la memoria y acceso simultáneo, la implementación de dichos componentes básicos suele ser más compleja que un código similar en aplicaciones comunes. Incluso si una función aparentemente solo realiza la inserción, eliminación o búsqueda de datos, puede implicar un ajuste de la estructura del árbol, la gestión del ciclo de vida del nodo y varias condiciones límite.
La falta de una estructura clara en este tipo de código hace que sea más difícil para los mantenedores comprender su comportamiento. Los desarrolladores no solo necesitan confirmar la lógica operativa en circunstancias normales, sino que también deben analizar entradas anormales, estados especiales de la estructura de datos y problemas que pueden ocurrir cuando se realizan múltiples operaciones continuamente.
A medida que el código continúa evolucionando, los defectos que no se activan fácilmente en las primeras implementaciones pueden permanecer durante mucho tiempo. Especialmente en estructuras de datos complejas, algunos errores solo quedarán expuestos en secuencias de operación específicas o estados estructurales especiales, y es posible que las pruebas ordinarias no necesariamente cubran todas las situaciones.
La idea adoptada en este trabajo asistido por IA es dividir primero funciones grandes que son difíciles de entender en partes que sean más fáciles de analizar y luego verificar la lógica relevante a través de un programa de prueba independiente. Una estructura de código más clara ayuda a los desarrolladores a identificar la relación entre diferentes operaciones y también facilita que las herramientas de prueba creen condiciones de verificación para comportamientos específicos.
Sin embargo, las tres vulnerabilidades descubiertas esta vez no pueden atribuirse simplemente a la capacidad de la IA para comprender programas más allá de los humanos. Más precisamente, la refactorización de código asistida por IA, las revisiones de los desarrolladores y los marcos de prueba funcionan juntos. Los modelos de lenguaje grandes pueden ayudar a organizar la lógica del código e identificar problemas potenciales, pero en última instancia aún es necesario confirmar si los defectos son reales mediante la ejecución real y pruebas repetibles.
Lo especial de este caso es que la IA no solo participó en el análisis del código, sino que también ayudó a Torvalds a resolver las barreras de comprensión durante el proceso de revisión del parche. Para los desarrolladores que mantienen grandes proyectos de código abierto, este puede ser un método de trabajo de valor práctico: cuando el código es demasiado complejo y es difícil para los mantenedores juzgar rápidamente si el plan de reparación es correcto, se puede utilizar la IA para ayudar a ordenar la estructura del código, y luego las conclusiones se pueden verificar mediante pruebas y revisión manual.
Actualmente, este conjunto de correcciones para matrices asociativas aún no se ha fusionado en la línea principal del kernel de Linux. Según los informes de Phoronix, se espera que el trabajo relacionado avance aún más durante la próxima ventana de fusión de Linux 7.4, pero si la fusión final aún dependerá de los resultados de las revisiones y pruebas de código posteriores.
Vale la pena señalar que esta no es la primera vez que Torvalds ha demostrado públicamente recientemente el uso de IA en el desarrollo del kernel de Linux.
Anteriormente, utilizó Claude Code para realizar otro trabajo de optimización del kernel. El objetivo era resolver el problema de competencia causado por la operación de conteo de referencias de páginas de memoria cuando varios subprocesos leen el mismo archivo al mismo tiempo. El parche relevante intenta reducir las operaciones innecesarias de recuento de referencias ajustando la ruta de lectura del archivo, mejorando así el rendimiento de lectura bajo cargas de trabajo específicas.
En ese trabajo, AI participó en la redacción inicial del código, el desarrollo del programa de prueba, la revisión del código y la redacción de documentos de notas de parche. Torvalds es responsable de determinar las direcciones de optimización, supervisar el proceso de desarrollo y realizar mediciones de rendimiento en su propia computadora.
Los objetivos técnicos de las dos tareas son diferentes, pero incorporan un modelo de desarrollo similar: los ingenieros familiarizados con el kernel determinan el problema, luego usan IA para ayudar a comprender implementaciones complejas, escribir o ajustar código y, finalmente, verificar los resultados mediante pruebas.
Este modelo puede ser particularmente valioso para proyectos de código abierto con ciclos de mantenimiento largos y a gran escala como Linux. El código del kernel ha seguido evolucionando durante décadas y contiene un extenso historial de implementación y complejos requisitos de compatibilidad. Incluso los mantenedores experimentados no siempre pueden estar familiarizados con todos los detalles de cada subsistema.
La revisión de código tradicional depende principalmente de que los desarrolladores lean el código, analicen la lógica y diseñen pruebas. Las herramientas de inteligencia artificial tienen la oportunidad de ayudar a los mantenedores a clasificar código desconocido más rápido, explicar la relación entre funciones, proponer posibles condiciones límite y ayudar a generar casos de prueba. No reemplazan la revisión profesional, pero se espera que reduzcan el tiempo que implica comprender código complejo.
Al mismo tiempo, el código generado por IA también tiene limitaciones. Los modelos de lenguaje grandes pueden malinterpretar flujos de control complejos, ignorar condiciones de contorno raras o proponer modificaciones que parecen razonables pero que en realidad no garantizan la corrección. Para los núcleos del sistema operativo, estos problemas son particularmente importantes porque los errores de código pueden afectar la estabilidad del sistema, la seguridad de la memoria e incluso el funcionamiento confiable de todo el sistema.
Por lo tanto, la participación de la IA en el desarrollo del kernel no significa que se puedan relajar los requisitos de revisión. En cambio, la refactorización de código, las pruebas automatizadas, la revisión de parches y la verificación real siguen siendo clave para garantizar la calidad de las modificaciones. El proyecto de matriz asociativa pudo descubrir problemas de larga data, lo que demuestra que las herramientas de inteligencia artificial deben combinarse con estrictos procesos de verificación de ingeniería para ser efectivas.
Torvalds siempre ha tenido una actitud pragmática hacia las herramientas de programación de IA. Reconoció el valor de la IA para ayudar en el proceso de desarrollo, pero no abogó por que los desarrolladores aceptaran el código generado por máquina sin revisarlo. Esta vez declaró públicamente que usa LLM para analizar el código, lo que demostró además que la IA se está convirtiendo en una opción auxiliar en la caja de herramientas de desarrollo del kernel.
En términos más generales, el incidente también arroja luz sobre una dificultad de larga data en el mantenimiento de grandes proyectos de software: el código no sólo debe ejecutarse correctamente, sino que también debe ser comprensible para los futuros desarrolladores. Para el software básico que se ha mantenido durante más de diez años o incluso décadas, la legibilidad en sí misma es un factor importante que afecta la confiabilidad.
Esta modificación mejora la estructura del código al dividir funciones complejas y utiliza pruebas para descubrir problemas previamente omitidos, lo que demuestra la estrecha conexión entre la legibilidad del código y la resolución de problemas de defectos. Cuando la lógica del programa es más clara, es más fácil para los desarrolladores identificar posibles rutas de error y crear pruebas que cubran comportamientos relevantes.
Si este conjunto de parches finalmente ingresa a la línea principal de Linux, su importancia no solo solucionará los cuatro problemas identificados, sino que también proporcionará una base de código más clara para el mantenimiento posterior.
A medida que las herramientas de programación de IA sigan desarrollándose, es posible que en el futuro haya más casos similares en grandes proyectos de código abierto. Sin embargo, para el software básico clave, como el kernel de Linux, lo que realmente determina si el desarrollo asistido por IA puede obtener reconocimiento a largo plazo es si el parche puede pasar una revisión estricta, si la prueba puede reproducir el problema y si el código final es lo suficientemente confiable.
Esta vez, la IA no reemplazó al fundador de Linux a la hora de tomar la decisión final, sino que le ayudó a comprender el código que originalmente era difícil de revisar y a descubrir defectos que habían estado ocultos durante muchos años. Para la ingeniería de software madura, esta puede ser una de las direcciones de aplicación más prácticas de la inteligencia artificial.
Comentarios