
Resumen:
El fundador del kernel de Linux, Linus Torvalds, está desarrollando una solución de optimización del rendimiento del kernel de Linux con la ayuda de la herramienta de programación de inteligencia artificial Claude Code.
Este trabajo apunta a un cuello de botella en el rendimiento del mecanismo de administración de memoria del kernel de Linux. El objetivo es reducir la competencia causada por el recuento de referencias de páginas de memoria cuando varios subprocesos leen el mismo archivo al mismo tiempo, mejorando así la eficiencia de lectura de archivos.
Torvalds no solo utilizó IA para ayudar a escribir código, sino que también utilizó esta herramienta para escribir programas de prueba, realizar revisiones de código y redactar notas de parches relevantes.
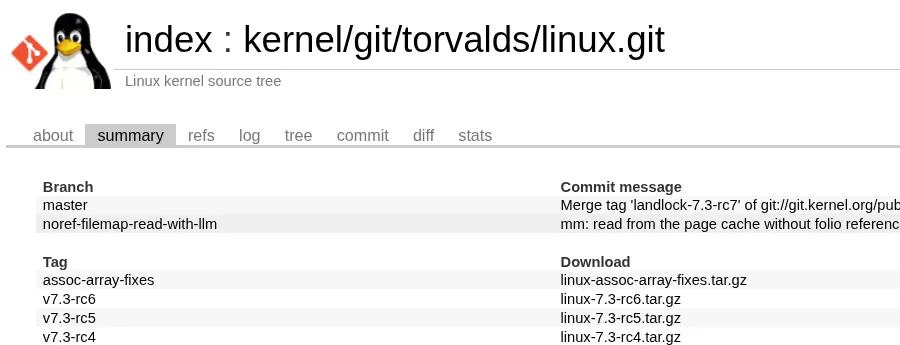
Mientras esperaba el lanzamiento de Linux 7.3-rc7, Torvalds actualizó recientemente su repositorio de código Git del kernel de Linux y descubrió que había aparecido una nueva rama inusual en el repositorio. A diferencia de su práctica habitual de mantener la rama principal, esta rama llamada "noref-filemap-read-with-llm" se dedica a desarrollar una serie de parches de mejora del kernel. Como se puede ver en el LLM en el nombre de la sucursal, este trabajo está relacionado con la programación asistida por modelos de lenguajes grandes.
Más tarde, Torvalds dejó claro en las notas del parche correspondientes que este trabajo se completó bajo su dirección y con la ayuda de Claude Code. La IA no solo participó en la implementación del código, sino que también ayudó a escribir programas de prueba, realizar revisiones de código y redactar la versión inicial de la documentación de la serie de parches. Las mediciones de rendimiento relevantes se realizaron en la propia computadora de Torvalds.
Esta optimización apunta principalmente a un problema específico en la ruta de lectura de archivos del kernel de Linux. Cuando varios subprocesos leen pequeños fragmentos de datos del mismo archivo al mismo tiempo, pueden competir en torno al recuento de referencias de páginas de memoria en la caché de páginas del archivo, lo que hace que los subprocesos compitan entre sí por estructuras de datos relacionadas, limitando así el rendimiento de lectura.
Para comprender este problema, primero debe comprender cómo maneja el kernel de Linux la lectura de archivos.
Linux utilizará el caché de página (Page Cache) para guardar los datos del archivo leídos desde el dispositivo de almacenamiento. Cuando un programa accede nuevamente al contenido de un archivo que ha sido almacenado en caché en la memoria, el núcleo a menudo puede proporcionar los datos directamente desde la memoria sin tener que volver a visitar el disco u otro dispositivo de almacenamiento cada vez. Por lo tanto, el almacenamiento en caché de páginas es un mecanismo importante para que Linux mejore la eficiencia del acceso a archivos.
Para administrar estos datos almacenados en caché, el kernel necesita realizar un seguimiento del ciclo de vida de los objetos de memoria relacionados. El mecanismo de recuento de referencias en las implementaciones tradicionales puede ayudar al kernel a determinar si un objeto de memoria todavía está en uso y cuándo puede liberar de forma segura los recursos relacionados.
Sin embargo, cuando una gran cantidad de subprocesos acceden con frecuencia al mismo archivo, incluso si los datos que leen ya están en la memoria, las operaciones de recuento de referencias relacionadas aún pueden generar una sobrecarga de sincronización adicional. En un sistema de procesador de múltiples núcleos, si varios subprocesos actualizan continuamente el mismo valor de recuento compartido, pueden producirse problemas como un mayor tráfico de coherencia de caché y núcleos de procesador esperando unos a otros.
Para escenarios de un solo subproceso o de baja concurrencia, es posible que esta sobrecarga no sea perceptible. Pero en servidores, bases de datos, sistemas de compilación y otras cargas de trabajo altamente concurrentes que necesitan manejar una gran cantidad de solicitudes de lectura de archivos simultáneamente, las operaciones de sincronización recurrentes pueden convertirse gradualmente en un cuello de botella en el rendimiento.
La serie de parches que Torvalds está desarrollando están diseñados para reducir operaciones innecesarias de recuento de referencias. La idea central es ajustar la ruta de lectura del archivo para que el kernel pueda leer datos directamente desde el caché de la página bajo ciertas condiciones sin tener que realizar operaciones tradicionales de administración de referencias de folios para cada acceso relevante.
folio aquí es una de las abstracciones básicas utilizadas por el kernel de Linux para administrar un conjunto de páginas de memoria contiguas o asociadas. En los últimos años, el kernel de Linux ha utilizado gradualmente el mecanismo de folio para reemplazar algunos de los antiguos métodos de administración de una sola página para manejar las tareas de administración de memoria de manera más eficiente. Por lo tanto, cómo reducir la sobrecarga causada por el recuento de referencias de folios se ha convertido en una tarea importante en la optimización del rendimiento del kernel.
Desde una perspectiva técnica, este tipo de optimización no elimina simplemente el recuento de referencias. El kernel aún debe garantizar que los objetos de memoria no se liberen prematuramente mientras se accede a ellos, y no debe introducir corrupción de datos o problemas de seguridad de la memoria al reducir las operaciones de sincronización. Por lo tanto, los parches deben lograr un equilibrio entre corrección, seguridad de acceso concurrente y rendimiento.
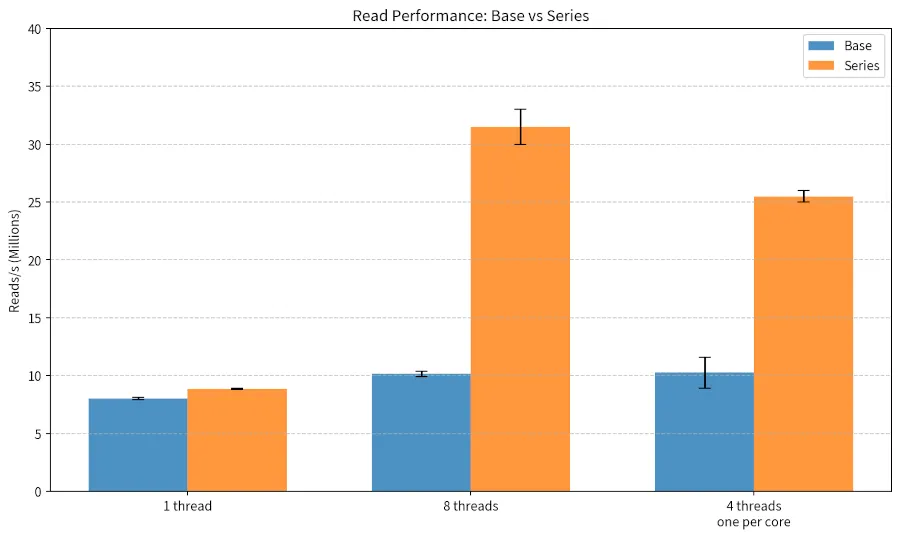
Esta optimización dio como resultado cambios de rendimiento bastante significativos bajo la carga de trabajo objetivo. La prueba está dirigida principalmente al escenario en el que varios subprocesos leen pequeños fragmentos de datos del mismo archivo al mismo tiempo, lo que corresponde al problema de competencia que el parche intenta resolver.
Sin embargo, estos resultados deben entenderse como rendimiento bajo condiciones de prueba específicas, no como que todas las operaciones de archivos en Linux recibirán la misma mejora. Los beneficios reales dependen de los patrones de acceso de su aplicación, la cantidad de subprocesos, el tamaño del archivo, el dispositivo de almacenamiento, la configuración de la memoria y otros factores del sistema. Los efectos de la optimización pueden estar limitados para cargas de trabajo que no implican los mismos problemas de contención.
Actualmente, estos parches todavía están almacenados en la rama personal de Git de Torvalds y no se puede concluir que hayan ingresado oficialmente al kernel principal de Linux. Es necesario seguir observando si se fusionará en el futuro y qué método de implementación se adoptará al final.
De acuerdo con el ritmo de desarrollo actual, esta serie de parches puede entrar en la etapa de discusión o revisión adicional durante la próxima ventana de fusión de Linux 7.4, pero si se puede fusionar en última instancia todavía depende de la revisión del código, los resultados de las pruebas y el criterio del responsable.
Vale la pena señalar que el uso de Claude Code por parte de Torvalds no es su primer intento de utilizar inteligencia artificial para manejar el trabajo de desarrollo relacionado con Linux.
Anteriormente, habló sobre el uso de la depuración del kernel asistida por IA y probó herramientas de programación de IA como Google Antigravity fuera del kernel de Linux. Para Torvalds, la IA no se trata de reemplazar a los desarrolladores como tomadores de decisiones independientes, sino más bien de una herramienta de desarrollo que puede usarse con objetivos claros y supervisión humana.
Desde este año, las herramientas de programación de inteligencia artificial están entrando gradualmente en el proceso de desarrollo de software de código abierto. Cada vez más desarrolladores aprovechan grandes modelos de lenguaje para analizar código, localizar errores, escribir pruebas y generar parches iniciales. La comunidad del kernel de Linux también está viendo un número cada vez mayor de códigos e informes de errores asistidos por IA.
Esta tendencia trae consigo oportunidades y desafíos. Por un lado, la IA puede ayudar a los desarrolladores experimentados a explorar rutas de código complejas más rápidamente, generar ideas de optimización y reducir el tiempo necesario para escribir código repetitivo. Por otro lado, una gran cantidad de parches e informes de errores generados automáticamente también aumentan la carga de revisión de los mantenedores, y algunos de los envíos pueden tener problemas de baja calidad, envíos duplicados o falta de valor real.
Torvalds ha declarado públicamente antes que cree que la IA es una herramienta útil, pero la comunidad del kernel necesita lidiar con la presión laboral causada por el rápido aumento del contenido generado por IA. No aboga por rechazar el código sólo porque utiliza IA, sino que presta más atención a la calidad, la corrección y el efecto real del código final.
El proyecto de optimización del kernel en el que participó Claude Code esta vez refleja un método de aplicación más específico de desarrollo asistido por IA: los desarrolladores que están familiarizados con los mecanismos internos del kernel identifican problemas, proponen direcciones de optimización y supervisan la implementación, y luego verifican los resultados mediante pruebas y revisión del código.
A diferencia de depender únicamente de la IA para generar automáticamente todo el proyecto de software, el desarrollo del kernel de Linux implica complejos mecanismos de concurrencia, requisitos de seguridad de la memoria y comportamiento del hardware. Cualquier modificación aparentemente sencilla puede afectar a una gran cantidad de aplicaciones y diferentes plataformas de hardware. Por lo tanto, incluso si la IA puede ayudar a generar código, los desarrolladores aún deben comprender cómo funciona y asumir la responsabilidad de la implementación final.
Si este conjunto de parches finalmente pasa la revisión y entra en la línea principal de Linux, se convertirá en otro caso de desarrollo asistido por IA que participa en la optimización del software del sistema subyacente. Su valor radica no sólo en las mejoras de rendimiento que se pueden obtener en escenarios específicos, sino también en demostrar cómo los modelos de lenguaje grandes pueden ayudar a los ingenieros experimentados a analizar y mejorar sistemas complejos.
A medida que las herramientas de programación de IA sigan desarrollándose, es posible que en el futuro aparezcan más trabajos similares en el kernel de Linux y otros grandes proyectos de código abierto. Sin embargo, lo que determinará si estos logros realmente se pueden implementar seguirá siendo una verificación técnica estricta, una revisión de la comunidad y requisitos a largo plazo para la estabilidad del sistema.
Comentarios