Resumen:
Es una locura. ¡En sólo dos días aparecieron 4 nuevos modelos! En la vanguardia, xAI de Lao Ma acaba de terminar de publicar Grok 4.7. Inmediatamente después, OpenAI abandonó repentinamente GPT-6 Sol y Luna, y el precio se redujo a la mitad. El mismo día, Anthropic también puso sobre la mesa el Claude Opus 5.5, un 40% más barato que la generación anterior. El 22 de septiembre, una imagen animada se volvió viral en X, con casi un millón de visitas.
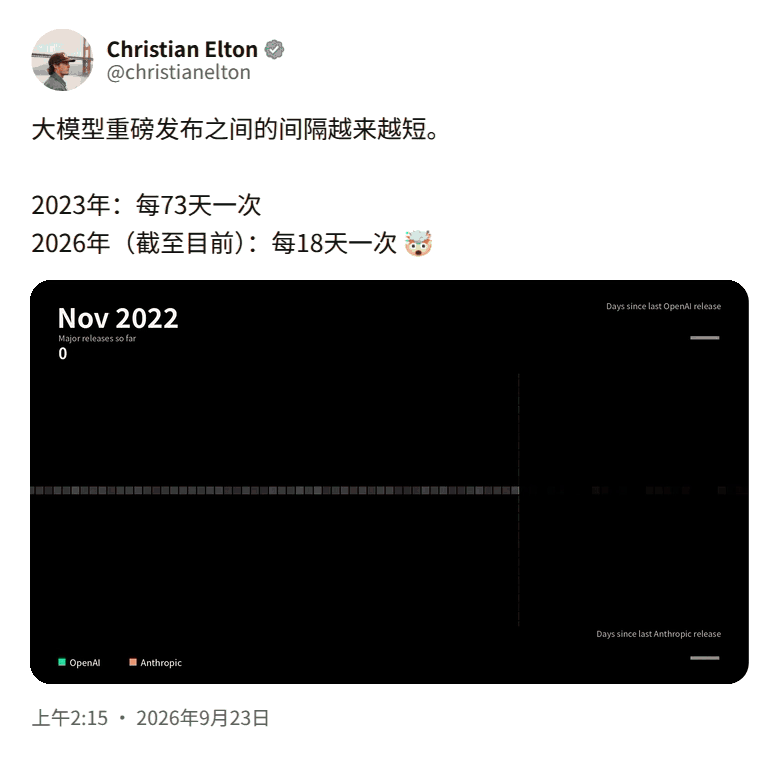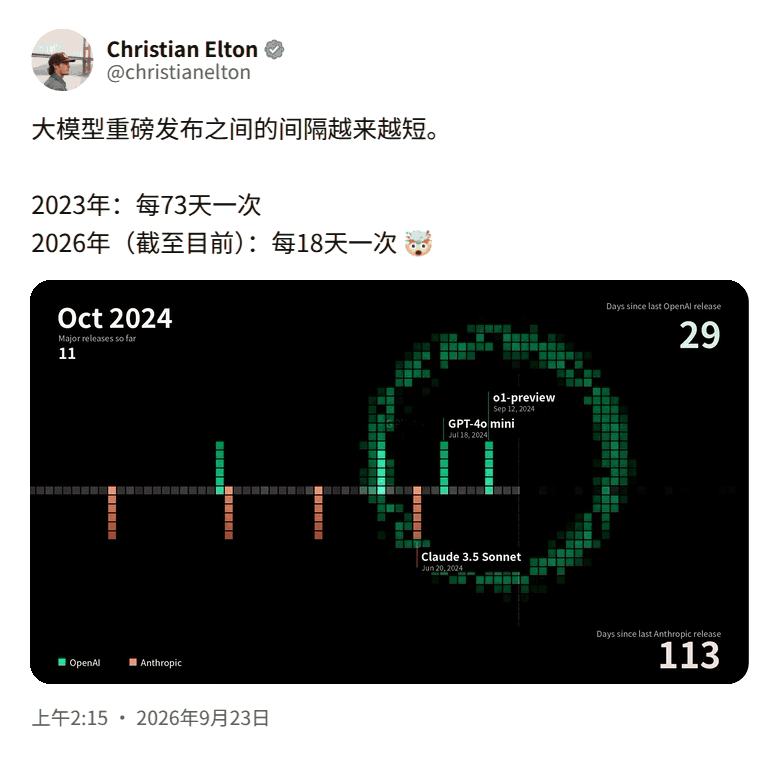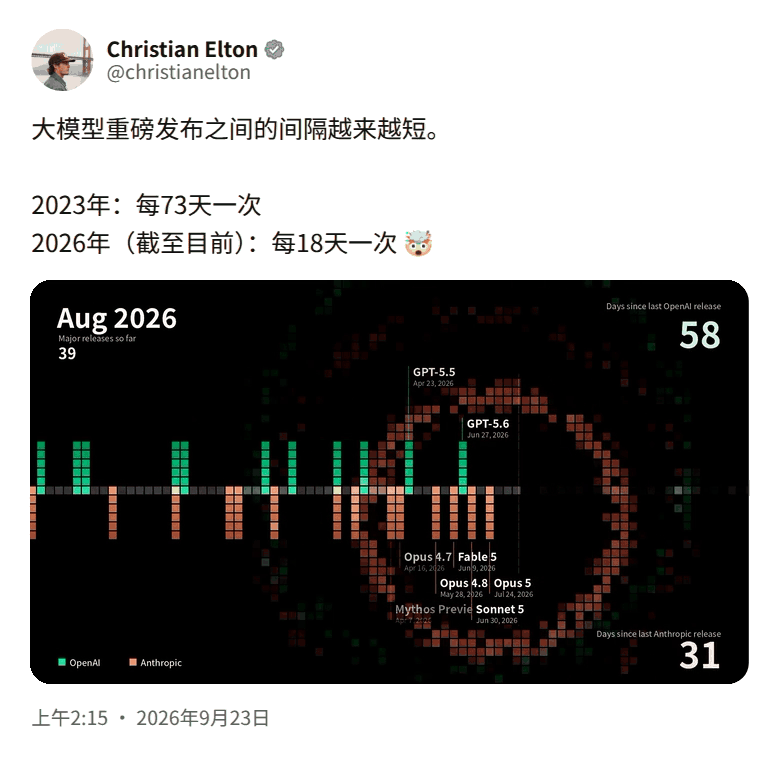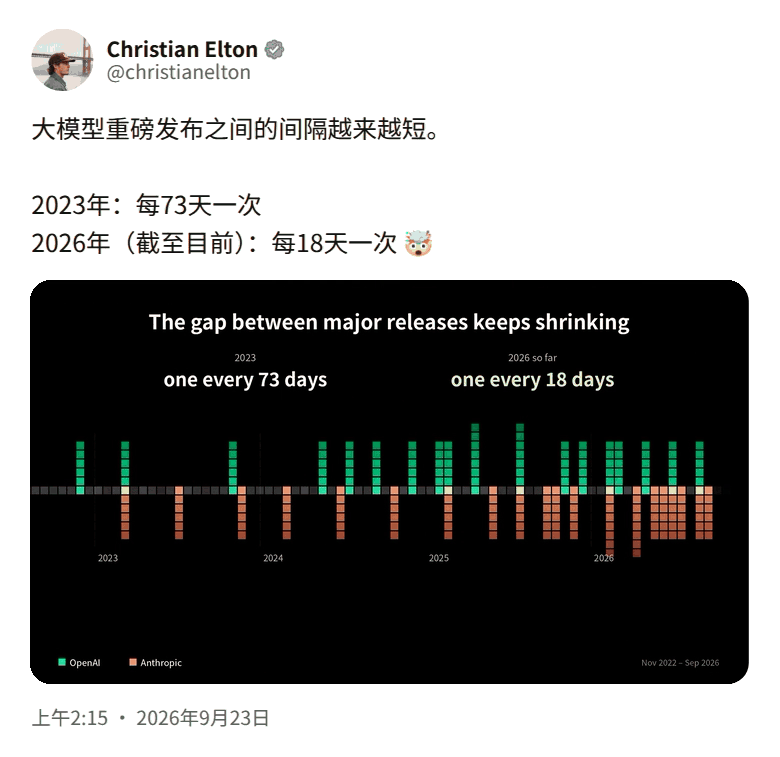
En 2023, los modelos grandes se actualizarán cada 73 días y, en 2026, se actualizarán cada 18 días.
Desde el lanzamiento de ChatGPT, OpenAI y Anthropic han bombardeado 42 modelos de gran éxito (44, incluidos GPT-6 Sol y Luna, lanzados ese día).
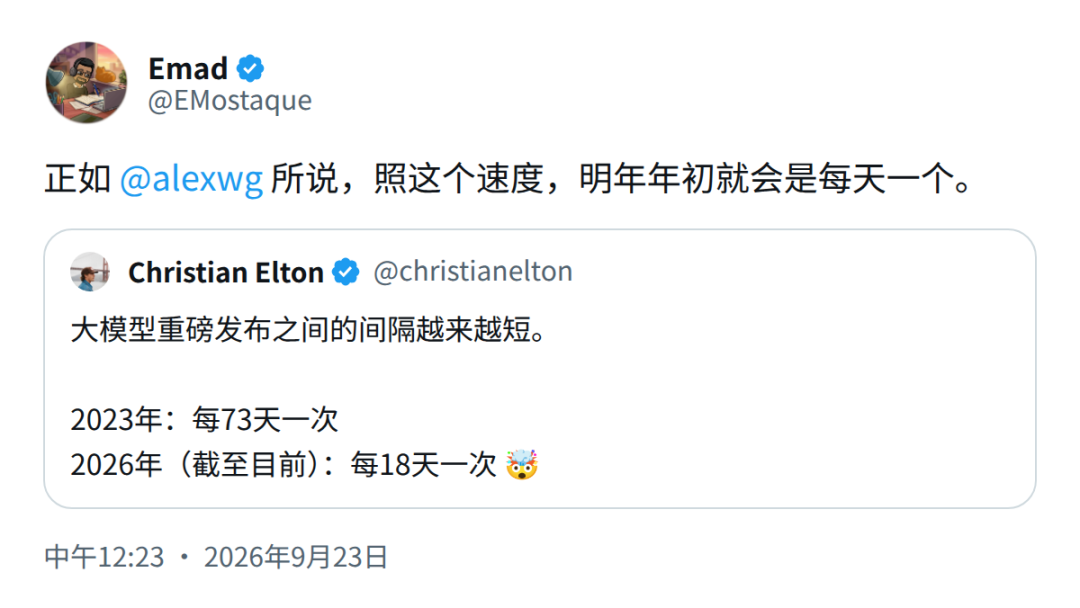
Unas horas más tarde, el fundador de Stability AI, Emad Mostaque, retuiteó la imagen y añadió una profecía.
"Como dijo Alex, a este ritmo, habrá uno por día a principios del próximo año."
Dos gigantes, implementen una "actualización semestral"
De hecho, el número de "actualizaciones cada 18 días" es bastante conservador, porque solo cuenta OpenAI y Anthropic.
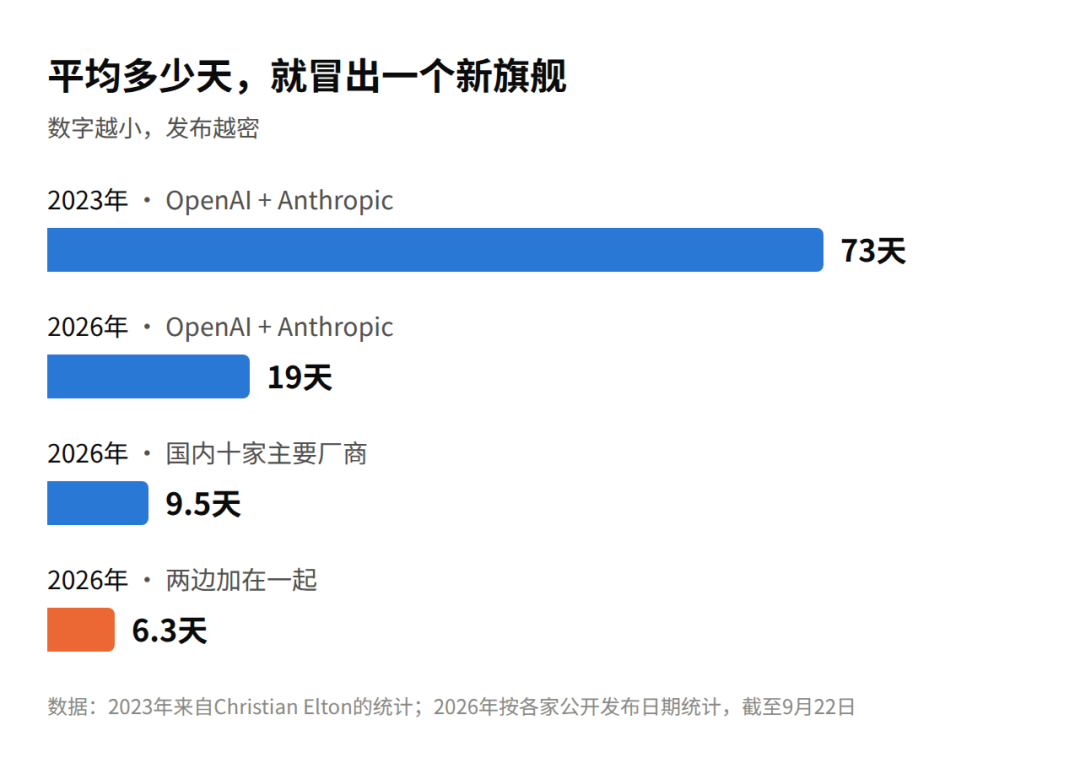
Desde principios de este año hasta el 22 de septiembre, Anthropic lanzó 8 modelos emblemáticos y OpenAI lanzó 6. Los 14 modelos se distribuyeron en 265 días, con un promedio de 19 días por modelo.
Durante el mismo período de tiempo, los diez principales fabricantes nacionales de modelos grandes lanzaron al menos 28 modelos emblemáticos más, un promedio de más de uno cada 9 días.
Hubo momentos en los que se lanzaron juntos. En la semana previa al Festival de Primavera, cuatro empresas lanzaron nuevos buques insignia uno tras otro; del 20 al 24 de abril, cuatro empresas más se turnaron en los cinco días.
Tomando ambas partes en conjunto, un nuevo buque insignia surge en un promedio de más de 6 días, lo que no está lejos del "uno por día" mencionado por Emad.
El aumento de velocidad de Anthropic es visible a simple vista.
En la primera mitad del año, se tardó una media de 46 días en lanzar un modelo, y en la segunda mitad del año, 26 días. Opus 4.8 es el 28 de mayo, Opus 5 es el 24 de julio y Opus 5.5 es el 22 de septiembre.
OpenAI toma el camino de "retener el último movimiento y luego eliminarlo".
GPT-6 Astra acaba de hacer estallar toda la red el 3 de septiembre, y solo 19 días después, Sol y Luna hicieron lo mismo.
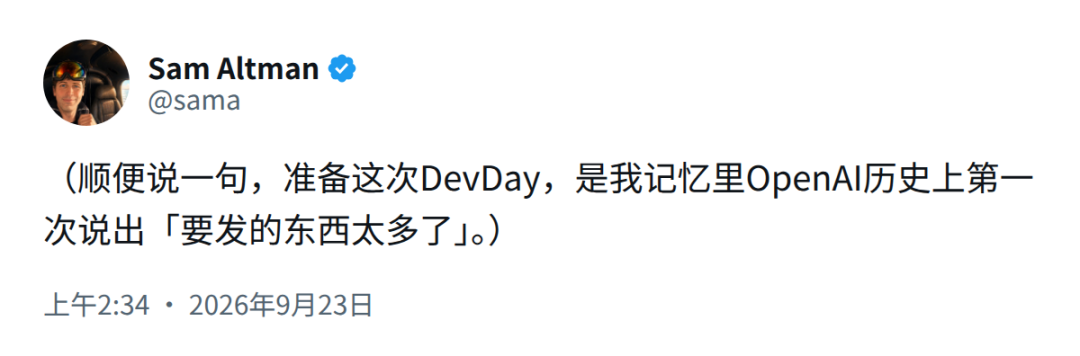
La próxima semana habrá una conferencia DevDay. Altman lamentó que esta es la primera vez en su memoria que OpenAI grita "hay demasiadas cosas por publicar" cuando se preparaba para una conferencia de prensa.
¿Por qué la publicación es cada vez más densa? Anthropic dio la respuesta en un informe. La IA ya está ayudando a crear la próxima generación de IA.
En febrero de este año, Claude podía liderar de forma independiente menos del 1% del trabajo de I+D de IA. Después de eso, mejoró casi todos los meses, alcanzando el 12% en mayo, el 22% en julio y el 26% en agosto.
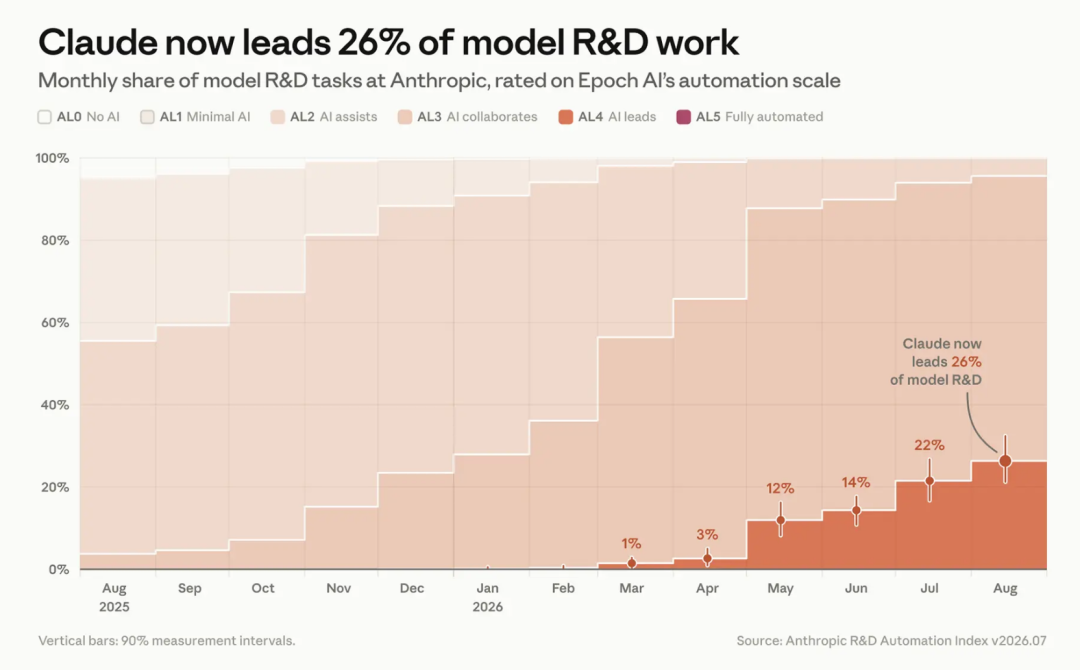
En OpenAI, a mediados de agosto, el número de días laborales invertidos por los agentes de IA ha sido 3,1 veces mayor que el de los investigadores humanos (basado en 8 horas por día).
En Anthropic, una cuarta parte del trabajo de creación de modelos ha sido confiado al propio Claude. Los próximos modelos vendrán uno tras otro.
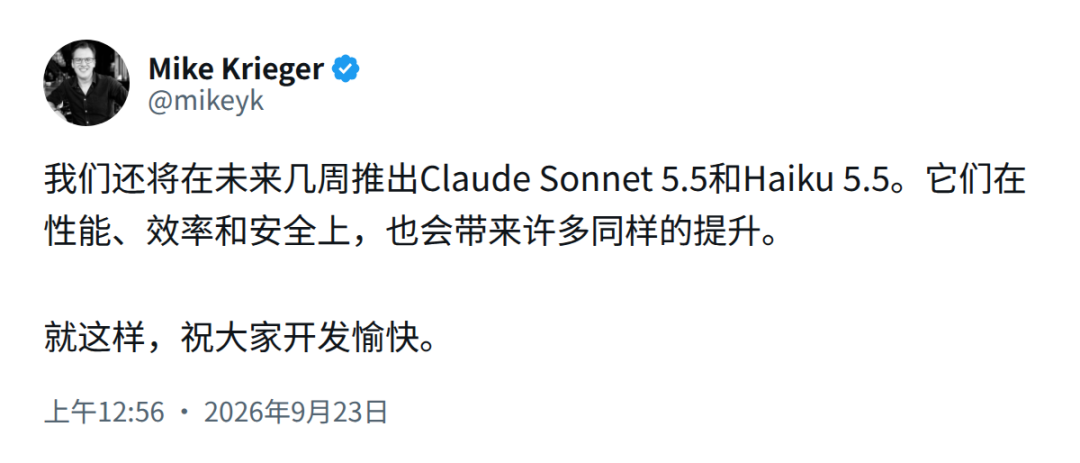
La cola ya ha llegado a la puerta. Mike Krieger de Anthropic ha revelado que Sonnet 5.5 y Haiku 5.5 llegarán en las próximas semanas.
Gemini 4 de Google inició "el entrenamiento previo más ambicioso hasta la fecha" ya en julio, y el mundo exterior generalmente apuesta a que será presentado a finales de año. Al menos dos empresas nacionales han anunciado oficialmente sus buques insignia de próxima generación y solo falta una fecha de lanzamiento.
La "metafísica" ganada con tanto esfuerzo
Será desechado inmediatamente después de dos meses
Cuanto más rápido se ejecuta el modelo grande, más embarazoso resulta para las personas que escriben el código.
Te quedaste despierto algunas noches a finales de julio y acabas de mover la aplicación a Opus 5. Cada parámetro se ha ajustado tan suavemente como la seda. Dos meses después, salió Opus 5.5 y felizmente cambió la interfaz: haga clic y algunas solicitudes informaron errores directamente.
Al consultar las recientes guías oficiales de palabras de estas dos empresas, descubrirá que transmiten el mismo hecho. Muchas de las indicaciones ancestrales que escribiste para el modelo de la generación anterior se han convertido en papel de desecho.
Lo primero es hacer la resta.
OpenAI establece claramente en la guía de Astra que las instrucciones de proceso que eran demasiado detalladas en el pasado ahora serán un obstáculo. Se pueden eliminar palabras como "lea el documento detenidamente antes de cambiar el código" y "recuerde ejecutar pruebas".
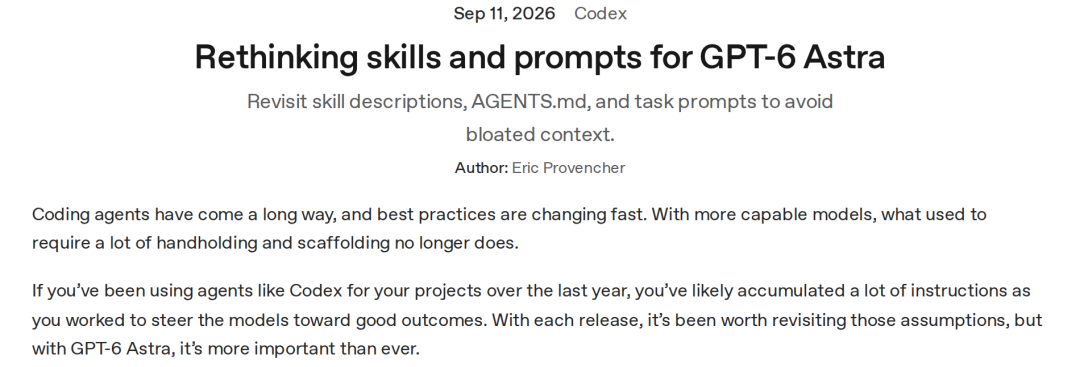
La guía de Anthropic también significa esto.
En el pasado, las palabras clave a menudo tenían que agregar la frase "Compruébalo después de que esté hecho", pero Opus 5 ya puede verificarlo por sí mismo. Si esta oración no se elimina, se verificará en exceso.
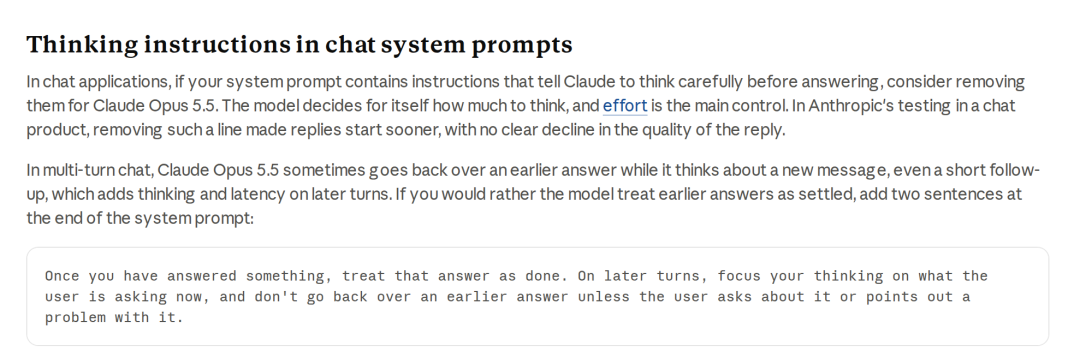
En Opus 5.5, se recomienda eliminar la frase PUA "piensa detenidamente antes de responder" en la escena del chat. Tras eliminarlo, la respuesta es más rápida y la calidad no ha bajado significativamente.
Después de eliminar los antiguos, debes agregar otros nuevos, porque cada generación tiene un temperamento nuevo.
A Opus 5.5 siempre le gusta volver atrás y pensar en preguntas que ya han sido respondidas durante múltiples rondas de diálogo, lo cual es un desperdicio de potencia informática. Se ha dado el parche oficial: "Lo que se ha respondido ya pasó".
Los parámetros y valores predeterminados también están cambiando silenciosamente.
En Opus 5.5, desactivar el modo de pensamiento informa directamente un error 400; sin escribir el parámetro de esfuerzo, la marcha predeterminada se reduce de alta a media y el costo y el efecto se mezclan en consecuencia.
En este sentido, la sugerencia oficial es volver a ejecutar la prueba de esfuerzo y no transferir directamente la configuración anterior del Opus 5.
Un conjunto de palabras clave más un conjunto de parámetros, cada generación tiene que quitar capas de piel. Si no se ha realizado el ajuste, la factura puede variar mucho.
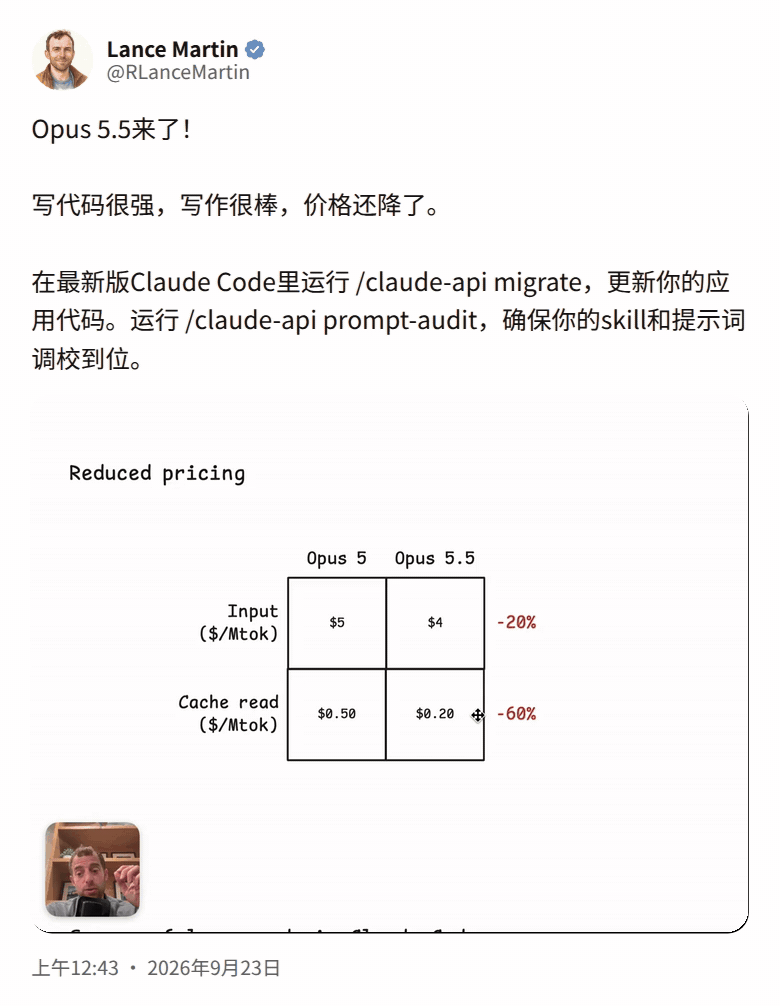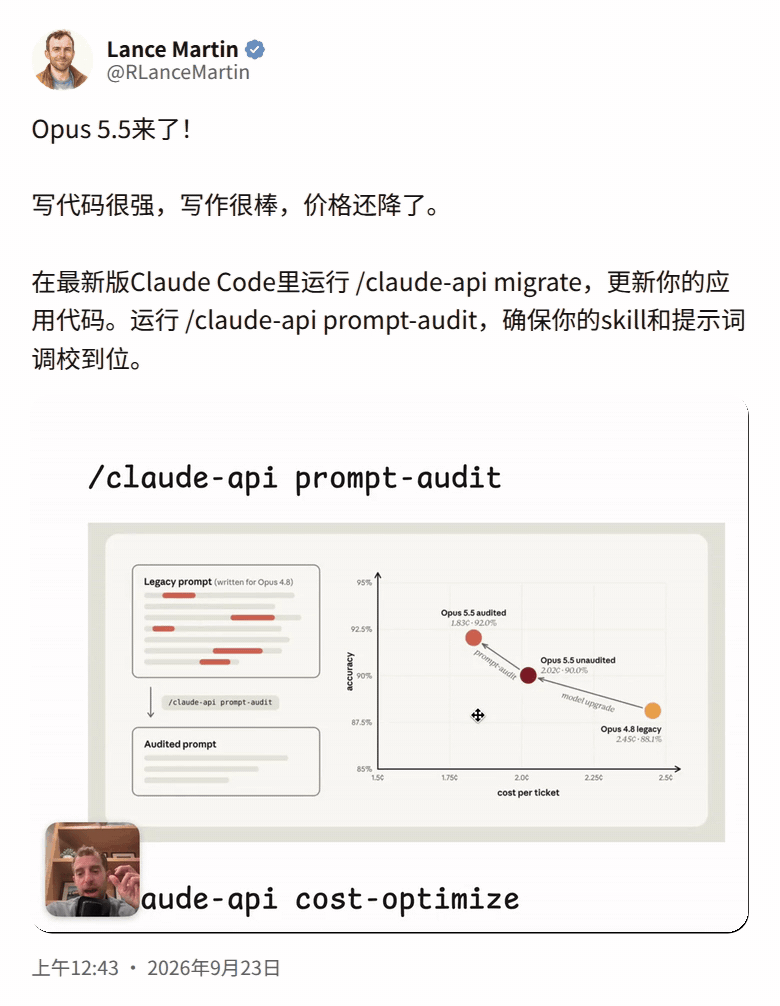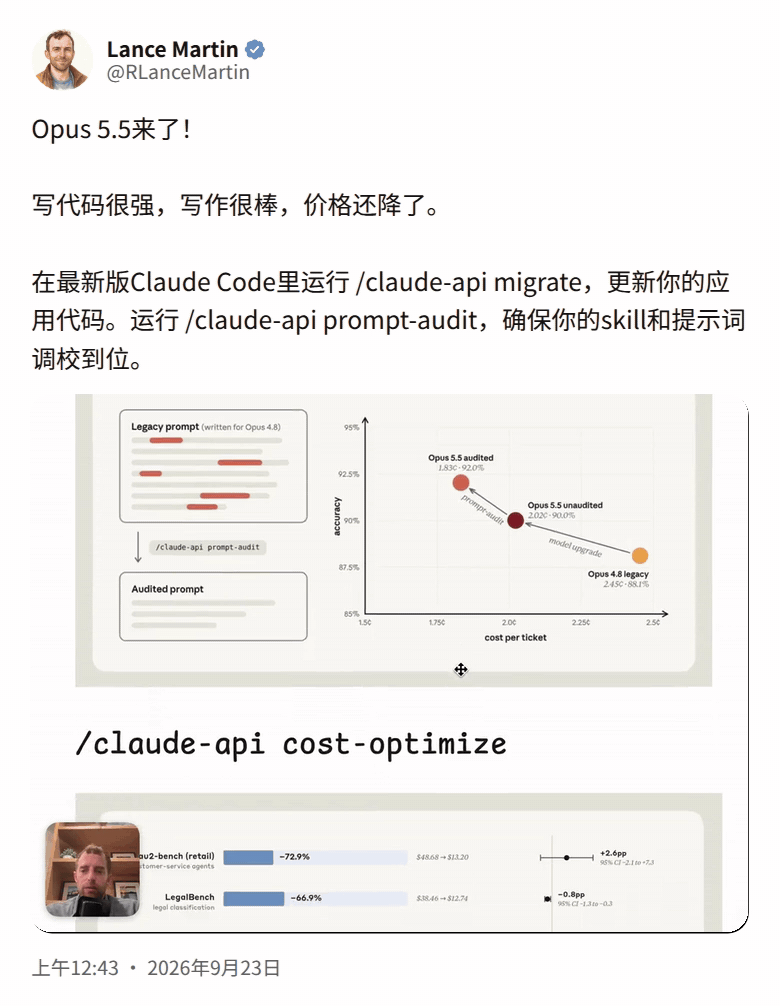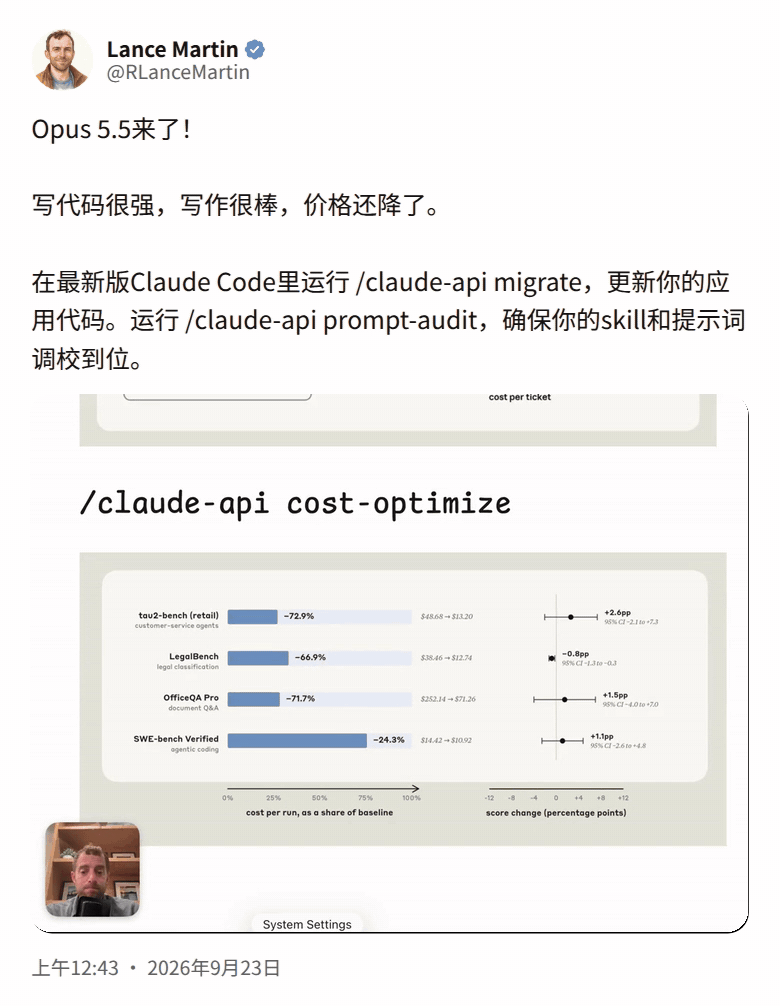
Lance Martin de Anthropic demostró en el vídeo que un viejo mensaje escrito para Opus 4.8 costaba 2,45 centavos por orden de trabajo, y costaba 2,02 centavos reemplazarlo directamente con Opus 5.5. Después de lavarlo nuevamente con las herramientas oficiales, la tasa de precisión aumentó al 92,0% y el costo se redujo a 1,83 centavos.
Además de esto, también se acorta la vida útil del modelo en sí.
OpenAI ha emitido 9 anuncios de obsolescencia este año, que involucran más de 40 modelos y funciones.
Entre ellos, GPT-5.5, que se lanzó recientemente el 23 de abril, se eliminará de ChatGPT y Codex el 14 de octubre y ha sobrevivido menos de medio año.
Incluso la propia plataforma de evaluación Evals de OpenAI cerrará a finales de noviembre.
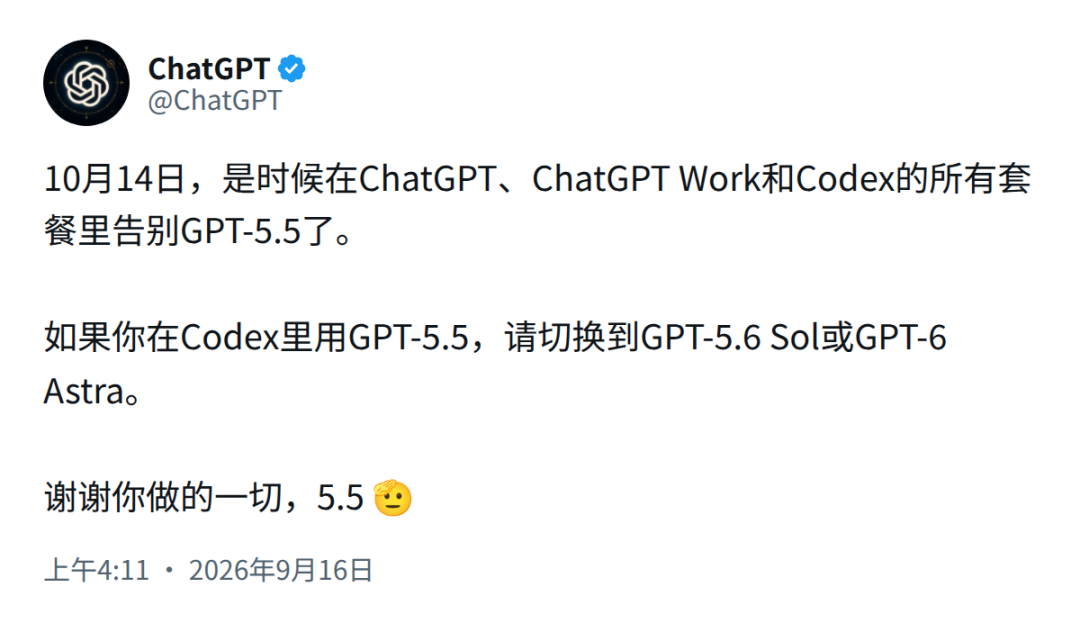
¿Cepillar la lista? En medio año se desarrolló un nuevo conjunto de preguntas de prueba
No importa si la gente no puede seguir el ritmo, ahora ni siquiera los “exámenes” son suficientes.
En marzo de este año, se lanzó ARC-AGI-3, que afirma especializarse en IA y evaluar el coeficiente intelectual sin memorizar preguntas. Gemini 3.1 Pro, que ocupaba el primer lugar en ese momento, solo obtuvo el 0,37%, mientras que los humanos obtuvieron el 100%.
El 3 de septiembre, GPT-6 Astra ingresó a la sala de examen, con una puntuación del 62,7 % en la prueba estándar y alcanzó directamente el 99,9 % cuando se utilizó un marco específico. En el 96% de los niveles, dio menos pasos que un humano.
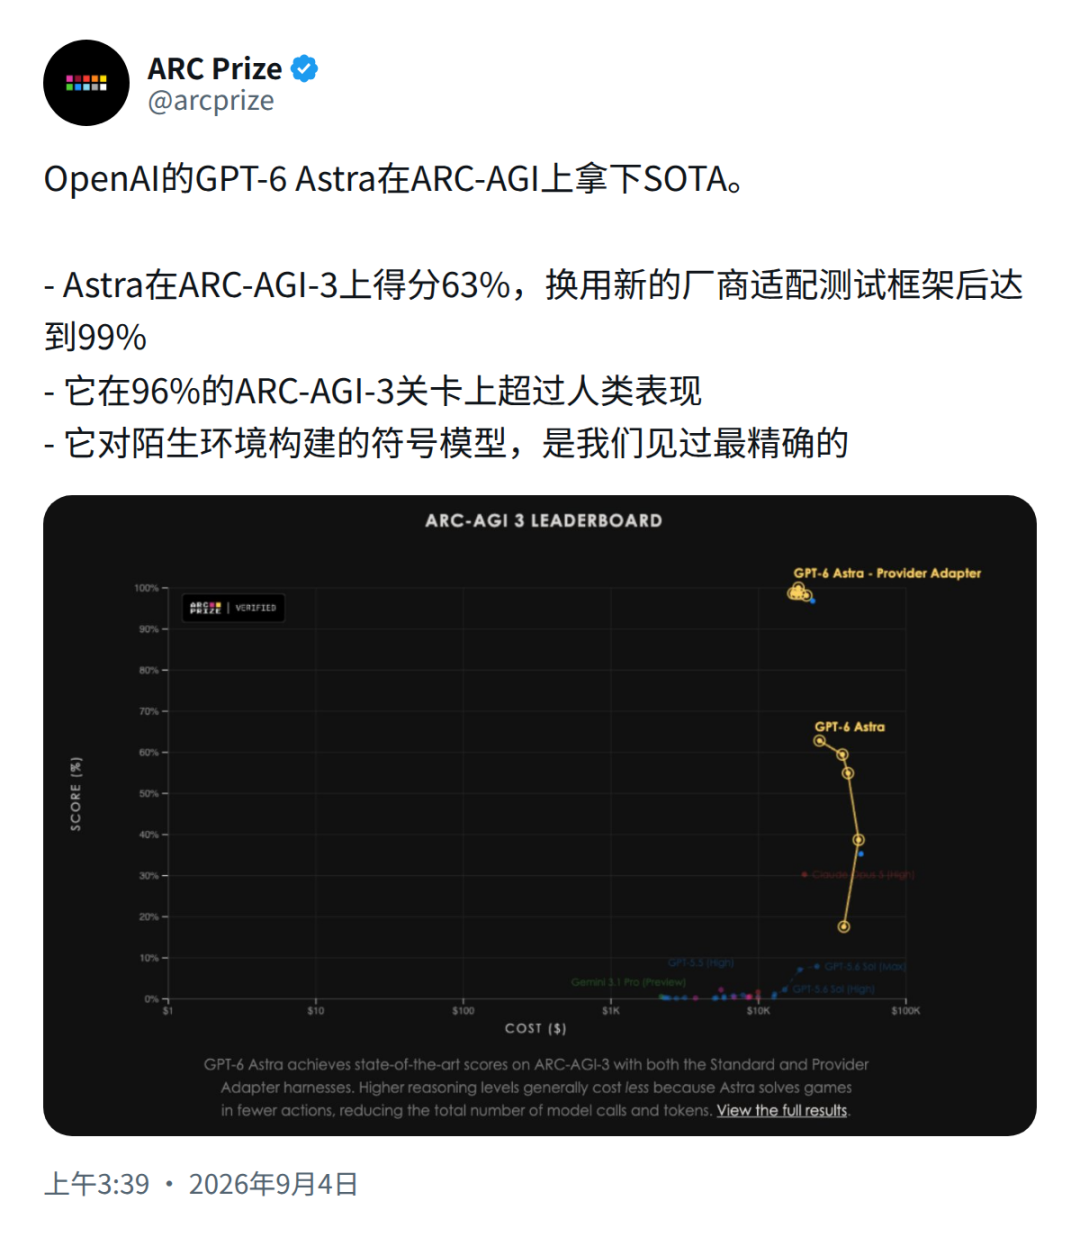
En medio año se desglosó un nuevo conjunto de preguntas de la prueba y los funcionarios de ARC han comenzado a pensar en cómo producir la próxima generación de evaluaciones.
En la lista de codificación (Next.js), Sol, Opus 5.5 y Fable 5.1 obtuvieron una puntuación del 97 %, empatados en el primer lugar; En la lista de redacción, Opus 5.5 Fault lidera el segundo lugar con 307 puntos.
Esta puntuación es el salto más grande en la historia de la lista. El blogger dijo que era escandaloso después de leerlo, ¡y casi pensó que había un error en su propio punto de referencia!
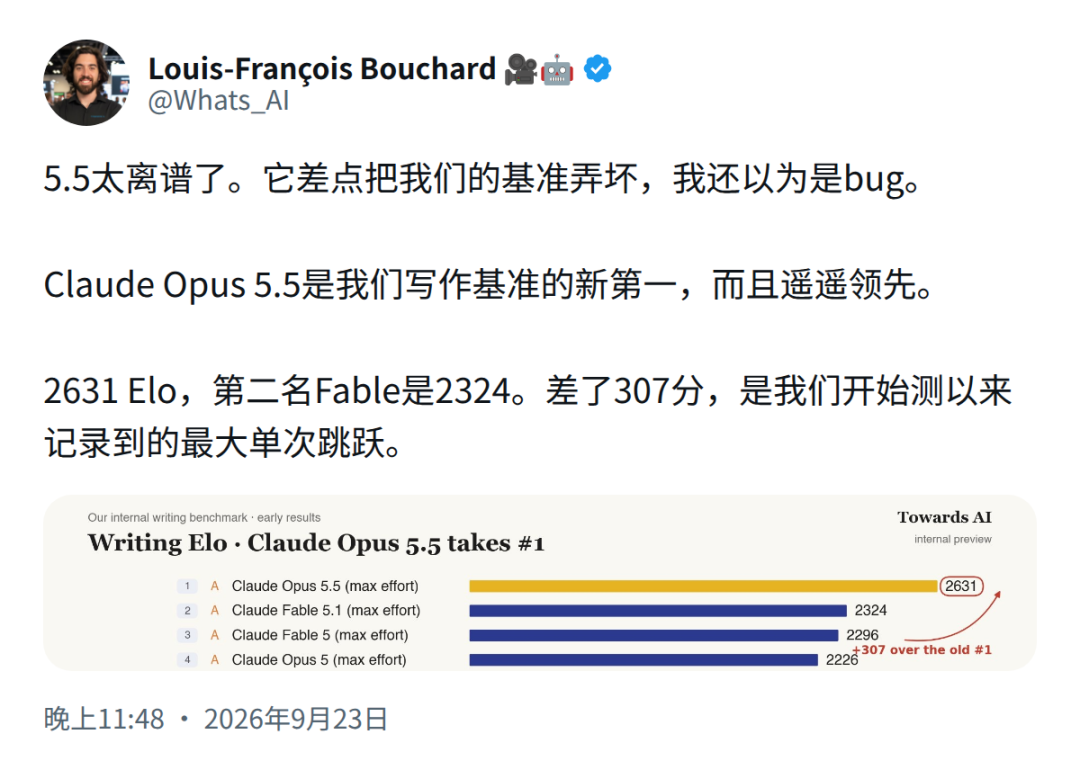
Cada vez que llega un nuevo modelo, los desarrolladores tienen que empezar el proceso de prueba de nuevo como Sísifo.
De acuerdo con el ritmo actual, si el próximo año realmente llega al punto de "una actualización por día", es posible que las palabras clave y los enlaces de agente que haya ajustado hoy no duren más de una semana.
Por primera vez, la velocidad de sustitución de modelos ha superado por completo la velocidad de adaptación de los humanos a él.
Los corredores más lentos hoy en día son en realidad aquellos que utilizan IA.
Comentarios